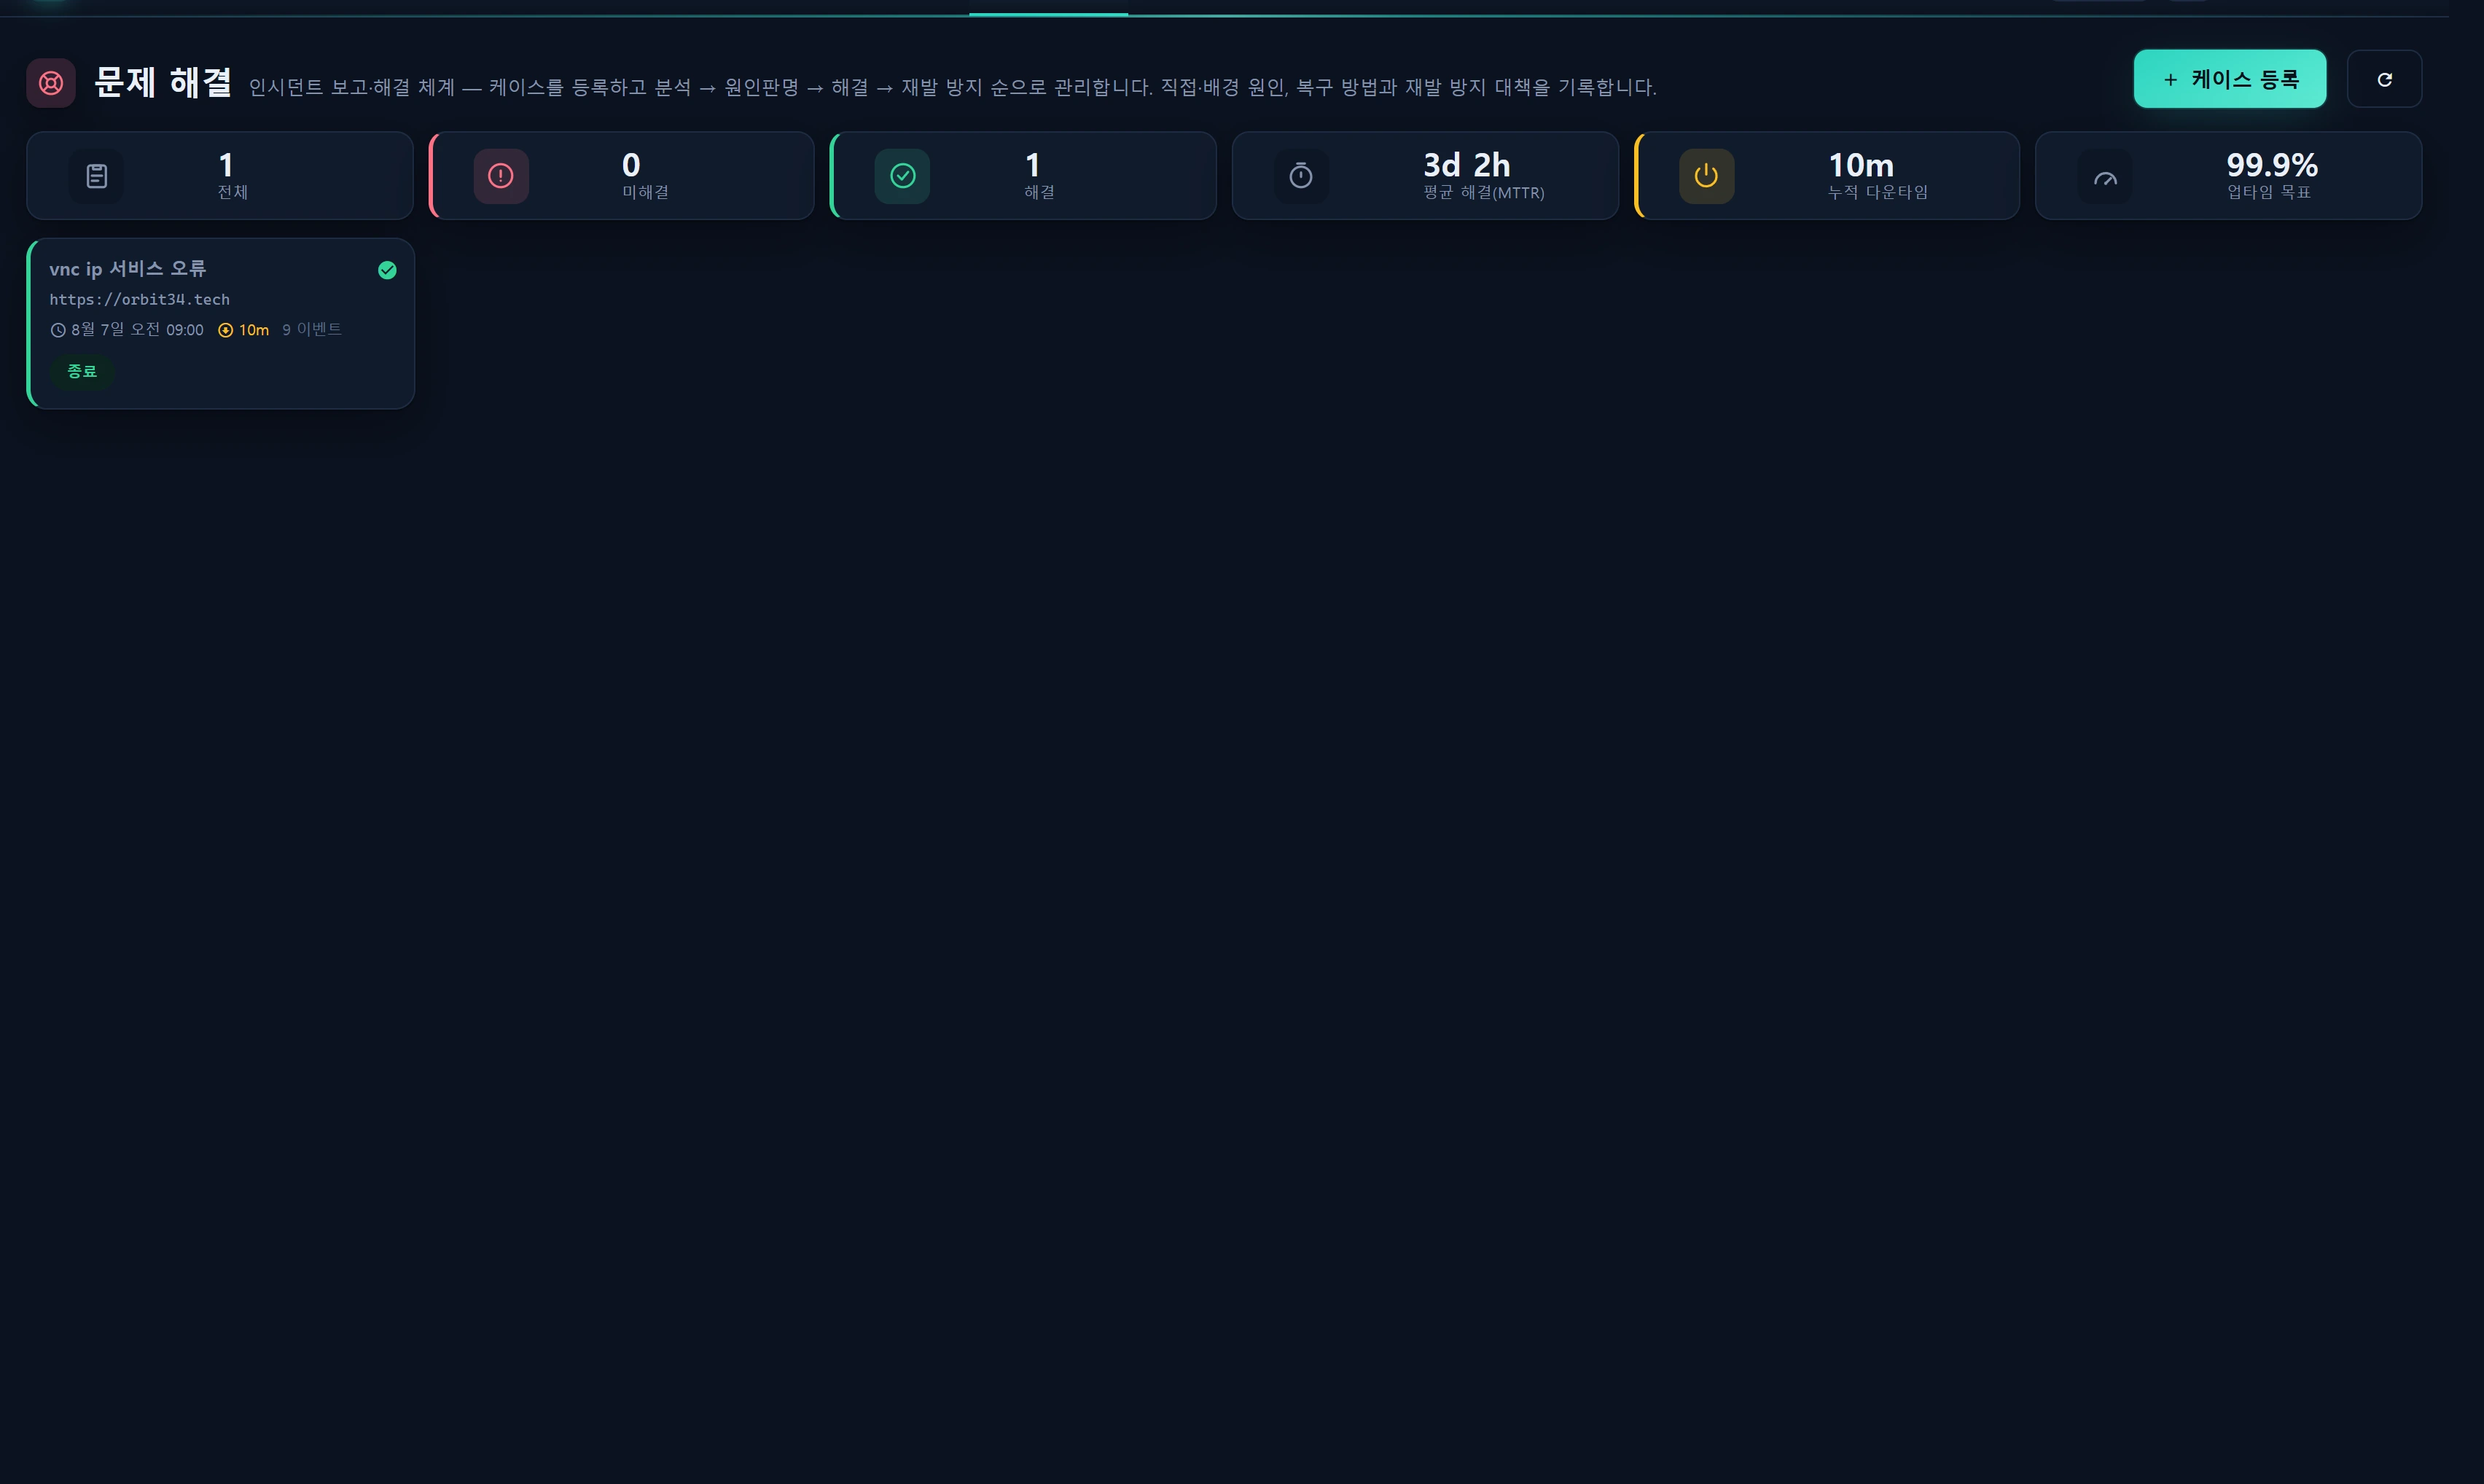
概要 — 何をする画面か
問題解決 は、サービス役割領域のインシデントケースのワークフローです。障害・エラー・性能低下を1つのケースとして登録し、ステータスのパイプライン 登録 → 調査中 → 原因特定 → 解決 → 終了 に沿って進めながら、各ステップで調査内容・原因・対処を記録します。事後検証(ポストモーテム)と再発防止策の台帳も兼ねます。
データはすべて infr_incident テーブル1つに保存され、この画面が扱うのは area='service' の行だけです。セキュリティ問題解決 画面は同じテーブルを area='security' で共有します — スキーマは同一で、ボードだけが分かれています。
各ケースには、正式な事後報告書に倣った4つの原因・対処フィールドがあります。
| フィールド | 意味 | 例 |
|---|---|---|
direct_cause |
障害を直接引き起こした表面的な要因 | mysql の接続数上限を超過(Too many connections) |
root_cause |
その表面的な原因を生んだ背景的な理由 | 5分周期の cron スクリプトが接続を返さない → リーク → 上限が枯渇 |
resolution |
障害中にサービスを復旧させた対処 | 接続の整理、プロセスの再起動、即時復旧のための上限引き上げ |
action_taken |
再発を防ぐための恒久対策 | MAX_USER_CONNECTIONS で専用アカウントを隔離、スクリプトを修正、監視警報を追加 |
この画面は、以前の「SLA & Uptime」メニューから改名されたものです(名前空間
sla→resolution)。稼働率目標の KPI(uptime_target)はそのまま維持されています。
どんなときに使うか
- 障害後のまとめ: サービスがダウンして復旧した後に、原因・対処・再発防止を再利用できる振り返りとして記録します。
- 再発の追跡: 同じエラーが繰り返し起きていないか、根本原因が実際に取り除かれたかを確認します。
- MTTR とダウンタイムの管理: 平均解決時間と累計ダウンタイムを指標として管理し、稼働率目標と比較します。
- 自動取り込みキューの処理: 外部アプリが Pulse/例外レポーター経由でエラーを送信すると、
source='pulse'のケースとしてここに入るため、担当者がトリアージして解決します。
画面構成
KPI ストリップ
上部の KPI は area='service' のケース全体から算出されます。
| KPI | 算出方法 |
|---|---|
合計(total) |
サービスケースの件数 |
対応中(active) |
open + investigating + cause_identified の合計 |
解決済み(resolved) |
resolved + closed の合計 |
MTTR(mttr_min) |
(解決時刻 − 発生時刻)の平均(分)。occurred_at と resolved_at の両方があるケースのみが対象 |
累計ダウンタイム(downtime_min) |
各ケースの downtime_min フィールドの単純合計(分) |
稼働率目標(uptime_target) |
運用ポリシーの sla_uptime_target(既定 99.9%) |
正確な MTTR を得るには、ケースに発生時刻(
occurred_at)を入力し、解決への遷移でresolved_atを自動的に記録させてください。発生時刻のないケースは MTTR の平均から除外されます。
ケースボード
ケースはカード/行として一覧表示され、次の優先順位でサーバー側(コントローラーで raw SQL を使わないよう PHP で)ソートされます。
- ステータス順位:
open→investigating→cause_identified→resolved→closed - 深刻度順位:
crit→warn→info - 新しい id が先
このため、対応中で・深刻で・新しいケースが上位に浮かび上がります。
各カードには、ソースバッジ(手動/Pulse/警報/外部機関/隔離/検知からの昇格)、深刻度、ステータス、プロジェクト名、発生時刻、ダウンタイム、イベント数が表示されます。
詳細モーダル
ケースを開くと、左側にレポート(概要・直接原因・根本原因・復旧措置・再発防止策)、右側にタイムライン(ステータス変更・ノート)が表示され、上部にパイプラインの遷移ボタンが並びます。
使い方
1) ケースを登録する
[Register case] → モーダルフォーム。作成時には source='manual'、area='service'、status='open' で保存され、detected_at はサーバー側で記録され(now())、タイムラインに created イベントが追加されます。
フィールドと入力制限:
| フィールド | 必須 | 制限 |
|---|---|---|
title |
✔ | 最大 200 文字 |
severity |
info/warn/crit — 空欄の場合は warn が既定(運用ポリシーの incident_default_severity) |
|
project_id |
infr_project に存在する必要があります |
|
service_id |
infr_service に存在する必要があります |
|
url |
最大 255 文字 | |
occurred_at |
日付 | |
summary |
最大 4000 文字 | |
direct_cause / root_cause / resolution / action_taken |
それぞれ最大 4000 文字 | |
downtime_min |
整数、≥ 0 | |
impact |
最大 191 文字 |
2) ステータス遷移(パイプライン)
詳細モーダルで次のステップのボタンをクリックすると、ステップ遷移ダイアログが開きます。各ステップには「このステップで何をするか」が説明され、そのステップに関係するレポート項目を入力できます。送信した項目だけが更新されるため、ステータスを変えずに原因を追記したり、レポートだけを充実させたりできます。
| ステップ | コード | このステップですること |
|---|---|---|
| 登録 | open |
ケースを受付状態(調査前)に戻します |
| 調査中 | investigating |
症状を確認し、影響範囲を切り分け、概要を記述します |
| 原因特定 | cause_identified |
直接原因と、その背景にある根本原因を特定して記録します |
| 解決 | resolved |
適用した復旧方法と再発防止策を記録します |
| 終了 | closed |
対処と再発防止策が実施済みであることを確認し、ケースを終了します |
遷移のルール:
resolvedへ移すと、resolved_atが空の場合にnow()が記録されます(MTTR の基準)。closedへ移す際は、発生時刻と同じ flatpickr のピッカーで**終了時刻(closed_at)**を手動入力できます。値を入力すればそれが使われ、空欄のまま(かつ未設定)であればサーバーがnow()を使います。- ステータスが実際に変化した場合(
from !== to)はstatus_changeイベントが追加されます。ダイアログでノートも入力した場合はnoteイベントも追加されます。
日付は、有効な UI ロケール(
window.__locale)に結び付けたtoLocaleStringで描画されるため、EN モードでも月や時刻が正しく表示されます。
3) 協業ノート
詳細モーダルでノートを追加すると、タイムラインに kind='note' イベントが追加されます(ノートは infr_incident_event に統合されており、専用のノートテーブルはありません)。本文は最大 4000 文字です。
4) 削除
ケースを削除すると、そのインシデントと紐づく infr_incident_event の行がまとめて削除されます。元に戻すことはできません。
5) 自動取り込み(Pulse / 例外レポーター)
外部の Laravel アプリがインシデント取り込み API(POST /api/v1/incidents)へ例外を送信すると、IncidentIngestService がそれを処理し、このボードへ自動的に登録します。
- フィンガープリントによる重複排除: 同じエラーがすでに未解決の状態(
open/investigating/cause_identified)で存在する場合、新しいケースは作成されず、occurrence_countが加算されるだけです。解決済み/終了済みのケースは、新規として起票し直されます。 - 新しいケースは
source='pulse'、status='open'、entity_type='exception'で作成され(areaは未設定 → マイグレーションの既定値service→ このボードに表示)、createdイベントが追加されます。 - 再発ノートは 300 秒に1回までに制限されるため、タイムラインが埋め尽くされることはありません。
- ペイロードの
level(error/warning/critical…)は深刻度(warn/crit…)にマッピングされます。受信した深刻度が既存より高い場合、ケースはエスカレーションされます。
キーと連携コードは 管理 ▸ APIキー で管理します。
データソース
| テーブル | 役割 |
|---|---|
infr_incident |
ケース本体。この画面は area='service' のみを照会します。マイグレーション 000719(+ 000723 取り込みフィールド・000731 area・000732 source 拡張) |
infr_incident_event |
タイムライン(追記のみ)。kind = created/note/action/status_change/cause/resolution/alert_added。created_at のみを使用(マイグレーション 000720) |
infr_project |
プロジェクトのドロップダウン・カードのプロジェクト名 |
infr_service |
サービスのドロップダウン |
infr_audit_log |
作成・更新・遷移・削除の監査証跡 |
主な infr_incident のカラム: source, area, title, severity, status, project_id, service_id, url, occurred_at, detected_at, resolved_at, closed_at, summary, direct_cause, root_cause, resolution, action_taken, downtime_min, impact, fingerprint, occurrence_count, last_occurred_at, api_key_id, created_by, updated_by。
既定値は運用ポリシーの OpsPolicy::slaDefaults() から読み込まれます。
sla_uptime_target         = 99.9   # SLA 目標稼働率(%)
incident_default_severity = warn   # 登録時の既定の深刻度(info|warn|crit)
ルート:
GET  /service/resolution              index(ボード)
GET  /service/resolution/live         live  (JSON ポーリング更新)
POST /service/resolution/save         ケースの登録/更新
POST /service/resolution/transition   ステータス遷移(+ ステップ別レポート/closed_at)
POST /service/resolution/note         協業ノートの追加
POST /service/resolution/delete       ケースの削除
アクセス権限
| 操作 | 必要レベル |
|---|---|
ボードの閲覧(index/live) |
認証済みユーザー(infr.auth、レベル ≥ 1) |
| 登録・更新・遷移・ノート・削除 | レベル ≥ 2 |
- demo (1) — 読み取り専用。書き込みを試みると 403 が返ります(
resolution.err.forbidden、「権限がありません — レベル2以上が必要です」)。 - staff (5) · admin (10) — CRUD と遷移をすべて実行できます。
すべての書き込み(登録・更新・遷移・削除)は infr_audit_log に incident.create / incident.update / incident.transition / incident.delete として記録され、実行者と前後のステータスが残ります。レベルの体系については RBAC レベル を参照してください。
トラブルシューティングと FAQ
Q. MTTR が空欄/値なしで表示されます。
MTTR の平均に含まれるには、ケースに発生時刻(occurred_at)と解決時刻(resolved_at)の両方が必要です。発生時刻を入力したか、解決への遷移で resolved_at が記録されたかを確認してください。
Q. 累計ダウンタイムが 0 と表示されます。
ダウンタイムの KPI は各ケースの downtime_min フィールドの単純合計です。ケースにダウンタイム(分)を入力する必要があり、発生時刻と解決時刻から自動的に算出されるわけではありません。
Q. Pulse のケースが表示されません。
取り込まれたケースは source='pulse' で area は未設定のため、既定の service となりここに表示されます。それでも見当たらない場合は、(1) API キーが有効か、(2) 同じフィンガープリントがすでに未解決のケースへ重複排除されていないか(occurrence_count が加算されただけ)を確認してください。セキュリティのインシデントは、このボードではなく セキュリティ問題解決(area='security')に表示されます。
Q. 終了時刻を過去に設定できますか。
できます。closed 遷移ダイアログの終了時刻(flatpickr)フィールドに希望の時刻を入力すると、その値が保存されます。空欄のままにすると、サーバーの現在時刻(now())が使われます。
Q. ステータスを変えずに原因だけ追記したいです。 遷移ダイアログは、送信した項目だけを更新します。同じステータスへ遷移しながらレポート項目を入力すれば、ステータス変更イベントを発生させずにレポートを更新できます(あるいはケースを直接編集してください)。
Q. 削除したケースは復元できますか。 できません。削除するとケースとそのタイムラインイベントがすべて消え、元に戻せません。削除操作そのものは監査ログに記録されます。
関連項目
- セキュリティ問題解決 — 同じ
infr_incidentテーブルをarea='security'で共有するミラーボード。 - インシデント取り込み API · API キー — 外部アプリのエラーを
source='pulse'のケースとして自動登録します。 - プロジェクト — ケースを紐づけるプロジェクトのレジストリ。
- サービス概要 — ライブのサービス運用(未解決インシデント KPI の供給元)。
- オブザーバビリティ(Pulse/Horizon) — 例外収集パイプラインの背景。