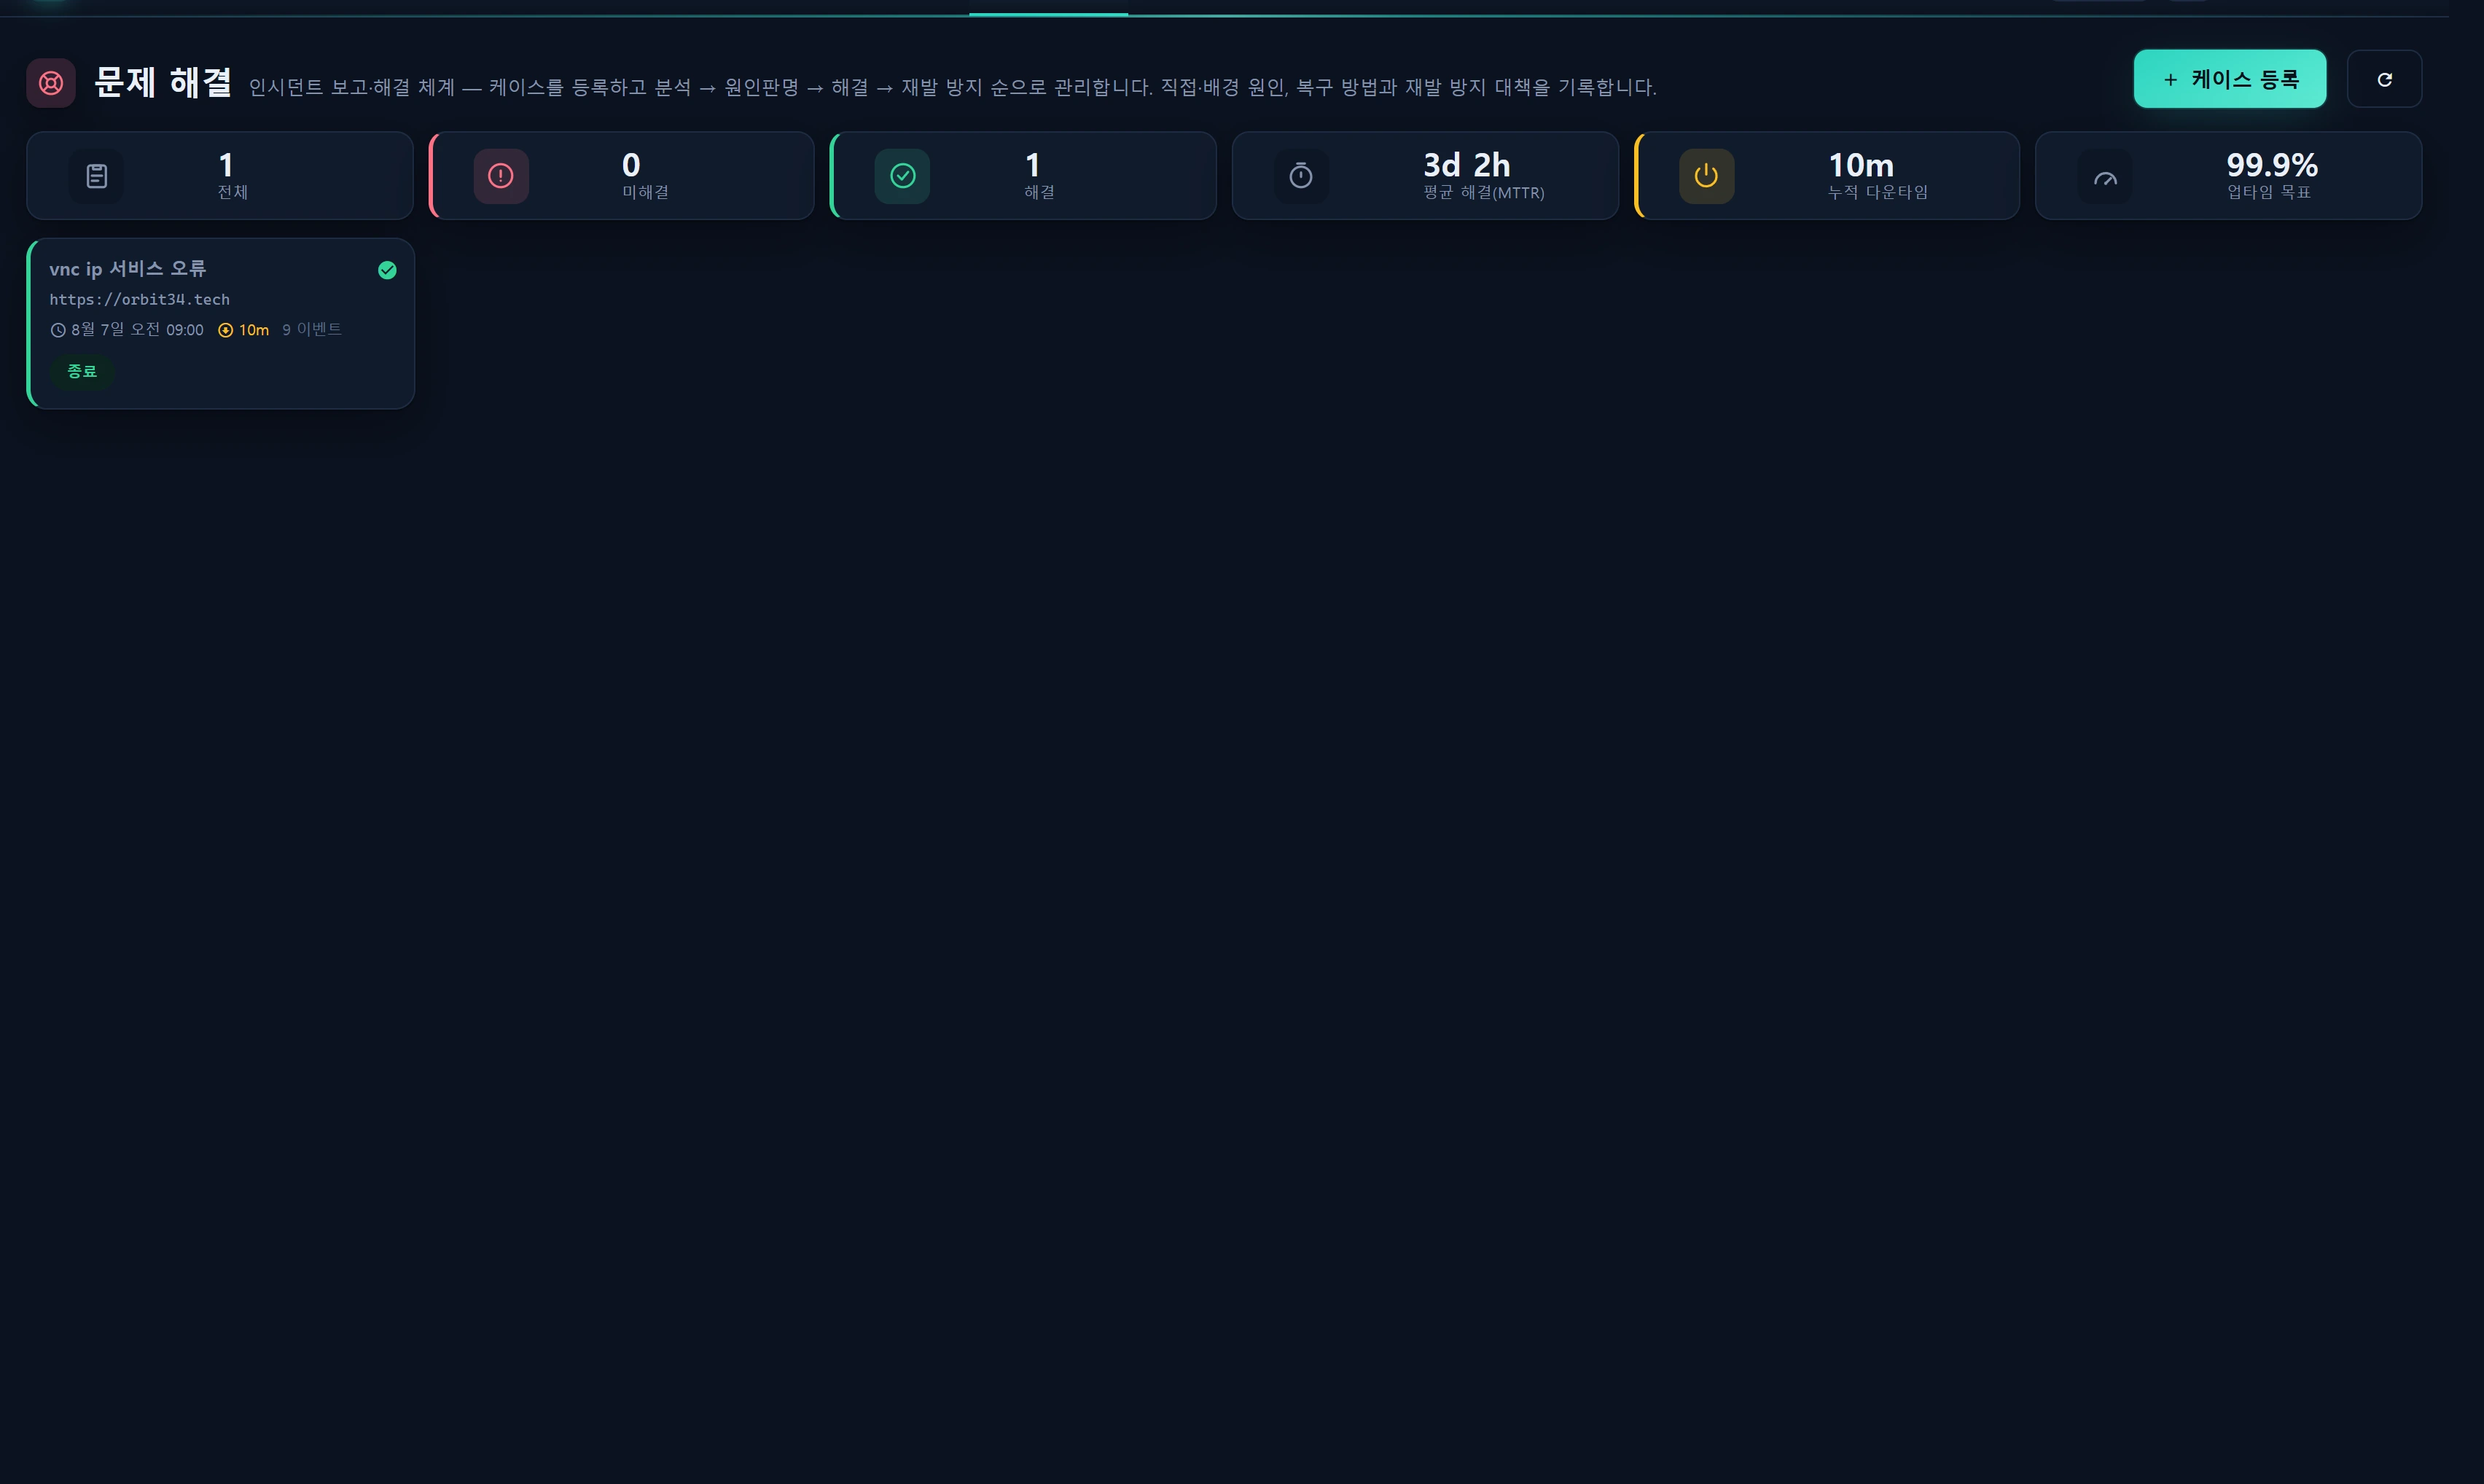
Übersicht — was diese Seite leistet
Problemlösung ist der Workflow für Vorfallfälle des Rollenbereichs Service. Erfassen Sie jeden Ausfall, Fehler oder Leistungsabfall als einen einzelnen Fall und führen Sie ihn durch die Status-Pipeline Erfassung → in Untersuchung → Ursache identifiziert → gelöst → geschlossen, wobei Sie in jedem Schritt Untersuchung, Ursache und Maßnahme festhalten. Die Seite dient zugleich als Verzeichnis Ihrer Post-mortems und vorbeugenden Maßnahmen.
Alle Daten liegen in einer einzigen Tabelle, infr_incident, und diese Seite verarbeitet ausschließlich Zeilen mit area='service'. Die Seite Sicherheits-Problemlösung teilt sich dieselbe Tabelle mit area='security' — identisches Schema, getrenntes Board.
Jeder Fall führt vier Ursachen-/Maßnahmenfelder, die einem formalen Post-mortem-Bericht nachempfunden sind:
| Feld | Bedeutung | Beispiel |
|---|---|---|
direct_cause |
Der unmittelbare Auslöser des Ausfalls | Verbindungslimit von mysql überschritten (Too many connections) |
root_cause |
Der zugrunde liegende Grund, der die unmittelbare Ursache hervorgebracht hat | ein Cron-Skript im 5-Minuten-Takt gab Verbindungen nie zurück → Leck → Limit erschöpft |
resolution |
Maßnahme, die den Dienst während des Vorfalls wiederhergestellt hat | Verbindungen bereinigt, Prozess neu gestartet, Limit für die sofortige Wiederherstellung angehoben |
action_taken |
Dauerhafte Behebung, um eine Wiederholung zu verhindern | dediziertes Konto mit MAX_USER_CONNECTIONS isoliert, Skript gepatcht, Überwachungsalarm ergänzt |
Diese Seite wurde aus dem früheren Menü „SLA & Uptime“ umbenannt (Namensraum
sla→resolution). Der KPI für das Verfügbarkeitsziel (uptime_target) bleibt erhalten.
Wann Sie sie einsetzen
- Nachbereitung eines Vorfalls: nachdem ein Dienst ausgefallen und wieder verfügbar ist, halten Sie Ursache, Behebung und Vorbeugung als wiederverwendbare Retrospektive fest.
- Wiederholungsverfolgung: prüfen, ob derselbe Fehler weiterhin auftritt und ob die Grundursache tatsächlich beseitigt wurde.
- MTTR- und Ausfallzeitsteuerung: die mittlere Lösungszeit und die kumulierte Ausfallzeit als Kennzahlen führen und mit Ihrem Verfügbarkeitsziel vergleichen.
- Bearbeitung der automatischen Eingangswarteschlange: wenn externe Anwendungen Fehler über Pulse bzw. den Exception-Reporter melden, landen diese hier als Fälle mit
source='pulse', die ein Mensch sichten und lösen muss.
Aufbau
KPI-Leiste
Die KPIs im Kopfbereich werden über alle Fälle mit area='service' berechnet.
| KPI | Berechnung |
|---|---|
Gesamt (total) |
Anzahl der Service-Fälle |
Aktiv (active) |
Summe aus open + investigating + cause_identified |
Gelöst (resolved) |
Summe aus resolved + closed |
MTTR (mttr_min) |
Mittelwert aus (Lösung − Auftreten) in Minuten, nur für Fälle, die SOWOHL occurred_at ALS AUCH resolved_at besitzen |
Kumulierte Ausfallzeit (downtime_min) |
Einfache Summe des Feldes downtime_min je Fall (Minuten) |
Verfügbarkeitsziel (uptime_target) |
sla_uptime_target der Betriebsrichtlinie (Standard 99.9%) |
Für einen belastbaren MTTR tragen Sie am Fall einen Auftretenszeitpunkt (
occurred_at) ein und lassen Sie den Übergang auf „gelöst“ automatischresolved_atsetzen. Ein Fall ohne Auftretenszeitpunkt bleibt im MTTR-Mittelwert unberücksichtigt.
Fall-Board
Die Fälle werden als Karten/Zeilen aufgelistet und serverseitig sortiert (in PHP, um rohes SQL im Controller zu vermeiden) — nach dieser Priorität:
- Statusrang:
open→investigating→cause_identified→resolved→closed - Schweregradrang:
crit→warn→info - Neueste id zuerst
Dadurch steigen aktive, schwerwiegende, aktuelle Fälle nach oben.
Jede Karte zeigt das Herkunfts-Badge (manuell / Pulse / Alarm / Behörde / Quarantäne / aus Erkennung hochgestuft), den Schweregrad, den Status, den Projektnamen, den Auftretenszeitpunkt, die Ausfallzeit und die Anzahl der Ereignisse.
Detail-Dialog
Beim Öffnen eines Falls erscheint links der Bericht (Zusammenfassung · direkte Ursache · Grundursache · Behebung · vorbeugende Maßnahme) und rechts die Zeitleiste (Statuswechsel · Notizen), mit den Übergangsschaltflächen der Pipeline im Kopfbereich.
Vorgehen
1) Einen Fall erfassen
[Register case] → modales Formular. Beim Anlegen wird der Fall mit source='manual', area='service', status='open' gespeichert; detected_at wird serverseitig gesetzt (now()) und ein Ereignis created an die Zeitleiste angehängt.
Felder und Prüfgrenzen:
| Feld | Pflicht | Grenze |
|---|---|---|
title |
✔ | max. 200 Zeichen |
severity |
info/warn/crit — leer bedeutet standardmäßig warn (Betriebsrichtlinie incident_default_severity) |
|
project_id |
muss in infr_project vorhanden sein |
|
service_id |
muss in infr_service vorhanden sein |
|
url |
max. 255 Zeichen | |
occurred_at |
Datum | |
summary |
max. 4000 Zeichen | |
direct_cause / root_cause / resolution / action_taken |
jeweils max. 4000 Zeichen | |
downtime_min |
ganzzahlig, ≥ 0 | |
impact |
max. 191 Zeichen |
2) Statusübergang (Pipeline)
Ein Klick auf die Schaltfläche des nächsten Schritts im Detail-Dialog öffnet einen Schrittübergangs-Dialog. Jeder Schritt erläutert, „was in diesem Schritt zu tun ist“, und lässt Sie die für diesen Schritt relevanten Berichtsfelder ausfüllen. Nur die Felder, die Sie senden, werden aktualisiert — Sie können Ursachen also ergänzen, ohne den Status zu ändern, oder ausschließlich den Bericht ausbauen.
| Schritt | Code | Was in diesem Schritt zu tun ist |
|---|---|---|
| Erfassung | open |
Den Fall in den Eingang zurückstellen (vor der Untersuchung) |
| In Untersuchung | investigating |
Symptome bestätigen, Auswirkung eingrenzen, Zusammenfassung schreiben |
| Ursache identifiziert | cause_identified |
Die direkte Ursache und deren Grundursache (Hintergrund) bestimmen und festhalten |
| Gelöst | resolved |
Die angewandte Wiederherstellungsmethode und die vorbeugende Maßnahme festhalten |
| Geschlossen | closed |
Prüfen, dass Behebung und Vorbeugung umgesetzt sind, und den Fall schließen |
Übergangsregeln:
- Der Wechsel auf
resolvedsetztresolved_atmitnow(), sofern das Feld leer ist (die MTTR-Grundlage). - Beim Wechsel auf
closedkönnen Sie einen Schließzeitpunkt (closed_at) manuell über denselben flatpickr-Auswahldialog eingeben, der auch für den Auftretenszeitpunkt genutzt wird. Geben Sie einen Wert an, wird dieser verwendet; bleibt das Feld leer (und ist noch nicht gesetzt), verwendet der Servernow(). - Ändert sich der Status tatsächlich (
from !== to), wird ein Ereignisstatus_changeangehängt; tragen Sie im Dialog zusätzlich eine Notiz ein, kommt auch ein Ereignisnotehinzu.
Datumsangaben werden über
toLocaleStringgerendert, gebunden an die aktive Oberflächensprache (window.__locale), sodass Monat und Uhrzeit auch im EN-Modus korrekt erscheinen.
3) Notizen zur Zusammenarbeit
Wenn Sie im Detail-Dialog eine Notiz hinzufügen, wird ein Ereignis kind='note' an die Zeitleiste angehängt (Notizen sind in infr_incident_event zusammengefasst — eine separate Notiztabelle gibt es nicht). Text max. 4000 Zeichen.
4) Löschen
Beim Löschen eines Falls werden der Vorfall und alle zugehörigen infr_incident_event-Zeilen gemeinsam entfernt. Das lässt sich nicht rückgängig machen.
5) Automatischer Eingang (Pulse / Exception-Reporter)
Wenn eine externe Laravel-Anwendung ihre Exceptions an die Vorfall-Ingest-API (POST /api/v1/incidents) sendet, verarbeitet IncidentIngestService sie und trägt sie automatisch auf diesem Board ein:
- Fingerprint-Deduplizierung: Existiert derselbe Fehler bereits in einem offenen Zustand (
open/investigating/cause_identified), wird kein neuer Fall angelegt — es wird lediglichoccurrence_counthochgezählt. Gelöste bzw. geschlossene Fälle werden als neue Fälle wieder eröffnet. - Neue Fälle werden mit
source='pulse',status='open',entity_type='exception'angelegt (areableibt ungesetzt → der Migrationsstandardservice→ auf diesem Board sichtbar), und ein Ereigniscreatedwird angehängt. - Wiederholungsnotizen werden auf einmal je 300 Sekunden gedrosselt, damit die Zeitleiste nicht überflutet wird.
- Das
levelder Nutzlast (error/warning/critical …) wird auf den Schweregrad abgebildet (warn/crit…); ist ein eingehender Schweregrad höher als der bestehende, wird der Fall hochgestuft.
Schlüssel und Integrationscode verwalten Sie unter Verwaltung ▸ API-Schlüssel.
Datenquellen
| Tabelle | Rolle |
|---|---|
infr_incident |
Der Fall selbst. Diese Seite fragt ausschließlich area='service' ab. Migration 000719 (+ 000723 Ingest-Felder · 000731 area · 000732 Erweiterung von source) |
infr_incident_event |
Zeitleiste (nur anhängend). kind = created/note/action/status_change/cause/resolution/alert_added. Nutzt ausschließlich created_at (Migration 000720) |
infr_project |
Projekt-Auswahlliste · Projektname auf der Karte |
infr_service |
Service-Auswahlliste |
infr_audit_log |
Prüfpfad für Anlegen/Ändern/Übergang/Löschen |
Zentrale Spalten von infr_incident: source, area, title, severity, status, project_id, service_id, url, occurred_at, detected_at, resolved_at, closed_at, summary, direct_cause, root_cause, resolution, action_taken, downtime_min, impact, fingerprint, occurrence_count, last_occurred_at, api_key_id, created_by, updated_by.
Die Standardwerte stammen aus der Betriebsrichtlinie OpsPolicy::slaDefaults():
sla_uptime_target         = 99.9   # SLA-Zielverfügbarkeit (%)
incident_default_severity = warn   # Standard-Schweregrad bei der Erfassung (info|warn|crit)
Routen:
GET  /service/resolution              index (Board)
GET  /service/resolution/live         live  (JSON-Polling-Aktualisierung)
POST /service/resolution/save         Fall erfassen / aktualisieren
POST /service/resolution/transition   Statusübergang (+ Bericht je Schritt / closed_at)
POST /service/resolution/note         Notiz zur Zusammenarbeit hinzufügen
POST /service/resolution/delete       Fall löschen
Zugriff
| Aktion | Erforderliche Stufe |
|---|---|
Board ansehen (index/live) |
Angemeldeter Benutzer (infr.auth, Stufe ≥ 1) |
| Erfassen / Ändern / Übergang / Notiz / Löschen | Stufe ≥ 2 |
- demo (1) — nur lesend. Jeder Schreibversuch liefert 403 (
resolution.err.forbidden, „keine Berechtigung — Stufe 2 oder höher erforderlich“). - staff (5) · admin (10) — vollständiges CRUD und Übergänge.
Jeder Schreibvorgang (Erfassen/Ändern/Übergang/Löschen) wird in infr_audit_log als incident.create / incident.update / incident.transition / incident.delete festgehalten, samt handelnder Person und Status vorher/nachher. Zum Stufenmodell siehe RBAC-Stufen.
Fehlersuche und FAQ
F. Der MTTR bleibt leer / zeigt keinen Wert.
Ein Fall muss SOWOHL einen Auftretenszeitpunkt (occurred_at) ALS AUCH einen Lösungszeitpunkt (resolved_at) besitzen, um in den MTTR-Mittelwert einzugehen. Prüfen Sie, ob Sie den Auftretenszeitpunkt eingetragen haben und ob der Übergang auf „gelöst“ resolved_at gesetzt hat.
F. Die kumulierte Ausfallzeit zeigt 0.
Der Ausfallzeit-KPI ist eine einfache Summe des Feldes downtime_min je Fall. Sie müssen die Ausfallzeit (in Minuten) am Fall eintragen; sie wird nicht automatisch aus Auftretens- und Lösungszeitpunkt abgeleitet.
F. Ein Pulse-Fall taucht nicht auf.
Aufgenommene Fälle tragen source='pulse' und lassen area ungesetzt, greifen also auf den Standard service zurück und erscheinen hier. Fehlt trotzdem einer, prüfen Sie, (1) ob der API-Schlüssel gültig ist und (2) ob derselbe Fingerprint in einen bereits offenen Fall dedupliziert wurde (nur occurrence_count wurde hochgezählt). Sicherheitsvorfälle erscheinen unter Sicherheits-Problemlösung (area='security'), nicht auf diesem Board.
F. Kann ich den Schließzeitpunkt in die Vergangenheit legen?
Ja. Tragen Sie die gewünschte Zeit im Feld für den Schließzeitpunkt (flatpickr) des closed-Übergangsdialogs ein, dann wird dieser Wert gespeichert. Lassen Sie es leer, um die aktuelle Serverzeit (now()) zu verwenden.
F. Ich möchte Ursachen ergänzen, ohne den Status zu ändern. Der Übergangsdialog aktualisiert nur die Felder, die Sie senden. Ein Übergang auf denselben Status bei gleichzeitigem Ausfüllen der Berichtsfelder aktualisiert den Bericht ohne ein Statuswechsel-Ereignis (alternativ bearbeiten Sie den Fall direkt).
F. Lässt sich ein gelöschter Fall wiederherstellen? Nein. Das Löschen entfernt den Fall samt allen Zeitleisten-Ereignissen und lässt sich nicht rückgängig machen. Der Löschvorgang selbst wird im Audit-Log festgehalten.
Verwandt
- Sicherheits-Problemlösung — Spiegel-Board, das sich dieselbe Tabelle
infr_incidentmitarea='security'teilt. - Vorfall-Ingest-API · API-Schlüssel — Fehler externer Anwendungen automatisch als Fälle mit
source='pulse'eintragen. - Projekte — das Projektverzeichnis, mit dem Sie Fälle verknüpfen.
- Service-Übersicht — Live-Betrieb der Dienste (liefert den KPI der ungelösten Vorfälle).
- Observability (Pulse/Horizon) — Hintergrund zur Pipeline der Exception-Erfassung.