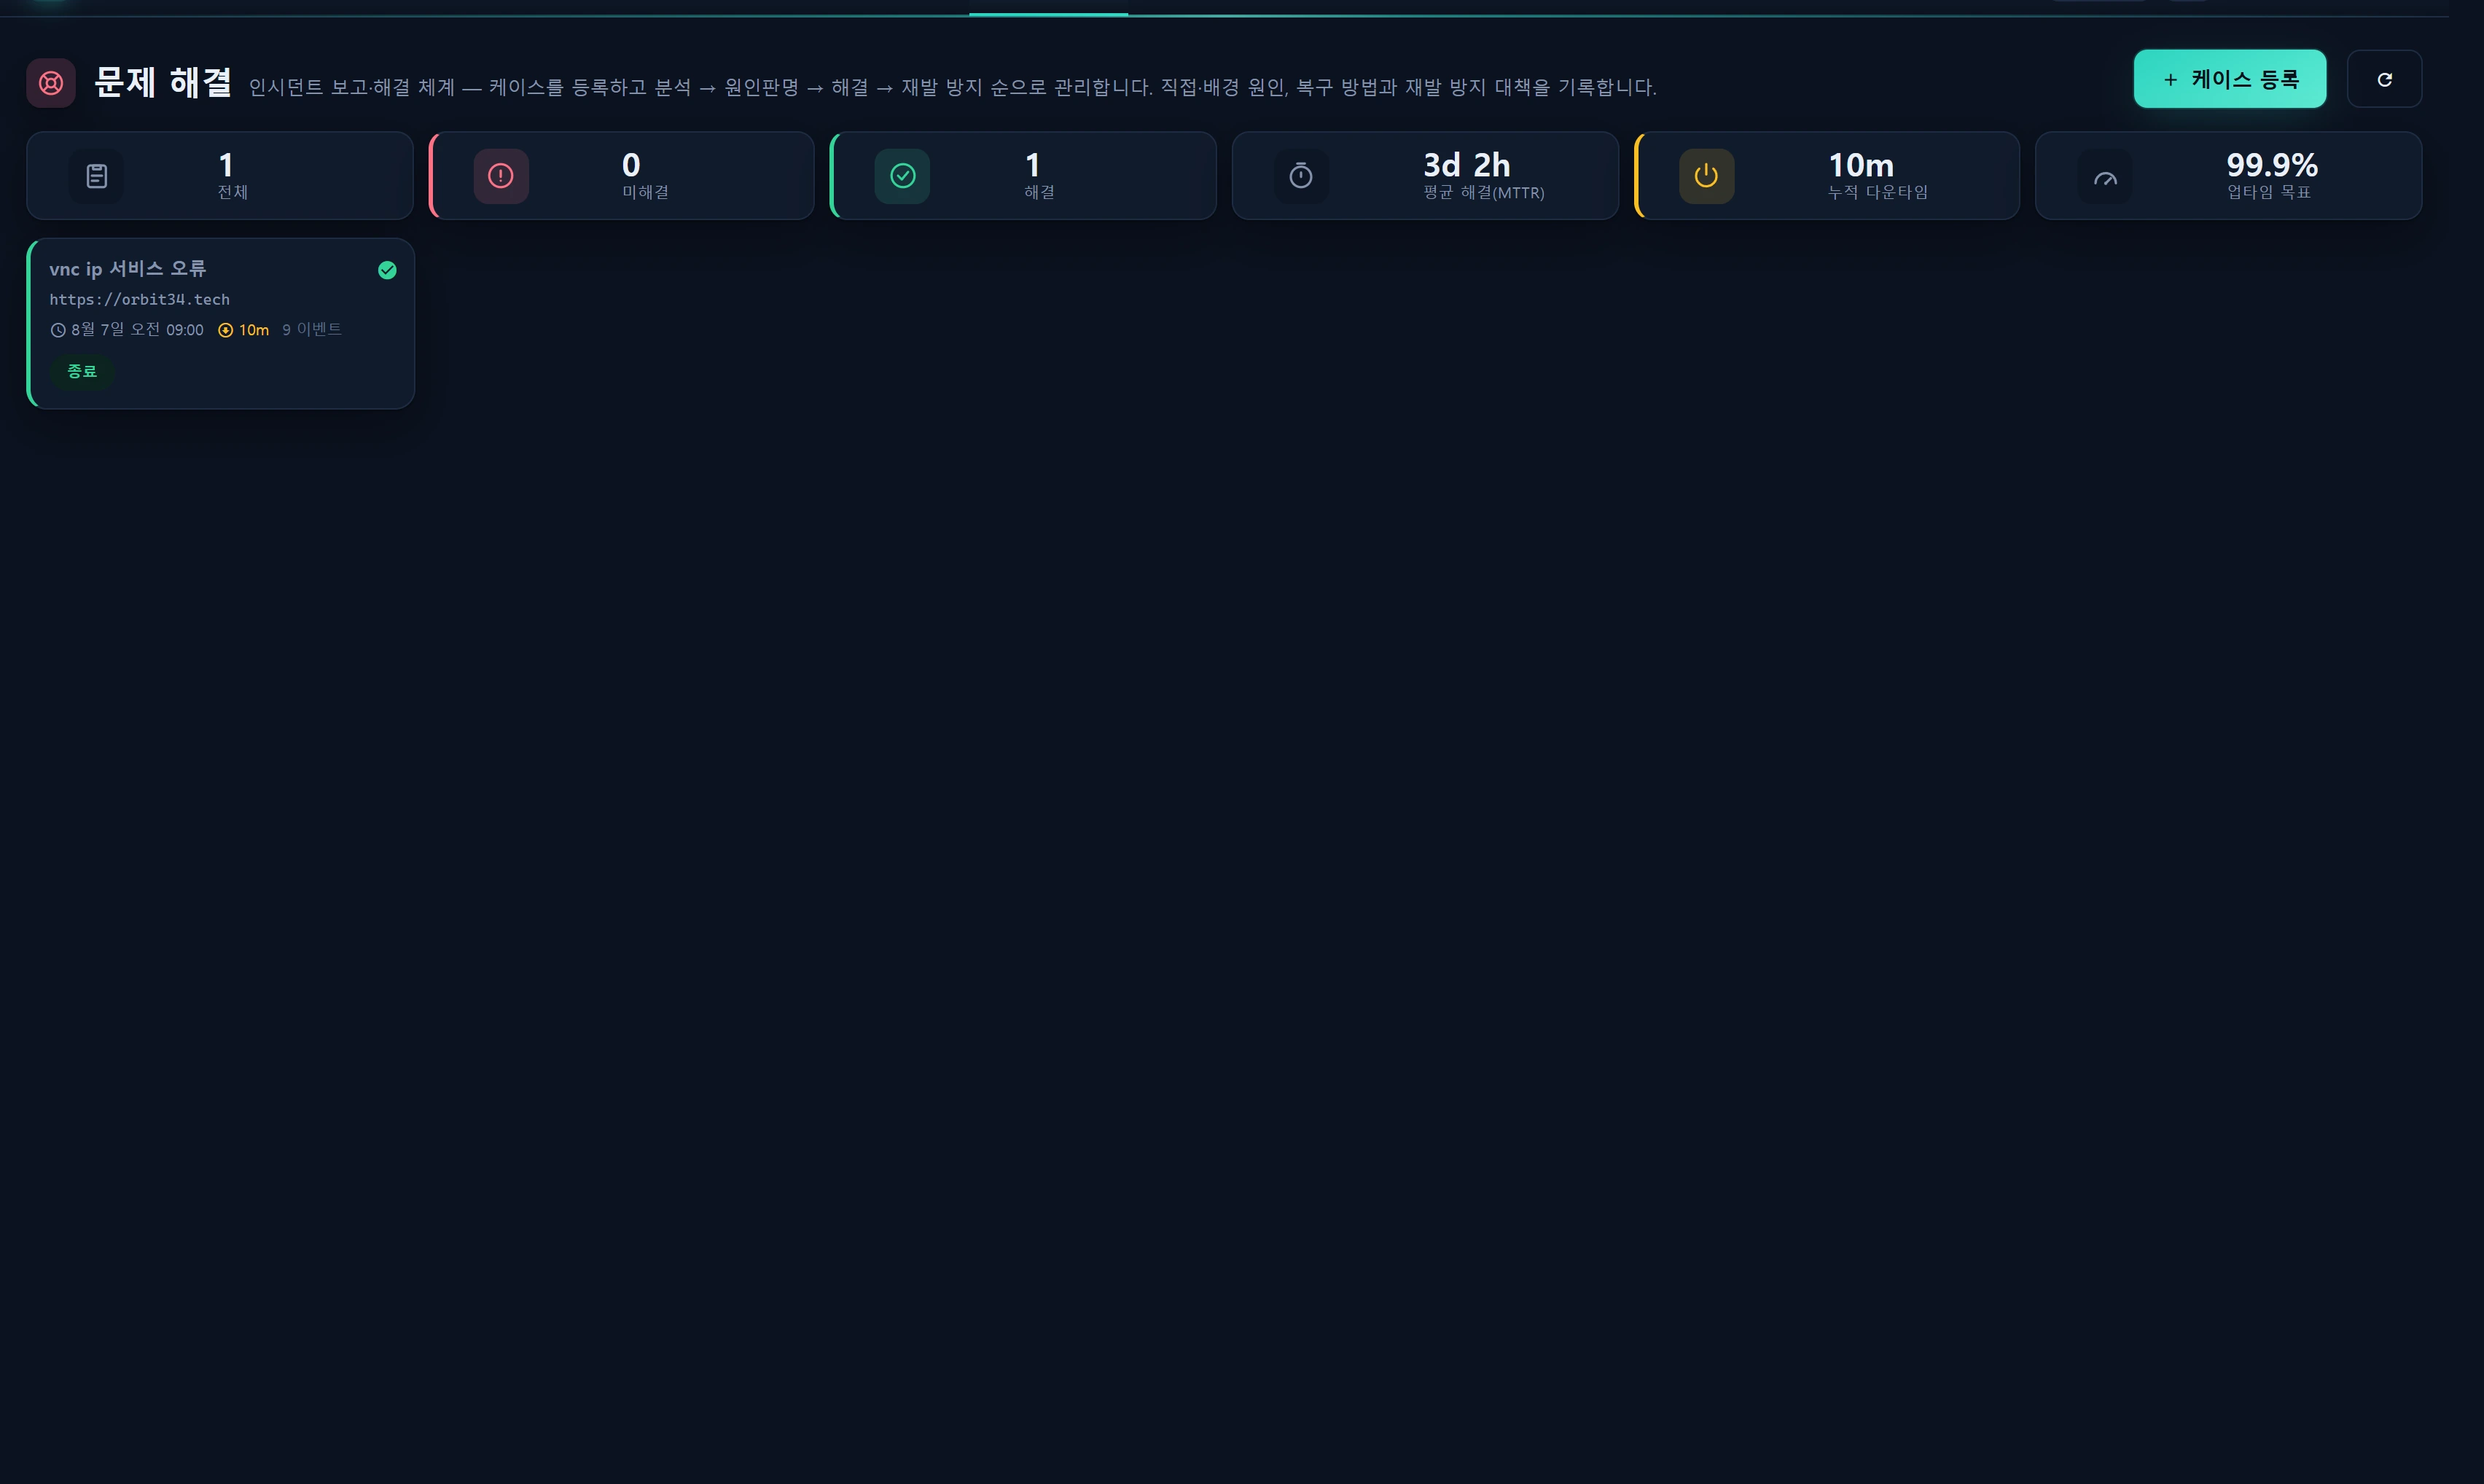
Resumen — qué hace
Resolución de problemas es el flujo de trabajo de casos de incidente del área de rol Servicio. Registre cualquier caída, error o degradación como un único caso y hágalo avanzar por la canalización de estados registro → en investigación → causa identificada → resuelto → cerrado, capturando la investigación, la causa y la acción en cada paso. Sirve además como libro de registro de post-mortems y de acciones preventivas.
Todos los datos residen en una sola tabla, infr_incident, y esta pantalla trata únicamente las filas con area='service'. La pantalla Resolución de problemas de seguridad comparte la misma tabla con area='security': esquema idéntico, tablero separado.
Cada caso lleva cuatro campos de causa/acción modelados sobre un informe post-mortem formal:
| Campo | Significado | Ejemplo |
|---|---|---|
direct_cause |
El desencadenante superficial de la caída | se superó el límite de conexiones de mysql (Too many connections) |
root_cause |
El motivo de fondo que produjo la causa superficial | un script cron de 5 minutos nunca devolvía las conexiones → fuga → límite agotado |
resolution |
Acción que restableció el servicio durante el incidente | se liberaron conexiones, se reinició el proceso, se elevó el límite para una recuperación inmediata |
action_taken |
Corrección permanente para evitar la reaparición | se aisló una cuenta dedicada con MAX_USER_CONNECTIONS, se parcheó el script, se añadió una alerta de monitorización |
Esta pantalla se renombró a partir del antiguo menú «SLA & Uptime» (espacio de nombres
sla→resolution). Se conserva el KPI de objetivo de disponibilidad (uptime_target).
Cuándo usarla
- Informe posterior al incidente: cuando un servicio se cae y se recupera, deje registradas la causa, la solución y la prevención como una retrospectiva reutilizable.
- Seguimiento de reaparición: confirmar si el mismo error sigue produciéndose y si la causa raíz se eliminó realmente.
- Gestión de MTTR y tiempo de caída: gestionar como métricas el tiempo medio de resolución y el tiempo de caída acumulado, y compararlos con su objetivo de disponibilidad.
- Atender la cola de admisión automática: cuando aplicaciones externas envían errores mediante Pulse o el reportador de excepciones, estos llegan aquí como casos con
source='pulse'para que una persona los clasifique y los resuelva.
Disposición
Franja de KPI
Los KPI superiores se calculan sobre todos los casos con area='service'.
| KPI | Cómo se calcula |
|---|---|
Total (total) |
Recuento de casos de servicio |
Activos (active) |
Suma de open + investigating + cause_identified |
Resueltos (resolved) |
Suma de resolved + closed |
MTTR (mttr_min) |
Media de (resolución − aparición) en minutos, solo para los casos que tienen A LA VEZ occurred_at y resolved_at |
Tiempo de caída acumulado (downtime_min) |
Suma simple del campo downtime_min de cada caso (minutos) |
Objetivo de disponibilidad (uptime_target) |
sla_uptime_target de la Política de operaciones (99.9% por defecto) |
Para obtener un MTTR exacto, introduzca una hora de aparición (
occurred_at) en el caso y deje que la transición a Resuelto marqueresolved_atautomáticamente. Un caso sin hora de aparición queda excluido de la media de MTTR.
Tablero de casos
Los casos se listan como tarjetas/filas, ordenadas en el servidor (en PHP, para evitar SQL en crudo en el controlador) con esta prioridad:
- Rango de estado:
open→investigating→cause_identified→resolved→closed - Rango de gravedad:
crit→warn→info - Primero el id más reciente
De modo que los casos activos, graves y recientes suben a la parte superior.
Cada tarjeta muestra el distintivo de origen (manual / Pulse / alerta / organismo / cuarentena / promovido desde detección), la gravedad, el estado, el nombre del proyecto, la hora de aparición, el tiempo de caída y el número de eventos.
Ventana de detalle
Al abrir un caso se muestra el Informe a la izquierda (resumen · causa directa · causa raíz · solución · acción preventiva) y la Cronología a la derecha (cambios de estado · notas), con los botones de transición de la canalización en la parte superior.
Cómo usarla
1) Registrar un caso
[Register case] → formulario modal. Al crearlo, el caso se guarda con source='manual', area='service', status='open'; detected_at se marca en el servidor (now()) y se añade un evento created a la cronología.
Campos y límites de validación:
| Campo | Obligatorio | Límite |
|---|---|---|
title |
✔ | máx. 200 caracteres |
severity |
info/warn/crit: si se deja vacío, el valor por defecto es warn (Política de operaciones incident_default_severity) |
|
project_id |
debe existir en infr_project |
|
service_id |
debe existir en infr_service |
|
url |
máx. 255 caracteres | |
occurred_at |
fecha | |
summary |
máx. 4000 caracteres | |
direct_cause / root_cause / resolution / action_taken |
máx. 4000 caracteres cada uno | |
downtime_min |
entero, ≥ 0 | |
impact |
máx. 191 caracteres |
2) Transición de estado (canalización)
En la ventana de detalle, al pulsar el botón del siguiente paso se abre un diálogo de transición de paso. Cada paso explica «qué hacer en este paso» y permite rellenar los campos del informe pertinentes para ese paso. Solo se actualizan los campos que envía, de modo que puede enriquecer las causas sin cambiar el estado, o reforzar únicamente el informe.
| Paso | Código | Qué hacer en este paso |
|---|---|---|
| Registro | open |
Devolver el caso a la bandeja de entrada (antes de investigar) |
| En investigación | investigating |
Confirmar los síntomas, acotar el impacto, redactar el resumen |
| Causa identificada | cause_identified |
Determinar y registrar la causa directa y su causa raíz (de fondo) |
| Resuelto | resolved |
Registrar el método de recuperación aplicado y la acción preventiva |
| Cerrado | closed |
Verificar que la corrección y la prevención están implantadas y cerrar el caso |
Reglas de transición:
- Pasar a
resolvedmarcaresolved_atconnow()si está vacío (la base del MTTR). - Pasar a
closedpermite introducir manualmente una hora de cierre (closed_at) mediante el mismo selector flatpickr usado para la hora de aparición. Si indica un valor, se usa; si se deja en blanco (y no estaba ya fijado), el servidor usanow(). - Si el estado cambia realmente (
from !== to), se añade un eventostatus_change; si además escribe una nota en el diálogo, se añade también un eventonote.
Las fechas se representan con
toLocaleStringvinculado a la configuración regional activa de la interfaz (window.__locale), de modo que el mes y la hora se muestran correctamente incluso en modo EN.
3) Notas de colaboración
Añadir una nota en la ventana de detalle agrega un evento kind='note' a la cronología (las notas se consolidan en infr_incident_event; no hay una tabla de notas aparte). Cuerpo de máx. 4000 caracteres.
4) Eliminar
Eliminar un caso borra el incidente y todas sus filas vinculadas de infr_incident_event a la vez. Esto no se puede deshacer.
5) Admisión automática (Pulse / reportador de excepciones)
Cuando una aplicación Laravel externa envía sus excepciones a la API de ingesta de incidentes (POST /api/v1/incidents), IncidentIngestService las procesa y las da de alta automáticamente en este tablero:
- Deduplicación por huella: si el mismo error ya existe en un estado abierto (
open/investigating/cause_identified), no se crea un caso nuevo: solo se incrementaoccurrence_count. Los casos resueltos o cerrados se vuelven a abrir como nuevos. - Los casos nuevos se crean con
source='pulse',status='open',entity_type='exception'(conareasin definir → el valor por defecto de la migraciónservice→ visible en este tablero), y se añade un eventocreated. - Las notas de reaparición se limitan a una cada 300 segundos para que la cronología no se inunde.
- El
leveldel payload (error/warning/critical…) se asigna a la gravedad (warn/crit…); si una gravedad entrante es mayor que la existente, el caso se escala.
Las claves y el código de integración se gestionan en Administración ▸ Claves API.
Fuentes de datos
| Tabla | Función |
|---|---|
infr_incident |
El caso en sí. Esta pantalla consulta únicamente area='service'. Migración 000719 (+ 000723 campos de ingesta · 000731 area · 000732 ampliación de source) |
infr_incident_event |
Cronología (solo anexado). kind = created/note/action/status_change/cause/resolution/alert_added. Usa solo created_at (migración 000720) |
infr_project |
Desplegable de proyectos · nombre del proyecto en la tarjeta |
infr_service |
Desplegable de servicios |
infr_audit_log |
Rastro de auditoría de creación/actualización/transición/eliminación |
Columnas clave de infr_incident: source, area, title, severity, status, project_id, service_id, url, occurred_at, detected_at, resolved_at, closed_at, summary, direct_cause, root_cause, resolution, action_taken, downtime_min, impact, fingerprint, occurrence_count, last_occurred_at, api_key_id, created_by, updated_by.
Los valores por defecto proceden de la Política de operaciones OpsPolicy::slaDefaults():
sla_uptime_target         = 99.9   # disponibilidad objetivo del SLA (%)
incident_default_severity = warn   # gravedad por defecto al registrar (info|warn|crit)
Rutas:
GET  /service/resolution              index (tablero)
GET  /service/resolution/live         live  (actualización por sondeo JSON)
POST /service/resolution/save         registrar / actualizar un caso
POST /service/resolution/transition   transición de estado (+ informe por paso / closed_at)
POST /service/resolution/note         añadir una nota de colaboración
POST /service/resolution/delete       eliminar un caso
Acceso
| Acción | Nivel requerido |
|---|---|
Ver el tablero (index/live) |
Usuario autenticado (infr.auth, nivel ≥ 1) |
| Registrar / actualizar / transicionar / anotar / eliminar | nivel ≥ 2 |
- demo (1): solo lectura. Cualquier intento de escritura devuelve 403 (
resolution.err.forbidden, «sin permiso: se requiere nivel 2 o superior»). - staff (5) · admin (10): CRUD y transiciones completos.
Cada escritura (registro/actualización/transición/eliminación) queda registrada en infr_audit_log como incident.create / incident.update / incident.transition / incident.delete, capturando al actor y el estado anterior y posterior. Consulte Niveles RBAC para conocer el modelo de niveles.
Resolución de incidencias y preguntas frecuentes
P. El MTTR aparece en blanco / sin valor.
Un caso debe tener A LA VEZ una hora de aparición (occurred_at) y una hora de resolución (resolved_at) para incluirse en la media de MTTR. Compruebe que introdujo la hora de aparición y que la transición a Resuelto marcó resolved_at.
P. El tiempo de caída acumulado muestra 0.
El KPI de tiempo de caída es una suma simple del campo downtime_min de cada caso. Debe introducir el tiempo de caída (en minutos) en el caso; no se deduce automáticamente de las horas de aparición y resolución.
P. Un caso de Pulse no aparece.
Los casos ingeridos tienen source='pulse' y dejan area sin definir, por lo que toman el valor por defecto service y aparecen aquí. Si aun así falta alguno, compruebe (1) si la clave API es válida y (2) si la misma huella se dedujo dentro de un caso ya abierto (solo se incrementó occurrence_count). Los incidentes de seguridad aparecen en Resolución de problemas de seguridad (area='security'), no en este tablero.
P. ¿Puedo fijar la hora de cierre en el pasado?
Sí. Introduzca la hora deseada en el campo de hora de cierre (flatpickr) del diálogo de transición closed y ese valor se guardará. Déjelo en blanco para usar la hora actual del servidor (now()).
P. Quiero enriquecer las causas sin cambiar el estado. El diálogo de transición actualiza solo los campos que envía. Transicionar al mismo estado mientras rellena los campos del informe actualiza el informe sin generar un evento de cambio de estado (o edite el caso directamente).
P. ¿Se puede restaurar un caso eliminado? No. La eliminación borra el caso y todos sus eventos de cronología y no se puede deshacer. La propia acción de eliminar queda registrada en el registro de auditoría.
Relacionado
- Resolución de problemas de seguridad: tablero espejo que comparte la misma tabla
infr_incidentconarea='security'. - API de ingesta de incidentes · claves API: dar de alta automáticamente los errores de aplicaciones externas como casos con
source='pulse'. - Proyectos: el registro de proyectos al que vincula los casos.
- Resumen de servicio: operación de servicios en vivo (alimenta el KPI de incidentes sin resolver).
- Observabilidad (Pulse/Horizon): contexto sobre la canalización de recogida de excepciones.