概要 — 何をする画面か
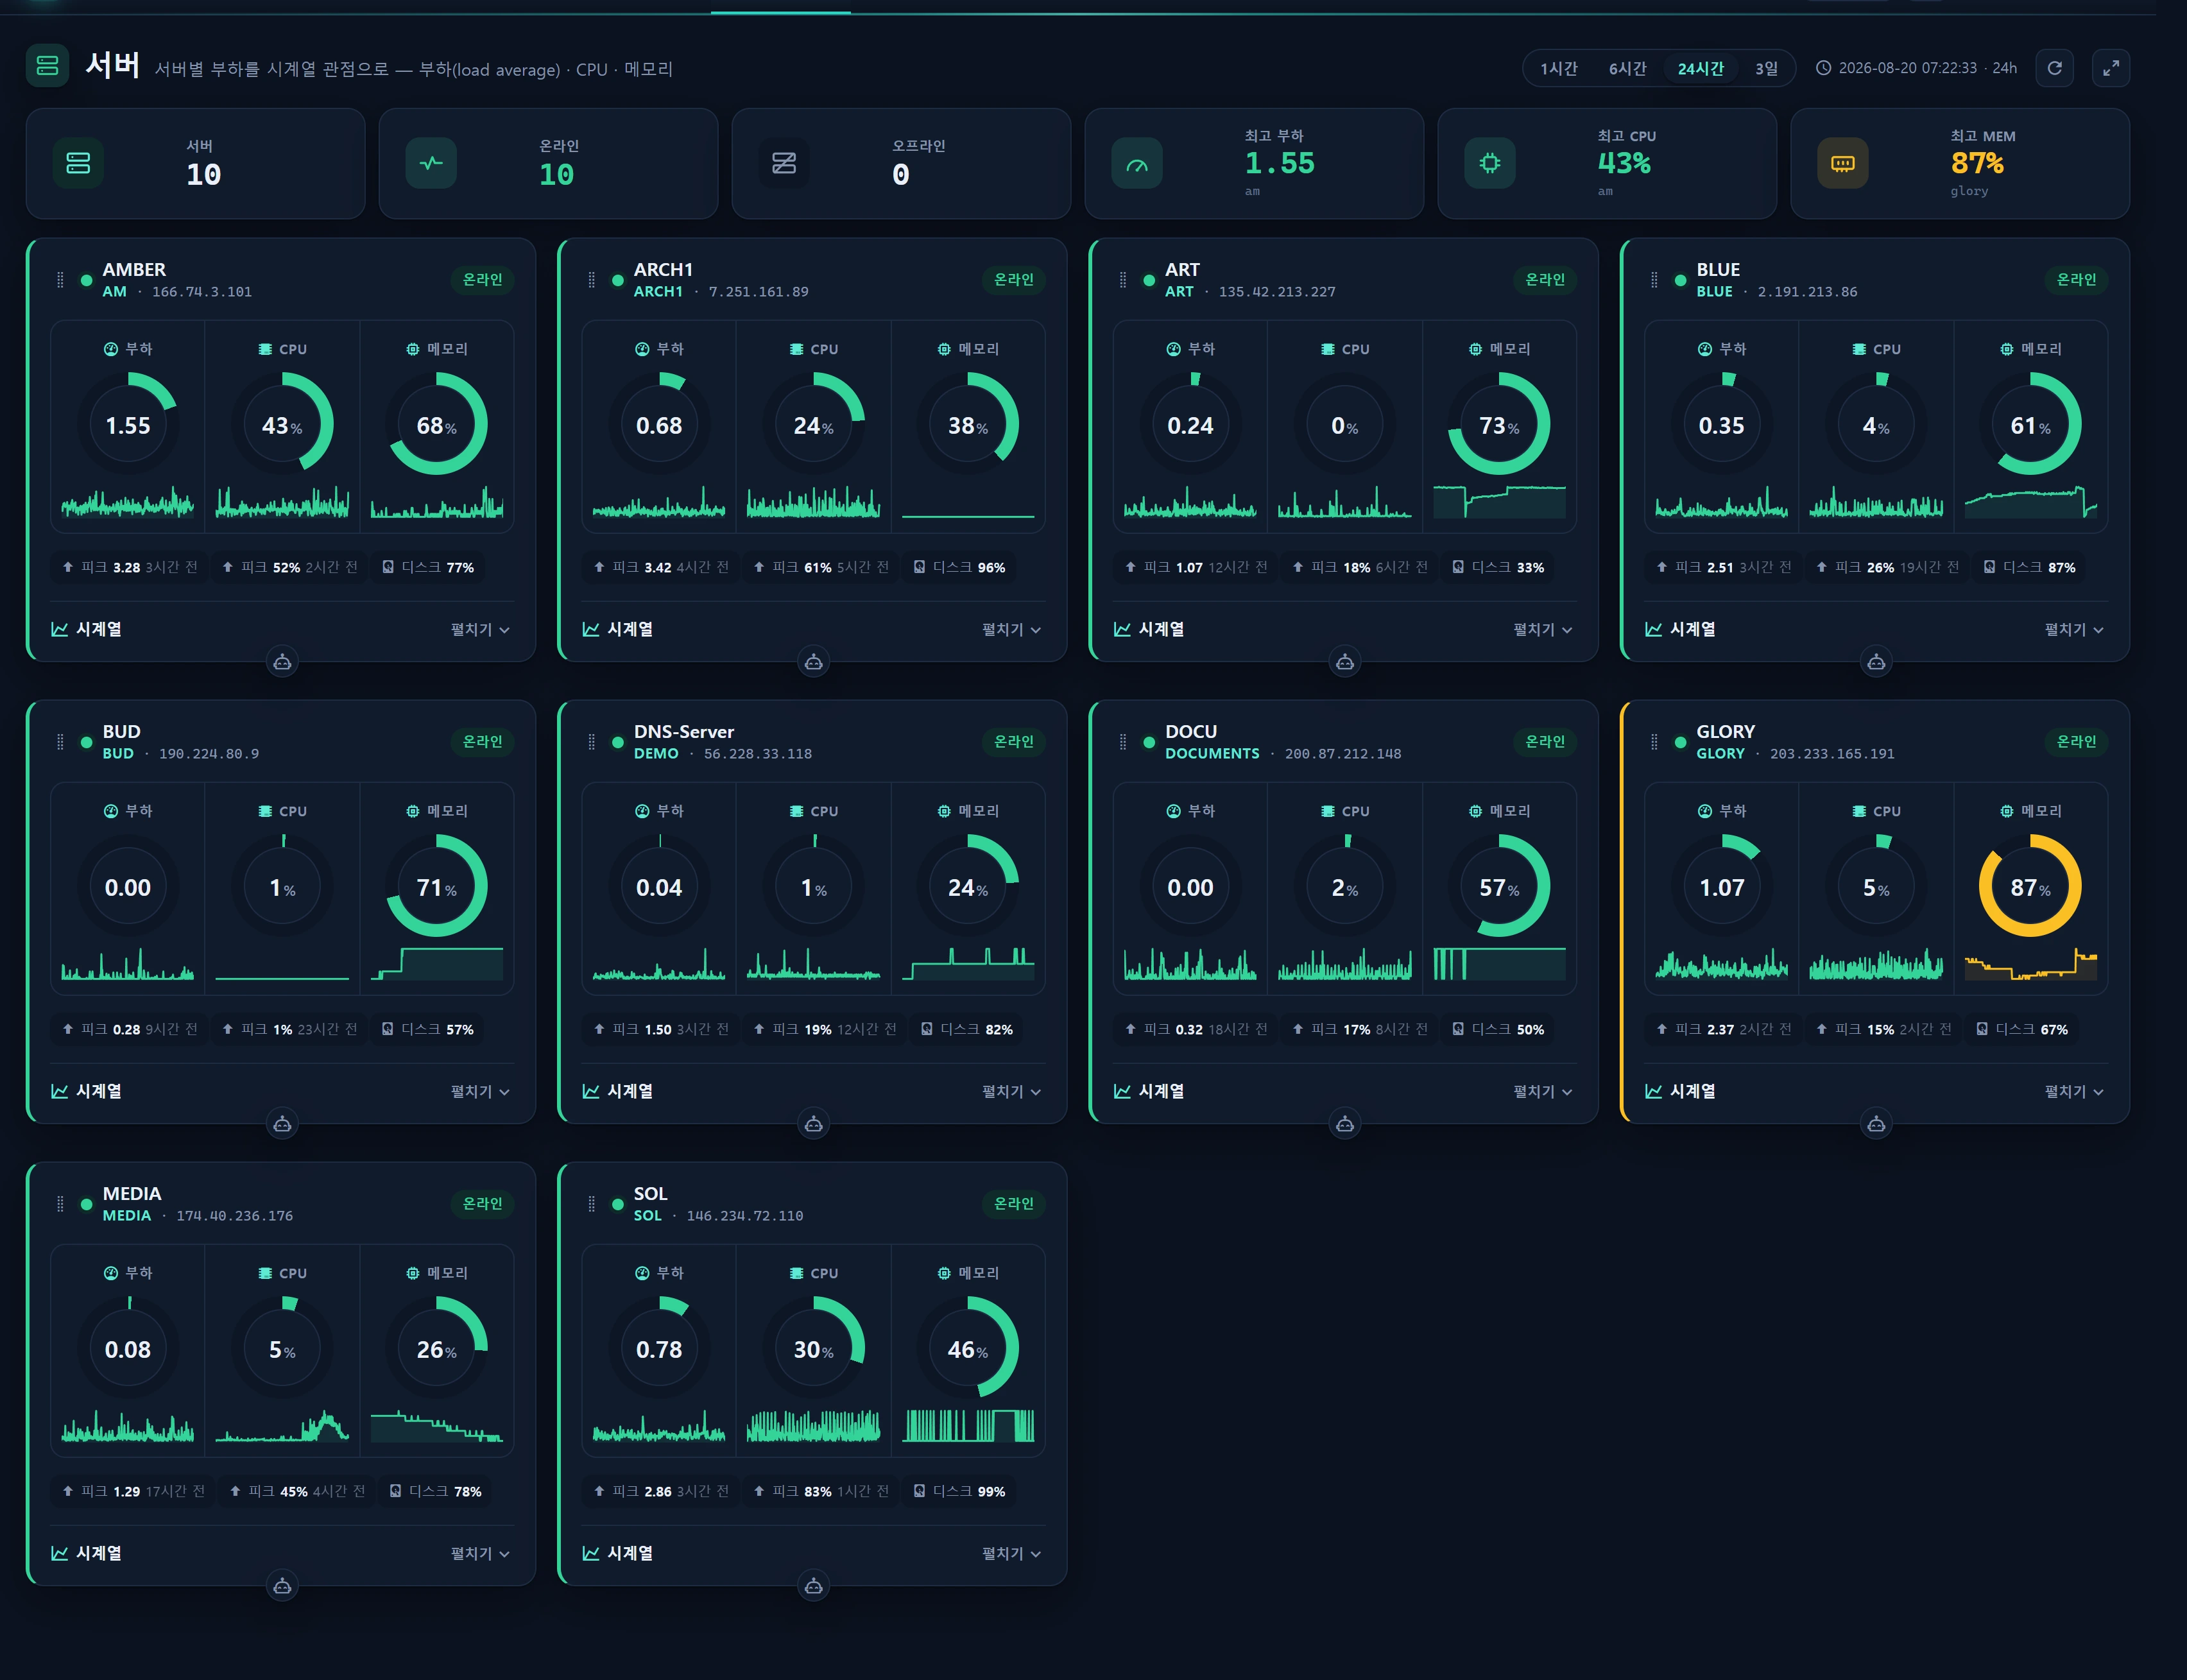
インフラ ▸ サーバー(/infra/servers)は、登録済みの全サーバーノードについて ロードアベレージ・CPU・メモリ を 時系列の視点 で表示します。ヘルス 画面がライブプローブによって「各ノードの現在の状態」を捉えるのに対し、サーバー画面は「直近の数時間から数日にかけて負荷がどう推移したか」に焦点を当てます。stats-design の monitoring/part(load_average・cpu_usage・memory_usage)を再実装したものです。
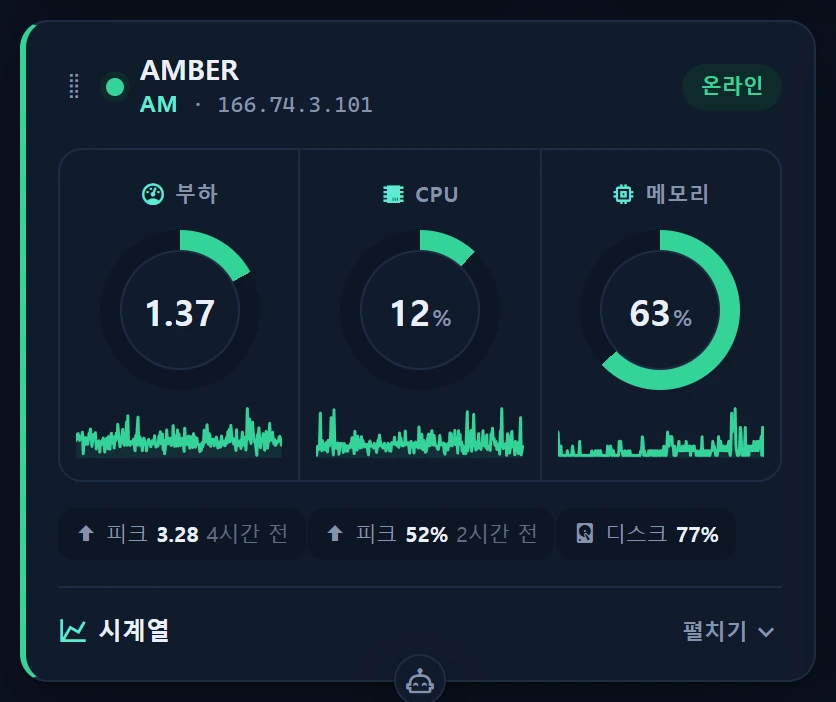
ノードごとに1枚のカードを表示します。
- 3つのリングゲージ(Load/CPU/MEM の現在値) — 深刻度を一目で把握できます。
- SVG スパークライン — 直近の推移のプレビューです。
- [詳細] → ECharts の結合折れ線グラフ(左軸に CPU%・MEM%、右軸に Load)と 統計表(現在/平均/最小/最大 + ピーク時刻)。
メトリクスはレガシーの server_status テーブル(読み取り専用)から取得します。ビルダーである ServerMetricService はクエリを 直近の seq ウィンドウ に絞り込み(テーブル全体をスキャンするスロークエリを回避します)、20秒キャッシュ を適用します。カードグリッドは ドラッグでの並べ替え + メーソンリー に対応し、30秒ポーリング によって自動更新されます。
server_statusは、Laravel の外部でおよそ 5分周期 で動作する Node コレクターrun_report.jsが書き込みます。したがって時間軸の解像度は約5分であり、画面はポーリングによって更新されます(リアルタイムのプッシュ/Reverb ではありません)。
利用シーン
- フリート全体を通して、どのサーバーが 持続的に高負荷 を抱えているかを比較する。
- インシデントや警報が発生した時刻の前後で、負荷/CPU/メモリの曲線の変曲点 を振り返る(ピーク時刻も表示されます)。
- デプロイやトラフィックの急増のあとに、メモリ使用量の傾向 や CPU の飽和 を確認する。
- 警報 がロードアベレージやディスク残量の条件で発火したときの追跡調査として — 該当するノードを時系列で確認します。
ライブのセッション監視(nginx/php/mysql のサービスドット付き)は ヘルス、ネットワーク I/O のバイト/パケットのグラフは トラフィック、ディスクと RAID の健全性は ストレージ・RAID にあります。
レイアウト
上部 KPI バー
ServerMetricService::kpi() が算出します。
| KPI | 意味 |
|---|---|
| サーバー | ウィンドウ内に存在するノードの総数 |
| オンライン | 直近2回の収集サイクル以内に loadavg を報告したノード |
| オフライン | 総数 − オンライン |
| 負荷トップ | 現在の1分ロードアベレージが最も高いノード + エイリアス |
| CPUトップ | 現在の CPU% が最も高いノード + エイリアス |
| メモリトップ | 現在のメモリ % が最も高いノード + エイリアス |
range トグル
表示ウィンドウ(seq ウィンドウのポイント数)を選択します。選択内容は localStorage(infr:range:infra-servers)に保存され、再訪時も維持されます。
| range | seq ポイント数 | ≈ 実際のウィンドウ(5分周期) |
|---|---|---|
| 1h | 12 | 約1時間 |
| 6h | 72 | 約6時間 |
| 24h | 288 | 約24時間(既定) |
| 3d | 864 | 約3日 |
range は「直近 N 回の収集サイクル」に変換されます(絶対的な時間幅ではありません)。5分周期であれば 24h ≈ 288ポイントです。報告頻度の低いノードでは、同じ range でも実際のウィンドウが短くなることがあります — 下部のウィンドウラベルが実際の幅を
24h/6h/45m/2dとして示します。
ノードカード
┌──────────────────────────────────────────────┐
│ label · alias · IP           online / last Nm │   ← ヘッダー(ラベルは infr_instance で補完)
│  ( Load )   ( CPU )   ( MEM )                    │   ← 3つのリングゲージ(現在値)
│  ▁▂▅▇▅▃  スパークライン(SVG polyline)         │
│  peak · disk 42% · net out 1,234        [詳細] │   ← フッター
└──────────────────────────────────────────────┘
カードの枠線とゲージは しきい値のトーン で描画され、カード全体の深刻度は 3つのメトリクスのうち最も悪いもの に従います。
| メトリクス | good | warn | crit |
|---|---|---|---|
| Load(1分) | < 8 | ≥ 8 | ≥ 16 |
| CPU % | < 70 | ≥ 70 | ≥ 90 |
| MEM % | < 85 | ≥ 85 | ≥ 95 |
Load のリングは load 8 で満杯 になるよう正規化されています(
LOAD_FULL=8) — warn のしきい値に合わせてあります。コア数の多いマシンでは load 8 が必ずしも危険とは限らないため、リング中央の数値で絶対値も必ず確認してください。
展開後の詳細(ECharts + 統計)
[詳細] を押すとカードが縦に伸び、メーソンリーが高さの変化を自動的に再配置します。
- 結合折れ線グラフ:
CPU%・MEM%(左軸 0〜100%)+Load(右軸、自動スケール)。x 軸は各収集サイクルの最新タイムスタンプ(HH:MM)で、クロスヘアのツールチップが付きます。 - 統計表: メトリクスごと(load/CPU/メモリ)の 現在・平均・最小・最大、および ピークが発生した時刻(例「12分前にピーク」)。
使い方
/infra/serversを開きます → ノードカードがエイリアスの昇順に並びます。- range トグル(1h/6h/24h/3d)で観測ウィンドウを選びます。ポーリングとは独立して、即座に再クエリされます。
- [詳細] で、そのノードの時系列グラフと統計表を開きます。
- グラフにカーソルを合わせると、クロスヘアで任意の時点の CPU/MEM/Load の値を読み取れます。
- カードを ドラッグ して、よく見るノードを上部に浮かび上がらせます — 順序は
localStorage(infr:order:infra-servers)に保存されます。 - ヘッダーの全画面ボタンで上部ナビゲーションを隠し、ダッシュボードモードで表示します。
画面は /infra/servers/live のポーリングによって 30秒ごと に自動更新されます(操作は不要です)。この画面には書き込み/制御の操作はなく、純粋に観測用です。
ポーリングを行うフロントエンドは、軽量な変更トークン
rev(=server_statusの最新 seq)によって更新が必要かどうかを判断します。新しい収集サイクルが届くまで画面は変化しません — これは「固まっている」のではなく、単に新しいスナップショットがまだないだけです。
データソース
ソースはレガシーの server_status テーブル(MAIN DB、キーバリュー形式の part スキーマ、読み取り専用)です。run_report.js の格納規約をそのまま解釈します。
| part | 値の形式 | 意味 | 系列での用途 |
|---|---|---|---|
loadavg |
"1m 5m 15m" のスペース区切り(例 "0.50 0.42 0.38") |
ロードアベレージ | 系列とリングは 1分ロードアベレージ のみを使用。フッターには 5/15分も表示 |
top |
"NN%"(例 "3.6%") |
CPU ユーザー使用率 | CPU の系列/リング |
free |
"NN%" |
メモリ使用率 = round(used/total×100) | MEM の系列/リング |
df-data / df- / df-home |
JSON {p,u,a} |
ディスク使用率 (p)・使用量 (u)・容量 (a) | 最新のディスクバッジ(df-data → df- → df-home の優先順位) |
traffic-out |
数値 | ネットワーク送出パケットの差分 | net の系列/フッター |
クエリと整形の規律:
- seq ウィンドウ:
SELECT DISTINCT seq ORDER BY seq DESC LIMIT N(インデックススキャン)で直近 N 回の収集サイクルだけを選び、それらの seq/part の値でwhereInクエリを実行します — したがって2億行のテーブルであっても、スキャンするのは狭いウィンドウだけです。OverviewService/HealthServiceと同じ規律です。 - seq = フリート全体のスナップショットのバッチ ID です。系列は常に 過去 → 現在 の順に並べます。
- 欠損値のキャリーフォワード: あるサイクルで part が欠けている場合は、直前の値を引き継ぎます(グラフに欠落を作らないためです)。
- オンライン判定: 直近 2サイクル 以内に loadavg があれば、そのノードはオンラインです(1サイクルの欠落は許容されます)。
last_seen= loadavg を報告した最後のサイクルのタイムスタンプです。 - 20秒キャッシュ:
Cache::remember("infr:srvmetric:v1:{points}", 20, …)。したがって30秒ポーリングであっても、実際の DB クエリは最大でも20秒に1回しか実行されません。 - ラベル/IP の補完: エイリアス/ホスト名(小文字化)を インスタンス(
infr_instance)のnameとip_public/ip_privateに対応付け、60秒キャッシュします。未登録のノードは生のエイリアスを表示します。
server_status を埋める run_report.js コレクターの登録と認証情報は、管理 ▸ コレクター で管理します。
アクセス権限
- 読み取り専用の画面です。 コンソール認証(
infr.auth)を通過したユーザーであれば誰でも閲覧できます(インフラ役割領域の最小user_levelは1 — つまり demo=1 以上です)。 - 書き込み/制御の操作はありません — ここにブロックや再起動のボタンはありません。
- カードの順序と range の選択は サーバー側には保存されません。ブラウザーの
localStorageにのみ保存されます(ユーザーごと・ブラウザーごと)。
レベル体系: demo=1 · staff=5 · admin=10(RBAC レベル を参照)。
トラブルシューティングと FAQ
「サーバーメトリクスがありません。」としか表示されない
server_status に直近のスナップショットがありません。run_report.js コレクターが動作しており、コレクター に登録されていることを確認してください。レガシー(MAIN)DB の接続も確認してください。
ノードがオフラインと表示される
直近2回の収集サイクル以内に loadavg が報告されなかったという意味です。そのノードの run_report の実行状況、時刻(ずれ)、ネットワークを確認してください。last_seen の相対ラベルが、最後に報告した時刻を示します。
カードに分かりやすい名前ではなくエイリアス(例 sol)が表示される
そのエイリアスが インスタンス(infr_instance)に登録されていません。インスタンスを登録すると、その name がラベルになり、IP として ip_public/ip_private が表示されます。
ディスクバッジが空になっている
そのノードが df-data/df-/df-home のいずれも JSON {p,u,a} 形式で報告していません。ディスク使用量と RAID の健全性の詳細は ストレージ・RAID を利用してください。
Load のリングが常に満杯に見える Load のリングは load 8 を上限として正規化されています。コア数の多いサーバーでは load 8 が正常な場合もあるため、リング中央に表示される絶対値 で判断してください。色のトーンのしきい値(warn 8/crit 16)だけで危険と結論づけないでください。
30秒ごとにポーリングしているのに何も変わらない
(1) 新しい収集サイクル(約5分)がまだ届いていないか、(2) 20秒キャッシュのウィンドウ内にいるか、のどちらかです。実際に更新されているかは stamp、ウィンドウラベル、rev(最新の seq)で確認してください。
range を 3d にしたのにウィンドウが短く見える
range は「直近 N サイクル」を意味するため、収集頻度の低いノードでは実際の時間幅が短くなります。下部のウィンドウラベルが実際の幅(45m/6h/2d)を示します。ポイント数の上限は1000です。
関連項目
- ヘルス — 同じノードのライブ状態とサービスドット(nginx/php/mysql)。
- ストレージ・RAID — ディスク使用量、RAID コントローラーの健全性、物理ディスクマップ。
- トラフィック — ネットワーク I/O のバイト/パケットの時系列。
- 警報 — ロードアベレージやディスク残量の条件で担当者へ SMS/メールを送信。
- インスタンス — エイリアス→ラベル/IP 補完のソース(資産台帳)。
- コレクター —
server_statusを埋めるrun_reportコレクターのレジストリ。