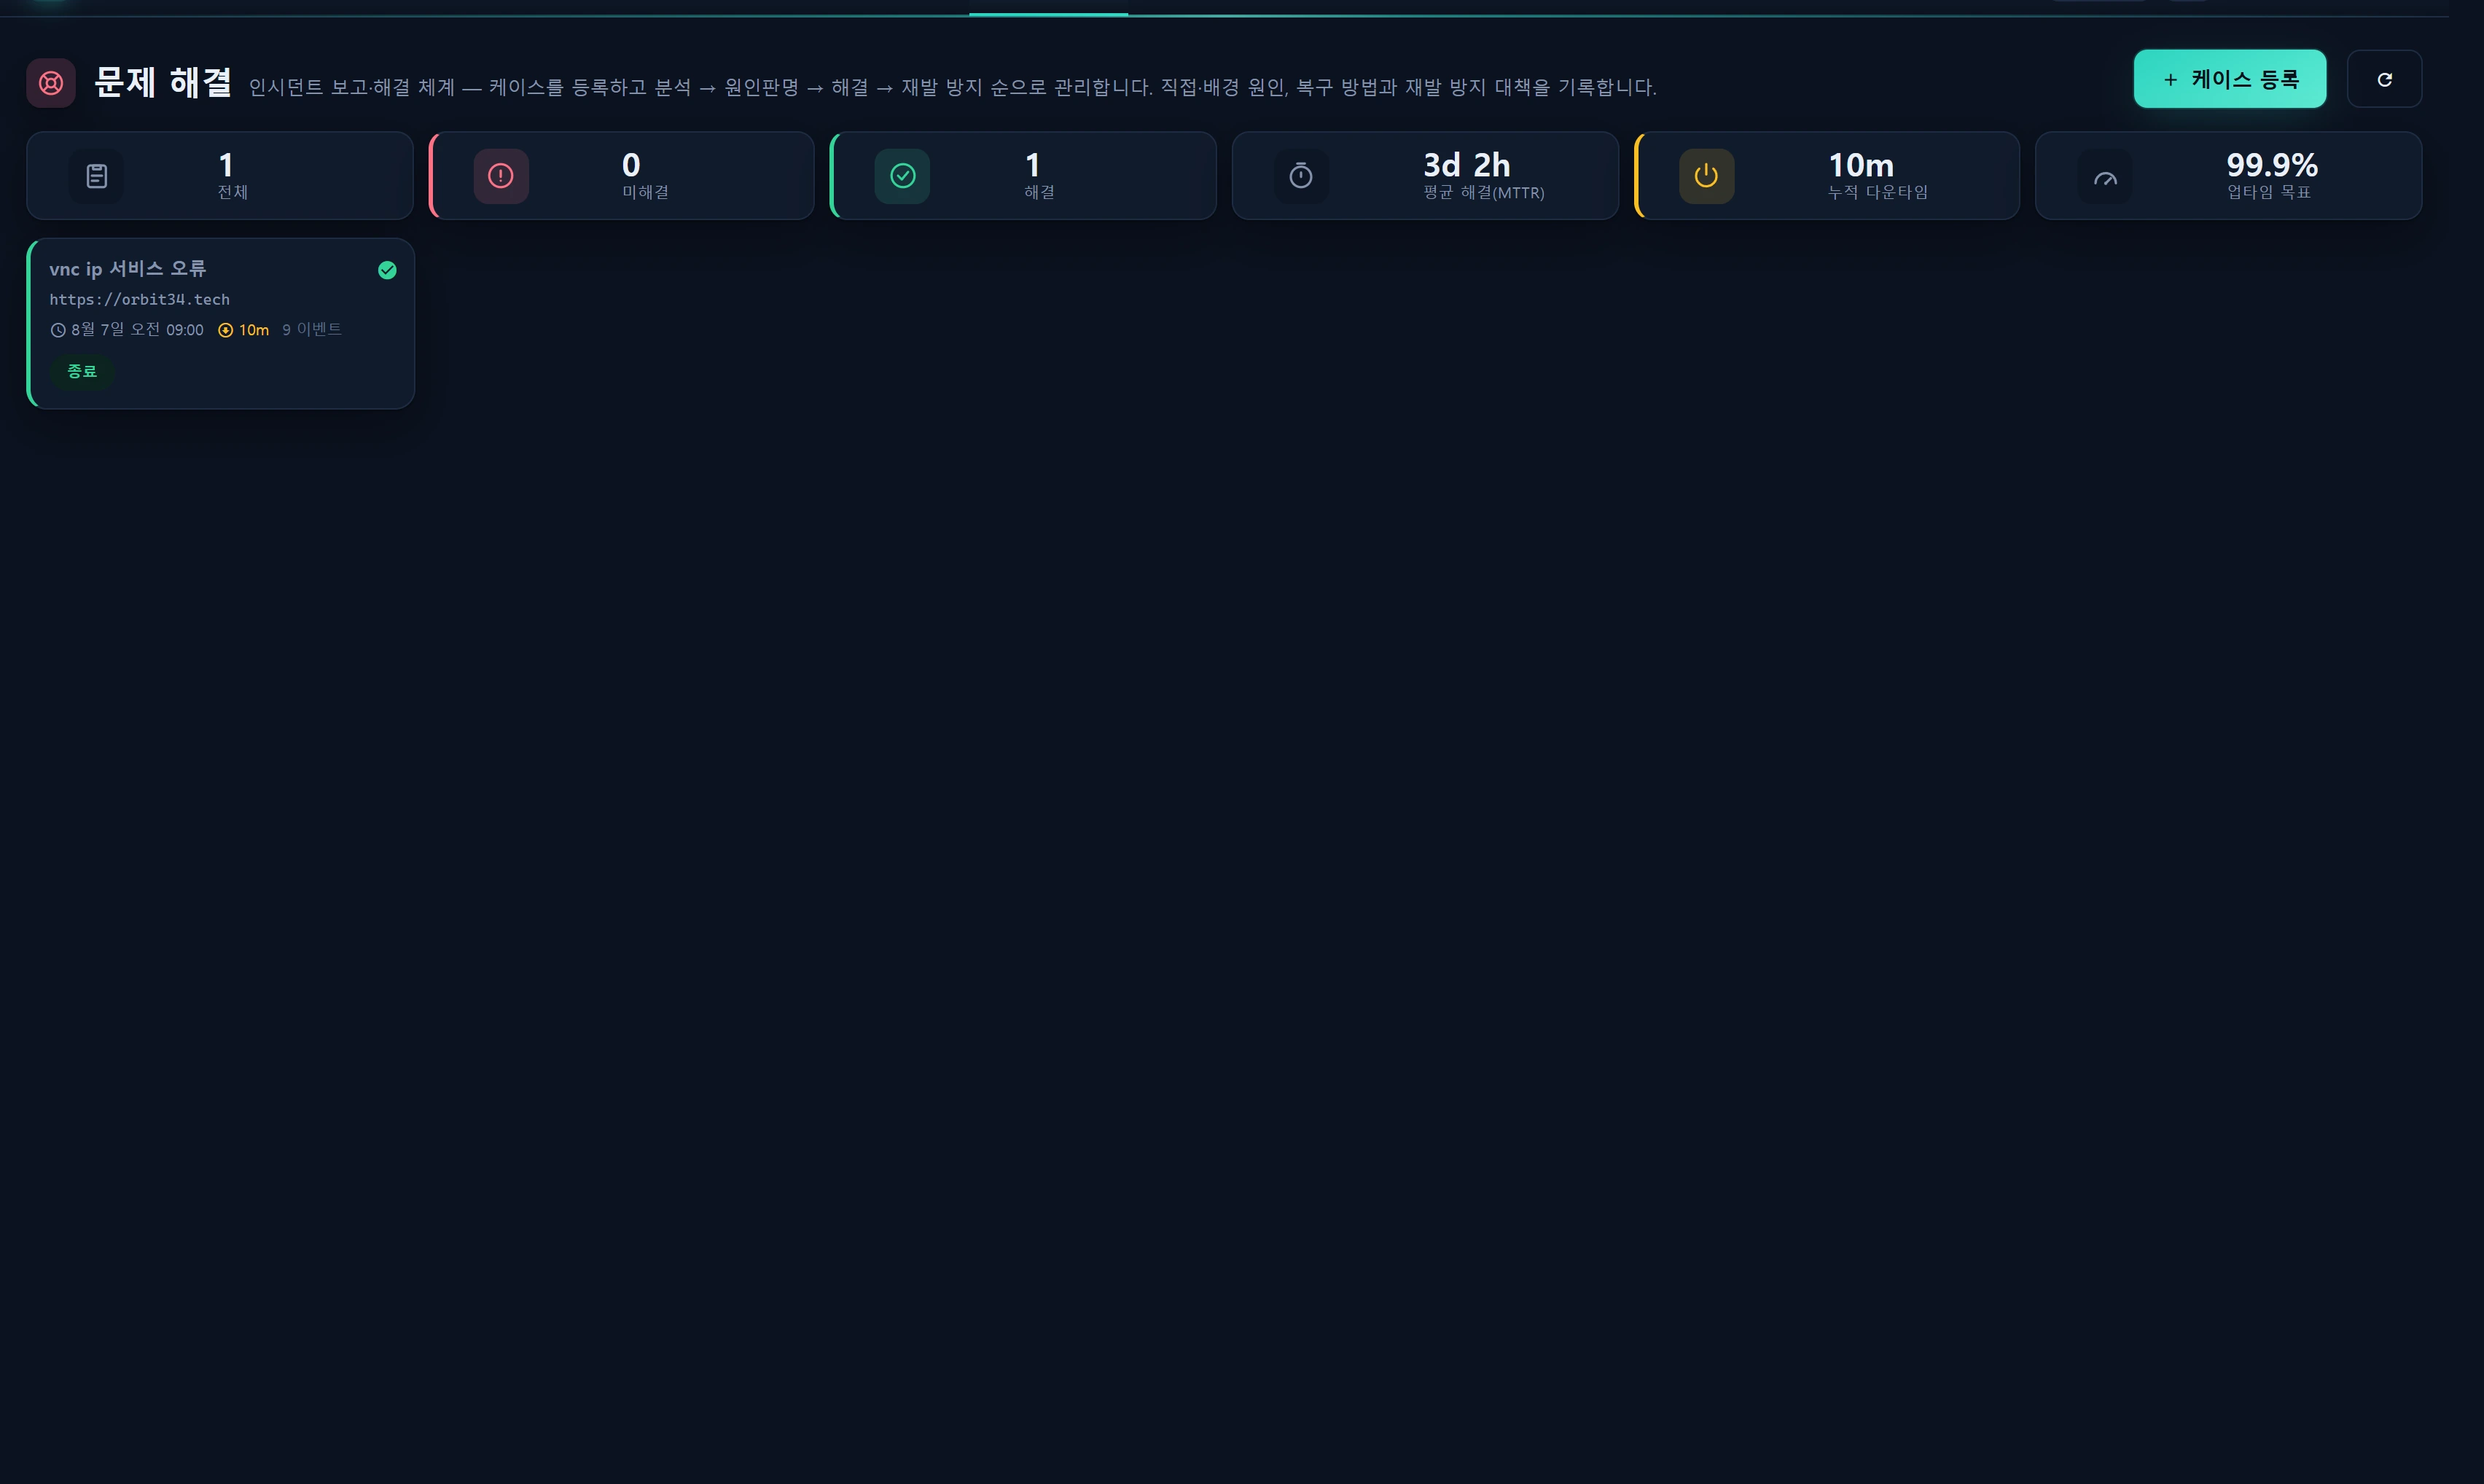
概述 — 这个页面做什么
问题处理 是服务角色区域的事件工单流程。把任何故障、错误或性能劣化登记为一个工单,沿状态流水线 登记 → 调查中 → 原因确定 → 已解决 → 已关闭 推进,并在每一步记录调查内容、原因和措施。它同时充当事后复盘与预防措施的台账。
全部数据都存放在一张表 infr_incident 中,本页面只处理 area='service' 的行。安全问题处理 页面以 area='security' 共享同一张表 — 结构完全相同,看板彼此独立。
每个工单包含四个原因/措施字段,参照正式的事后报告设计:
| 字段 | 含义 | 示例 |
|---|---|---|
direct_cause |
直接引发故障的表层诱因 | mysql 连接数超过上限(Too many connections) |
root_cause |
造成该表层原因的深层原因 | 5 分钟周期的 cron 脚本从不归还连接 → 泄漏 → 上限耗尽 |
resolution |
故障期间恢复服务所采取的措施 | 清理连接、重启进程、上调上限以立即恢复 |
action_taken |
防止再次发生的永久性修复 | 用 MAX_USER_CONNECTIONS 隔离专用账号、修补脚本、新增监控告警 |
本页面由原“SLA & Uptime”菜单更名而来(命名空间
sla→resolution)。可用率目标 KPI(uptime_target)予以保留。
何时使用
- 故障后复盘:服务宕机并恢复之后,把原因、措施和预防写下来,形成可复用的回顾材料。
- 复发跟踪:确认同一个错误是否反复出现,以及根本原因是否真的被消除。
- MTTR 与停机时长管理:把平均解决时长和累计停机时长作为指标来管理,并与可用率目标对比。
- 处理自动接入队列:当外部应用通过 Pulse/异常上报器推送错误时,这些错误会作为
source='pulse'的工单落到这里,由人工分诊并解决。
页面布局
KPI 条
顶部 KPI 基于全部 area='service' 工单计算。
| KPI | 计算方式 |
|---|---|
总计(total) |
服务工单的数量 |
处理中(active) |
open + investigating + cause_identified 之和 |
已解决(resolved) |
resolved + closed 之和 |
MTTR(mttr_min) |
(解决时间 − 发生时间)的平均值(分钟),仅统计同时具备 occurred_at 和 resolved_at 的工单 |
累计停机时长(downtime_min) |
各工单 downtime_min 字段的简单求和(分钟) |
可用率目标(uptime_target) |
运维策略中的 sla_uptime_target(默认 99.9%) |
要得到准确的 MTTR,请在工单上填写发生时间(
occurred_at),并让状态流转到“已解决”时自动打上resolved_at。没有发生时间的工单会被排除在 MTTR 平均值之外。
工单看板
工单以卡片/行的形式列出,按以下优先级在服务端排序(用 PHP 排序,以避免在控制器中写 raw SQL):
- 状态排序:
open→investigating→cause_identified→resolved→closed - 严重级别排序:
crit→warn→info - id 越新越靠前
因此处理中的、严重的、最近的工单会浮到最上面。
每张卡片显示来源徽标(手动/Pulse/告警/外部机构/隔离/由检测提升)、严重级别、状态、项目名称、发生时间、停机时长和事件数量。
详情弹窗
打开一个工单后,左侧显示报告(摘要 · 直接原因 · 根本原因 · 恢复措施 · 预防措施),右侧显示时间线(状态变更 · 备注),顶部是流水线的流转按钮。
使用方法
1) 登记工单
[Register case] → 弹出表单。创建时工单以 source='manual'、area='service'、status='open' 保存;detected_at 由服务端打戳(now()),并向时间线追加一条 created 事件。
字段与校验限制:
| 字段 | 必填 | 限制 |
|---|---|---|
title |
✔ | 最多 200 字符 |
severity |
info/warn/crit — 留空默认为 warn(运维策略 incident_default_severity) |
|
project_id |
必须存在于 infr_project |
|
service_id |
必须存在于 infr_service |
|
url |
最多 255 字符 | |
occurred_at |
日期 | |
summary |
最多 4000 字符 | |
direct_cause / root_cause / resolution / action_taken |
每项最多 4000 字符 | |
downtime_min |
整数,≥ 0 | |
impact |
最多 191 字符 |
2) 状态流转(流水线)
在详情弹窗中点击下一步按钮会打开步骤流转对话框。每个步骤都会说明“这一步该做什么”,并让你填写与该步骤相关的报告字段。只有你提交的字段才会被更新,因此你可以在不改变状态的情况下补充原因,或者仅仅充实报告。
| 步骤 | 代码 | 这一步该做什么 |
|---|---|---|
| 登记 | open |
把工单退回到受理状态(调查之前) |
| 调查中 | investigating |
确认现象、界定影响范围、撰写摘要 |
| 原因确定 | cause_identified |
判定并记录直接原因及其根本(背景)原因 |
| 已解决 | resolved |
记录所采用的恢复方法和预防措施 |
| 已关闭 | closed |
确认修复与预防措施已落实,然后关闭工单 |
流转规则:
- 流转到
resolved时,若resolved_at为空则以now()打戳(MTTR 的计算基准)。 - 流转到
closed时,可以通过与发生时间相同的 flatpickr 选择器手动填写关闭时间(closed_at)。填了就用填写的值;留空(且此前未设置)则由服务端使用now()。 - 如果状态确实发生了变化(
from !== to),会追加一条status_change事件;如果你同时在对话框中填写了备注,还会再追加一条note事件。
日期通过绑定当前界面语言(
window.__locale)的toLocaleString渲染,因此即使在 EN 模式下,月份和时间也能正确显示。
3) 协作备注
在详情弹窗中添加备注,会向时间线追加一条 kind='note' 事件(备注统一并入 infr_incident_event,没有单独的备注表)。正文最多 4000 字符。
4) 删除
删除工单会连同该事件及其关联的全部 infr_incident_event 行一并删除。此操作无法撤销。
5) 自动接入(Pulse / 异常上报器)
当外部 Laravel 应用把自己的异常推送到事件接入 API(POST /api/v1/incidents)时,IncidentIngestService 会处理它们并自动登记到本看板:
- 指纹去重:如果同一个错误已经以未结状态存在(
open/investigating/cause_identified),则不会创建新工单,只递增occurrence_count。已解决/已关闭的工单会作为新工单重新开出。 - 新工单以
source='pulse'、status='open'、entity_type='exception'创建(area不设置 → 迁移默认值service→ 在本看板可见),并追加一条created事件。 - 复发备注被限流为每 300 秒一次,以免时间线被刷屏。
- 载荷中的
level(error/warning/critical…)会映射到严重级别(warn/crit…);若传入的严重级别高于现有级别,工单会被升级。
密钥和集成代码在 管理 ▸ API 密钥 中管理。
数据来源
| 表 | 作用 |
|---|---|
infr_incident |
工单本体。本页面只查询 area='service'。迁移 000719(+ 000723 接入字段 · 000731 area · 000732 source 扩展) |
infr_incident_event |
时间线(仅追加)。kind = created/note/action/status_change/cause/resolution/alert_added。仅使用 created_at(迁移 000720) |
infr_project |
项目下拉框 · 卡片上的项目名称 |
infr_service |
服务下拉框 |
infr_audit_log |
创建/更新/流转/删除的审计轨迹 |
infr_incident 的关键列:source、area、title、severity、status、project_id、service_id、url、occurred_at、detected_at、resolved_at、closed_at、summary、direct_cause、root_cause、resolution、action_taken、downtime_min、impact、fingerprint、occurrence_count、last_occurred_at、api_key_id、created_by、updated_by。
默认值来自运维策略 OpsPolicy::slaDefaults():
sla_uptime_target         = 99.9   # SLA 目标可用率(%)
incident_default_severity = warn   # 登记时的默认严重级别(info|warn|crit)
路由:
GET  /service/resolution              index(看板)
GET  /service/resolution/live         live  (JSON 轮询刷新)
POST /service/resolution/save         登记/更新工单
POST /service/resolution/transition   状态流转(+ 分步报告/closed_at)
POST /service/resolution/note         添加协作备注
POST /service/resolution/delete       删除工单
访问权限
| 操作 | 所需级别 |
|---|---|
查看看板(index/live) |
已认证用户(infr.auth,级别 ≥ 1) |
| 登记/更新/流转/备注/删除 | 级别 ≥ 2 |
- demo (1) — 只读。任何写入尝试都会返回 403(
resolution.err.forbidden,“没有权限 — 需要级别 2 及以上”)。 - staff (5) · admin (10) — 可执行全部增删改查与状态流转。
每一次写入(登记/更新/流转/删除)都会以 incident.create / incident.update / incident.transition / incident.delete 记入 infr_audit_log,并保留操作者与变更前后的状态。级别体系详见 RBAC 级别。
故障排查与常见问题
Q. MTTR 显示为空/没有数值。
工单必须同时具备**发生时间(occurred_at)和解决时间(resolved_at)**才会计入 MTTR 平均值。请确认你填写了发生时间,并且流转到“已解决”时打上了 resolved_at。
Q. 累计停机时长显示为 0。
停机时长 KPI 是各工单 downtime_min 字段的简单求和。你必须在工单上填写停机时长(分钟);它不会根据发生时间和解决时间自动推导。
Q. 某个 Pulse 工单没有出现。
接入的工单 source='pulse' 且不设置 area,因此默认为 service 并显示在这里。如果仍然找不到,请检查:(1) API 密钥是否有效;(2) 相同指纹是否已被去重合并到某个未结工单中(只递增了 occurrence_count)。安全类事件会出现在 安全问题处理(area='security'),而不是本看板。
Q. 可以把关闭时间设为过去的时间吗?
可以。在 closed 流转对话框的关闭时间(flatpickr)字段中填入所需时间,该值就会被保存。留空则使用服务端的当前时间(now())。
Q. 我想在不改变状态的前提下补充原因。 流转对话框只更新你提交的字段。流转到同一个状态并填写报告字段,即可在不产生状态变更事件的情况下更新报告(也可以直接编辑该工单)。
Q. 删除的工单能恢复吗? 不能。删除会移除工单及其全部时间线事件,且无法撤销。删除操作本身会记录在审计日志中。
相关内容
- 安全问题处理 — 以
area='security'共享同一张infr_incident表的镜像看板。 - 事件接入 API · API 密钥 — 把外部应用的错误自动登记为
source='pulse'工单。 - 项目 — 工单所关联的项目登记册。
- 服务概览 — 实时服务运维(为未结事件 KPI 提供数据)。
- 可观测性(Pulse/Horizon) — 异常采集流水线的背景知识。