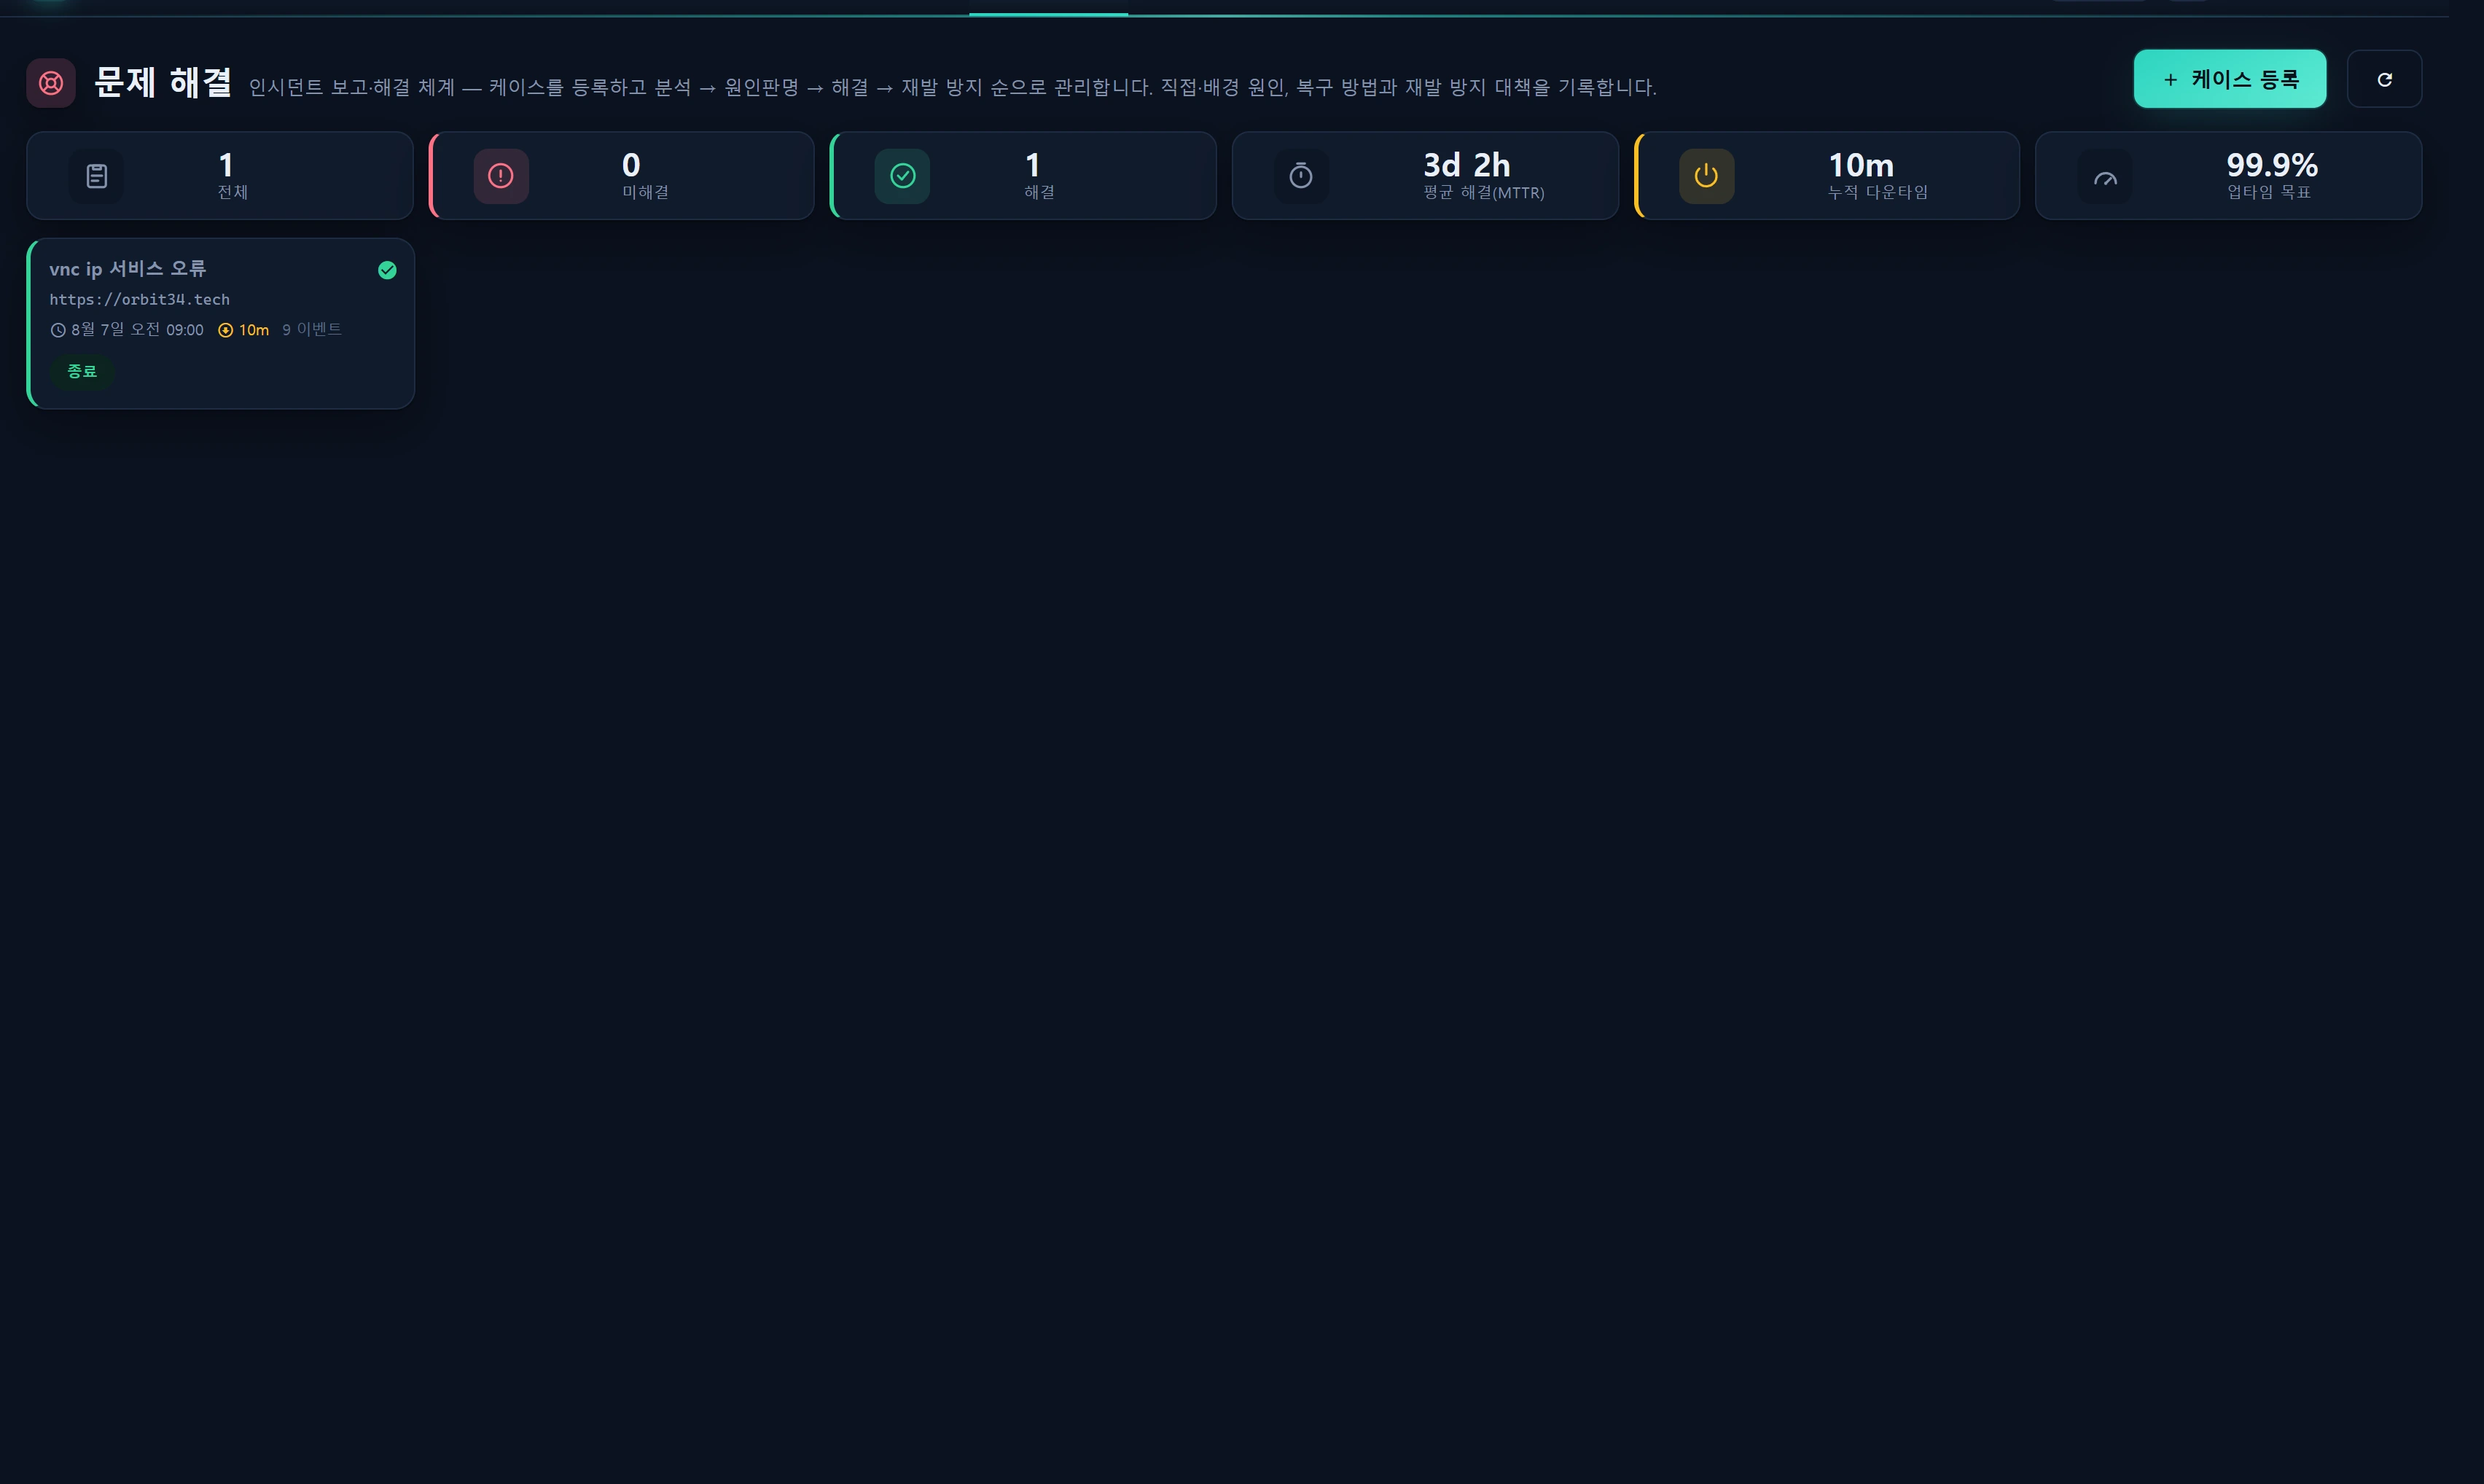
Vue d’ensemble — à quoi sert cet écran
Résolution des problèmes est le flux de travail de cas d’incident du domaine de rôle Service. Enregistrez toute panne, erreur ou dégradation sous la forme d’un cas unique et faites-le progresser le long de la chaîne d’états enregistrement → en investigation → cause identifiée → résolu → clos, en consignant l’investigation, la cause et l’action à chaque étape. L’écran fait aussi office de registre de post-mortems et d’actions préventives.
Toutes les données résident dans une seule table, infr_incident, et cet écran ne traite que les lignes portant area='service'. L’écran Résolution des problèmes de sécurité partage la même table avec area='security' — schéma identique, tableau distinct.
Chaque cas comporte quatre champs de cause/action calqués sur un rapport post-mortem formel :
| Champ | Signification | Exemple |
|---|---|---|
direct_cause |
Le déclencheur apparent de la panne | limite de connexions mysql dépassée (Too many connections) |
root_cause |
La raison sous-jacente qui a produit la cause apparente | un script cron de 5 minutes ne rendait jamais les connexions → fuite → limite épuisée |
resolution |
Action qui a rétabli le service pendant l’incident | connexions purgées, processus redémarré, limite relevée pour une reprise immédiate |
action_taken |
Correctif permanent pour éviter la récidive | compte dédié isolé avec MAX_USER_CONNECTIONS, script corrigé, alerte de supervision ajoutée |
Cet écran a été renommé à partir de l’ancien menu « SLA & Uptime » (espace de noms
sla→resolution). L’indicateur d’objectif de disponibilité (uptime_target) est conservé.
Quand l’utiliser
- Compte rendu post-incident : après qu’un service est tombé puis revenu, consignez la cause, le correctif et la prévention comme une rétrospective réutilisable.
- Suivi des récidives : vérifier si la même erreur continue de se produire et si la cause profonde a réellement été supprimée.
- Gestion du MTTR et des temps d’indisponibilité : piloter en tant qu’indicateurs le temps moyen de résolution et le cumul d’indisponibilité, et les comparer à votre objectif de disponibilité.
- Traitement de la file d’admission automatique : lorsque des applications externes poussent leurs erreurs via Pulse ou le rapporteur d’exceptions, celles-ci arrivent ici sous forme de cas
source='pulse'qu’un humain doit trier et résoudre.
Disposition
Bandeau d’indicateurs
Les indicateurs du haut sont calculés sur l’ensemble des cas area='service'.
| Indicateur | Mode de calcul |
|---|---|
Total (total) |
Nombre de cas de service |
Actifs (active) |
Somme de open + investigating + cause_identified |
Résolus (resolved) |
Somme de resolved + closed |
MTTR (mttr_min) |
Moyenne de (résolution − survenue) en minutes, uniquement pour les cas disposant À LA FOIS de occurred_at et de resolved_at |
Indisponibilité cumulée (downtime_min) |
Simple somme du champ downtime_min de chaque cas (en minutes) |
Objectif de disponibilité (uptime_target) |
sla_uptime_target de la Politique d’exploitation (99.9% par défaut) |
Pour obtenir un MTTR exact, saisissez une heure de survenue (
occurred_at) sur le cas et laissez la transition vers Résolu horodaterresolved_atautomatiquement. Un cas sans heure de survenue est exclu de la moyenne du MTTR.
Tableau des cas
Les cas sont listés sous forme de cartes/lignes, triés côté serveur (en PHP, afin d’éviter le SQL brut dans le contrôleur) selon cette priorité :
- Rang d’état :
open→investigating→cause_identified→resolved→closed - Rang de gravité :
crit→warn→info - Identifiant le plus récent en premier
Les cas actifs, graves et récents remontent donc en haut.
Chaque carte affiche le badge d’origine (manuel / Pulse / alerte / organisme / quarantaine / promu depuis une détection), la gravité, l’état, le nom du projet, l’heure de survenue, l’indisponibilité et le nombre d’événements.
Fenêtre de détail
L’ouverture d’un cas affiche le Rapport à gauche (résumé · cause directe · cause profonde · remise en service · action préventive) et la Chronologie à droite (changements d’état · notes), avec les boutons de transition de la chaîne en haut.
Mode d’emploi
1) Enregistrer un cas
[Register case] → formulaire modal. À la création, le cas est enregistré avec source='manual', area='service', status='open' ; detected_at est horodaté côté serveur (now()) et un événement created est ajouté à la chronologie.
Champs et limites de validation :
| Champ | Obligatoire | Limite |
|---|---|---|
title |
✔ | 200 caractères max. |
severity |
info/warn/crit — vide, la valeur par défaut est warn (Politique d’exploitation incident_default_severity) |
|
project_id |
doit exister dans infr_project |
|
service_id |
doit exister dans infr_service |
|
url |
255 caractères max. | |
occurred_at |
date | |
summary |
4000 caractères max. | |
direct_cause / root_cause / resolution / action_taken |
4000 caractères max. chacun | |
downtime_min |
entier, ≥ 0 | |
impact |
191 caractères max. |
2) Transition d’état (chaîne)
Dans la fenêtre de détail, cliquer sur un bouton d’étape suivante ouvre une boîte de dialogue de transition d’étape. Chaque étape explique « ce qu’il faut faire à cette étape » et vous laisse renseigner les champs du rapport pertinents pour cette étape. Seuls les champs que vous envoyez sont mis à jour, ce qui vous permet d’enrichir les causes sans changer d’état, ou d’étoffer uniquement le rapport.
| Étape | Code | Ce qu’il faut faire à cette étape |
|---|---|---|
| Enregistrement | open |
Renvoyer le cas en file d’admission (avant investigation) |
| En investigation | investigating |
Confirmer les symptômes, délimiter l’impact, rédiger le résumé |
| Cause identifiée | cause_identified |
Déterminer et consigner la cause directe et sa cause profonde (de fond) |
| Résolu | resolved |
Consigner la méthode de reprise appliquée et l’action préventive |
| Clos | closed |
Vérifier que le correctif et la prévention sont en place, puis clore le cas |
Règles de transition :
- Le passage à
resolvedhorodateresolved_atavecnow()si le champ est vide (la base du MTTR). - Le passage à
closedvous permet de saisir manuellement une heure de clôture (closed_at) via le même sélecteur flatpickr que pour l’heure de survenue. Si vous fournissez une valeur, elle est utilisée ; si le champ reste vide (et n’est pas déjà renseigné), le serveur utilisenow(). - Si l’état change réellement (
from !== to), un événementstatus_changeest ajouté ; si vous saisissez également une note dans la boîte de dialogue, un événementnoteest ajouté lui aussi.
Les dates sont rendues via
toLocaleStringlié à la langue active de l’interface (window.__locale), de sorte que le mois et l’heure s’affichent correctement même en mode EN.
3) Notes de collaboration
Ajouter une note dans la fenêtre de détail ajoute un événement kind='note' à la chronologie (les notes sont regroupées dans infr_incident_event — il n’existe pas de table de notes distincte). Corps de 4000 caractères max.
4) Suppression
Supprimer un cas supprime l’incident et toutes ses lignes infr_incident_event associées d’un seul tenant. Cette opération est irréversible.
5) Admission automatique (Pulse / rapporteur d’exceptions)
Lorsqu’une application Laravel externe pousse ses exceptions vers l’API d’ingestion d’incidents (POST /api/v1/incidents), IncidentIngestService les traite et les inscrit automatiquement sur ce tableau :
- Déduplication par empreinte : si la même erreur existe déjà dans un état ouvert (
open/investigating/cause_identified), aucun nouveau cas n’est créé — seuloccurrence_countest incrémenté. Les cas résolus ou clos sont rouverts en tant que nouveaux cas. - Les nouveaux cas sont créés avec
source='pulse',status='open',entity_type='exception'(avecareanon défini → la valeur par défaut de la migrationservice→ visible sur ce tableau), et un événementcreatedest ajouté. - Les notes de récidive sont limitées à une toutes les 300 secondes afin que la chronologie ne soit pas saturée.
- Le
levelde la charge utile (error/warning/critical…) est mis en correspondance avec la gravité (warn/crit…) ; si une gravité entrante est supérieure à l’existante, le cas est escaladé.
Les clés et le code d’intégration se gèrent dans Administration ▸ Clés API.
Sources de données
| Table | Rôle |
|---|---|
infr_incident |
Le cas lui-même. Cet écran n’interroge que area='service'. Migration 000719 (+ 000723 champs d’ingestion · 000731 area · 000732 extension de source) |
infr_incident_event |
Chronologie (en ajout seul). kind = created/note/action/status_change/cause/resolution/alert_added. N’utilise que created_at (migration 000720) |
infr_project |
Liste déroulante des projets · nom du projet sur la carte |
infr_service |
Liste déroulante des services |
infr_audit_log |
Piste d’audit pour la création/modification/transition/suppression |
Colonnes clés de infr_incident : source, area, title, severity, status, project_id, service_id, url, occurred_at, detected_at, resolved_at, closed_at, summary, direct_cause, root_cause, resolution, action_taken, downtime_min, impact, fingerprint, occurrence_count, last_occurred_at, api_key_id, created_by, updated_by.
Les valeurs par défaut proviennent de la Politique d’exploitation OpsPolicy::slaDefaults() :
sla_uptime_target         = 99.9   # disponibilité cible du SLA (%)
incident_default_severity = warn   # gravité par défaut à l’enregistrement (info|warn|crit)
Routes :
GET  /service/resolution              index (tableau)
GET  /service/resolution/live         live  (rafraîchissement par sondage JSON)
POST /service/resolution/save         enregistrer / mettre à jour un cas
POST /service/resolution/transition   transition d’état (+ rapport par étape / closed_at)
POST /service/resolution/note         ajouter une note de collaboration
POST /service/resolution/delete       supprimer un cas
Accès
| Action | Niveau requis |
|---|---|
Consulter le tableau (index/live) |
Utilisateur authentifié (infr.auth, niveau ≥ 1) |
| Enregistrer / modifier / faire transiter / annoter / supprimer | niveau ≥ 2 |
- demo (1) — lecture seule. Toute tentative d’écriture renvoie 403 (
resolution.err.forbidden, « pas d’autorisation — niveau 2 ou supérieur requis »). - staff (5) · admin (10) — CRUD et transitions complets.
Chaque écriture (enregistrement/modification/transition/suppression) est consignée dans infr_audit_log sous incident.create / incident.update / incident.transition / incident.delete, avec l’auteur et l’état avant/après. Voir Niveaux RBAC pour le modèle de niveaux.
Dépannage et FAQ
Q. Le MTTR est vide / sans valeur.
Un cas doit posséder À LA FOIS une heure de survenue (occurred_at) et une heure de résolution (resolved_at) pour être inclus dans la moyenne du MTTR. Vérifiez que vous avez saisi l’heure de survenue et que la transition vers Résolu a bien horodaté resolved_at.
Q. L’indisponibilité cumulée affiche 0.
L’indicateur d’indisponibilité est une simple somme du champ downtime_min de chaque cas. Vous devez saisir l’indisponibilité (en minutes) sur le cas ; elle n’est pas déduite automatiquement des heures de survenue et de résolution.
Q. Un cas Pulse n’apparaît pas.
Les cas ingérés portent source='pulse' et laissent area non défini ; ils prennent donc la valeur par défaut service et apparaissent ici. S’il en manque toujours un, vérifiez (1) si la clé API est valide et (2) si la même empreinte a été dédupliquée dans un cas déjà ouvert (seul occurrence_count a été incrémenté). Les incidents de sécurité apparaissent dans Résolution des problèmes de sécurité (area='security'), et non sur ce tableau.
Q. Puis-je fixer l’heure de clôture dans le passé ?
Oui. Saisissez l’heure souhaitée dans le champ d’heure de clôture (flatpickr) de la boîte de dialogue de transition closed : cette valeur sera enregistrée. Laissez-le vide pour utiliser l’heure courante du serveur (now()).
Q. Je veux enrichir les causes sans changer d’état. La boîte de dialogue de transition ne met à jour que les champs que vous envoyez. Effectuer une transition vers le même état tout en renseignant les champs du rapport met à jour le rapport sans événement de changement d’état (ou modifiez le cas directement).
Q. Un cas supprimé peut-il être restauré ? Non. La suppression retire le cas et tous ses événements de chronologie, et elle est irréversible. L’action de suppression elle-même est consignée dans le journal d’audit.
Voir aussi
- Résolution des problèmes de sécurité — tableau miroir partageant la même table
infr_incidentavecarea='security'. - API d’ingestion d’incidents · clés API — inscrire automatiquement les erreurs des applications externes en tant que cas
source='pulse'. - Projets — le registre de projets auquel vous rattachez les cas.
- Vue d’ensemble des services — exploitation des services en direct (alimente l’indicateur d’incidents non résolus).
- Observabilité (Pulse/Horizon) — contexte sur la chaîne de collecte des exceptions.