概要 — 何をする画面か
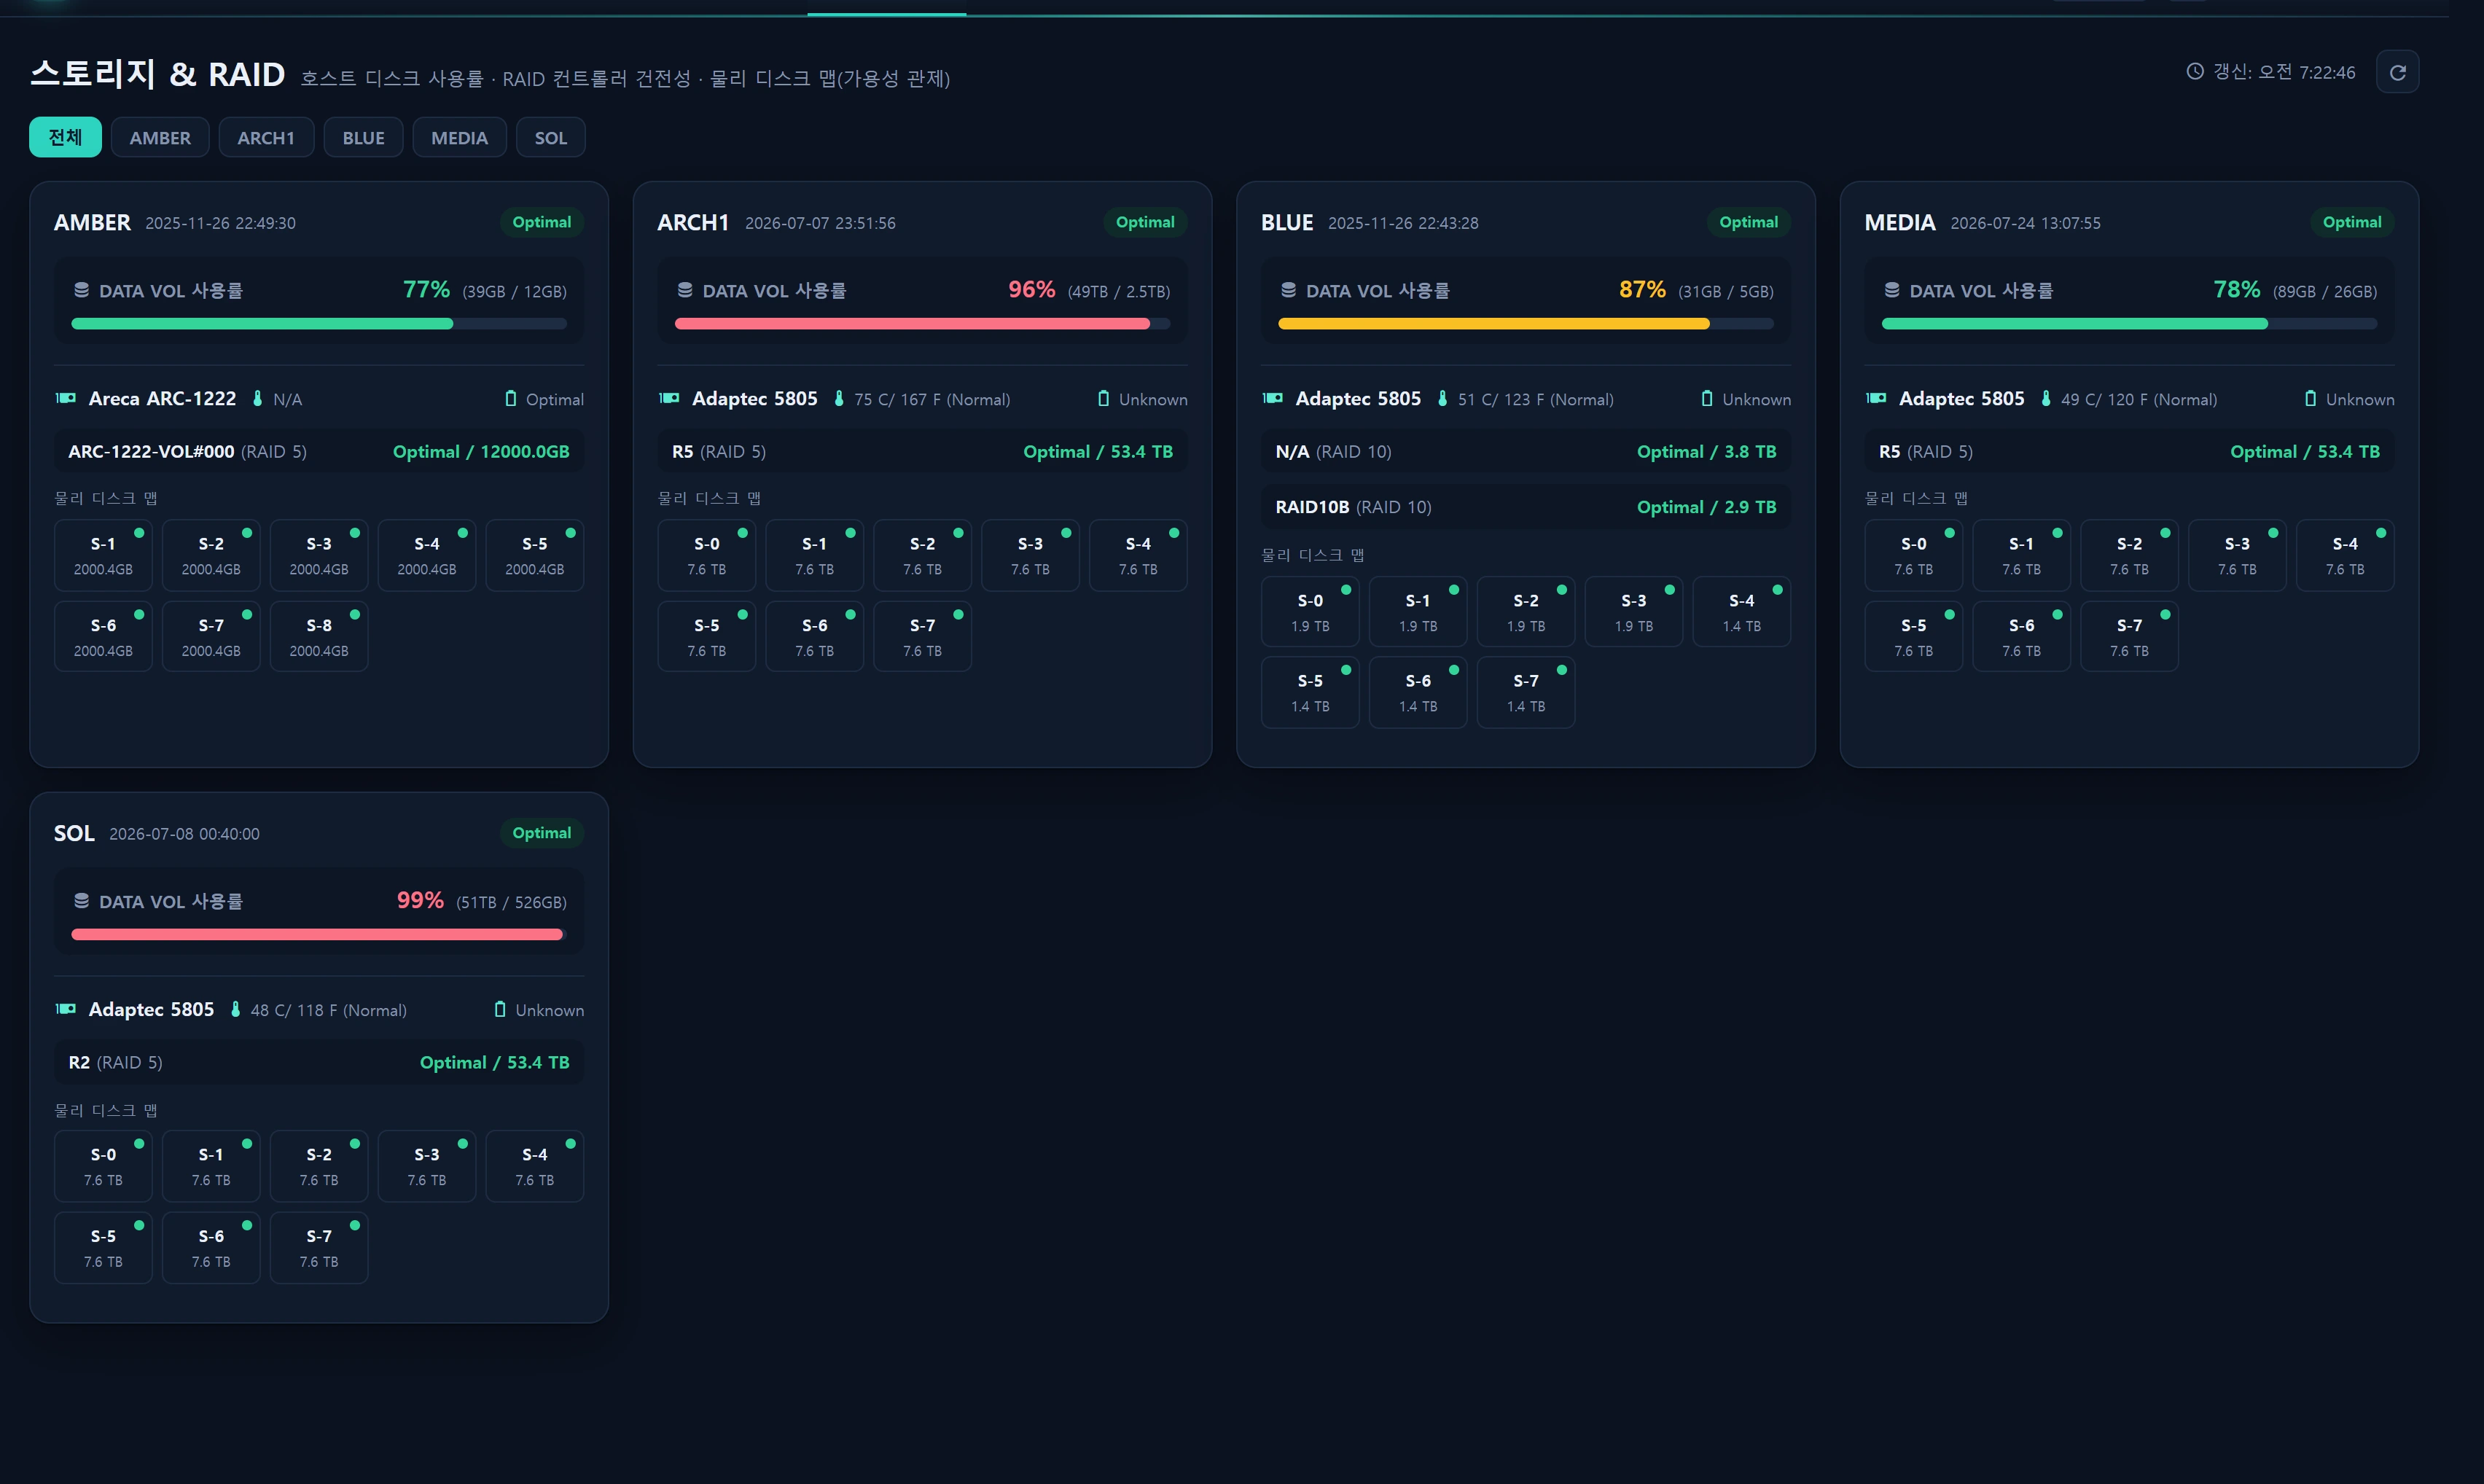
インフラ ▸ ストレージ・RAID(/infra/storage)は、各ホストのストレージ健全性を1画面に集約する読み取り専用の可用性ダッシュボードです。2種類のテレメトリをカードに組み立てます。
- RAID コントローラーの健全性 — レガシーの
storage_status.json_data(Adaptecarcconf収集の出力)から取得します。コントローラーの状態(Optimal/Degraded/Failed)、温度、バッテリー状態、論理ボリューム(RAID レベル・状態・サイズ)、そして物理ディスクマップ(スロットごとの状態・モデル・シリアル・サイズ)です。 - データボリュームのディスク使用率 — レガシーの
server_statusにあるdf-*スナップショットから取得し、データボリュームの使用率・使用量・空き容量をカード上部に表示します。
中核となる目的はディスク障害の早期警告です。RAID アレイが Degraded に落ちたり、物理ディスクが Failed/Missing になったりすると、色(アンバー/レッド)で即座に見て取れるため、2本目のディスクが故障してアレイ全体が崩壊する前に、交換とリビルドを行えます。
この画面が扱うのはライブ状態(現時点の健全性)だけです。ストレージの資産台帳(機器メタデータ、容量計画、ファイル領域ツリー)は 資産 ▸ ストレージ・ファイル が所有します。両者は意図的に分離されています(データソースを参照)。
利用シーン
- 定例の巡回で、全ノードの RAID 状態を一目で把握するとき。
- サーバーの反応が鈍いときや I/O の警告が出たときに、ディスクの空き容量とアレイ状態を素早くトリアージするとき。
- ディスク交換の前後に、スロットマップでリビルドの進捗/完了を目視確認するとき。
- インフラ ▸ 警報 でディスク空き容量の警報が発火し、どのボリュームが影響を受けているかを掘り下げる必要があるとき。
レイアウト
ヒーロー・コントロールバー
- タイトル/サブタイトル + 更新時刻(
Updated: HH:MM:SS)+ 更新ボタン(手動ポーリング)。 - ホストフィルターバー —
Allに加えて、ホストごとに1つずつボタンが並びます。ホストを選ぶとそのホストに絞り込まれ、1ページ目に戻ります。
ストレージカード
カードはホストごとに1枚描画されます。
| 領域 | 内容 |
|---|---|
| ヘッダー | ホスト名・最終更新時刻・RAID サマリーバッジ(status_summary) |
| 使用率 | DATA VOL usage ラベル + パーセント + (used / available) + トラックバー |
| コントローラー | アイコン + モデル・温度・バッテリー状態 |
| 論理ボリューム | name (RAID level) + 状態 / size |
| 物理ディスクマップ | スロットチップ(S-{slot} + サイズ)、状態ごとの色、ツールチップは model · serial · status |
コントローラー情報がない場合、カードは No controller data を表示します。カードが1枚もない場合は No storage data. を表示します。一覧は1ページ10件でページングします。
状態の色ルール
RAID サマリー・論理ボリュームの状態(raid_tone):
| 含む文字列 | 色 | 意味 |
|---|---|---|
optimal |
good(緑) | 正常 |
degrad |
warn(アンバー) | 劣化 — ディスク1本が故障、リビルドが必要 |
fail |
crit(赤) | RAID 障害 — データが危険な状態 |
| その他 | muted(グレー) | 不明 |
物理ディスクの状態(disk_tone):
| 含む文字列 | 色 | 意味 |
|---|---|---|
online / optimal |
good | 正常 |
rebuild |
warn | リビルド進行中 |
fail / missing |
crit | 故障/脱落 |
| その他 | muted | 不明 |
ディスク使用率(usage_tone):
| 使用率 | 色 |
|---|---|
| 95% 以上 | crit |
| 80% 以上 | warn |
| 80% 未満 | good |
使い方
- メニューから インフラ ▸ ストレージ・RAID を開きます。
- 上部のホストフィルターで1台のサーバーに絞り込むか、
Allを表示します。 - まず各カードのヘッダーにある RAID バッジを走査し、アンバー/レッドのカードを優先します。
- 問題のあるカードでは、物理ディスクマップを読み、どのスロットが
Failed/Missing/Rebuildかを特定します。チップにカーソルを合わせると、モデルとシリアルのツールチップが表示されます。 - 使用率バーを確認し、データボリュームが 80%/95% のしきい値に近づいていないかを見ます。
- データが古いと感じたら、右上の更新をクリックします。
このページは自動ポーリングしません。表示されるデータはサーバー側の30秒キャッシュを経由し、画面が更新されるのは更新ボタンを押したとき(
/infra/storage/liveに再問い合わせします)だけです。開いたままで推移を見る場合は、定期的に更新を押してください。
データソース
どちらのテーブルもレガシー MySQL(legacy 接続、読み取り専用)から取得します。アプリがこれらに書き込むことはありません。
| テーブル | 内容 | 供給元 |
|---|---|---|
storage_status |
host、status_summary、json_data(controllers/logical_volumes/disks)、created_at |
sync_adp.js(Adaptec arcconf) |
server_status |
df-* part のスナップショット → ディスク使用率 |
run_report.js |
json_data の形(例)
{
  "controllers": [
    {
      "model": "Adaptec ASR-5805",
      "temperature": "41C",
      "battery_status": "Optimal",
      "status": "Optimal",
      "logical_volumes": [
        { "name": "Data", "raid_level": "6", "status": "Optimal", "size": "10.9TB" }
      ],
      "disks": [
        { "slot": 0, "status": "Online", "model": "ST4000NM0033", "serial": "Z1Z00000", "size": "3.6TB" }
      ]
    }
  ]
}
df-* の値の形
server_status.value は p(パーセント)・u(使用量)・a(空き容量)を持つ JSON です。
{ "p": 72, "u": "7.2T", "a": "2.8T" }
ホスト ↔ エイリアスのマッピング
使用率は、storage_status.host(大文字のラベル)から server_status.server_alias(小文字)への静的マップで結合されます。マップに存在しないホストは、小文字化したホスト名にフォールバックします。
| host | alias | host | alias | |
|---|---|---|---|---|
| AMBER | am | ART | art | |
| MEDIA | media | BUD | bud | |
| ARCH1 | arch1 | GLORY | glory | |
| SOL | sol | DOCU | documents | |
| BLUE | blue | DNS_SERVER | demo |
seq ウィンドウクエリ — 低速スキャンの回避
server_status は大規模な時系列です。テーブル全体を MAX(seq) … GROUP BY server_alias, part で集計するとフルスキャンが発生します。そこでビルダー(StorageStatusService::dfUsageByAlias)は、インデックス経由で直近3件の seq 値だけを取得し、その seq に含まれる df-* の行だけを読みます。
-- 1) 直近3件の seq 値(seq インデックス → O(log N))
SELECT DISTINCT seq FROM server_status ORDER BY seq DESC LIMIT 3;

-- 2) それらの seq に含まれる df-* の行のみ(古い→新しい、後の行が勝つ)
SELECT server_alias, part, value
  FROM server_status
 WHERE seq IN (?, ?, ?) AND part LIKE 'df-%'
 ORDER BY seq;
エイリアスごとに df-data part を優先し、存在しない場合は使用率が最も高いボリューム(p が最大のもの)を代表値として使います。
最新の RAID 行も同様に、ホストごとの最新行へ絞り込まれます。
SELECT MAX(id) AS mid FROM storage_status GROUP BY host;   -- ホストごとの最新
SELECT * FROM storage_status WHERE id IN (?, ...) ORDER BY host;
結果は
infr:infra:storage:v1というキーで30秒間キャッシュされます。これによりレガシー DB への往復を抑え、同時閲覧を吸収します。レガシー DB に到達できない場合、ビルダーは例外を握りつぶして空配列を返すため、画面はNo storage data.へ穏当に縮退します。
アクセス権限
- 閲覧: 認証済みのすべてのユーザー(インフラ領域の最小
user_level1 = demo)が閲覧できます。ルートはinfr.authグループにあります。 - 書き込みなし: この画面は完全に読み取り専用です。RAID/ディスクの状態を変更したり、アレイを操作したりするアクションはありません(交換・リビルドは対象ホスト上で SE が行います)。
- ストレージの資産の作成・編集(機器メタデータ、ファイル領域)は、別画面の 資産 ▸ ストレージ・ファイル で行い、その書き込みには
user_level2 以上が必要です。
トラブルシューティングと FAQ
Q. カードは表示されるのに、使用率(DATA VOL)が空です。
そのホストの alias が、直近の seq ウィンドウ内のどの df-* データとも一致しませんでした。そのノードで run_report.js が稼働しているか、ホスト↔エイリアスのマッピングが正しいかを確認してください。このマッピングは静的マップであり、管理 ▸ コレクター の run_report 設定とは別物です。
Q. ディスクマップ/コントローラーが「No controller data」と表示されます。
storage_status.json_data の controllers 配列が空か、パースに失敗しています。そのホストに Adaptec RAID が搭載されていないか、sync_adp.js(arcconf)の収集が失敗している可能性があります。arcconf のパスと権限を確認してください。
Q. すべてが「No storage data.」と表示されます。
レガシー DB の接続失敗か、storage_status に行がありません。ビルダーは例外時に空配列を返します。legacy 接続(.env の DB_*)とコレクターの健全性を確認してください。
Q. 値が数分前と同じままです。
(1) このページは自動ポーリングしません — 更新を押してください。(2) サーバーキャッシュは30秒間保持されます。(3) 根本的に、コレクター(sync_adp.js、run_report.js)は Laravel の外でスケジュール実行されるため、ソースの鮮度は cron の周期に依存します。
Q. Degraded バッジが出ました — どうすればよいですか。
物理ディスクマップで Failed/Missing のスロットを見つけ、そのディスクを交換し、コントローラーが自動的に Rebuild を開始することを確認します。リビルド中のアレイは二重障害に対して脆弱なので、バックアップ体制もあわせて確認してください(バックアップ ▸ スケジュールボード)。
関連項目
- インフラ ▸ ヘルス — ノードごとの CPU・メモリ・ディスク・サービスのライブ状態。
- インフラ ▸ サーバー — サーバーごとの負荷の時系列。
- インフラ ▸ 警報 — ディスク空き容量/RAID 状態の警報ポリシー。
- 資産 ▸ ストレージ・ファイル — ストレージ資産台帳とファイル領域ツリー(書き込み)。
- 管理 ▸ コレクター —
sync_adp.jsとrun_report.jsのコレクターレジストリ。