개요 — 무엇을 하나
문제 해결(Problem Resolution) 은 Service 역할 영역의 인시던트 케이스 워크플로우입니다. 장애·오류·성능 저하를 하나의 케이스로 등록하고, 상태 파이프라인을 따라 등록 → 분석 → 원인판명 → 해결 → 종료 순으로 관리하며, 각 단계에서 조사 내용·원인·조치를 구조화해 남깁니다. 사후 회고(post-mortem)와 재발 방지 대장 역할을 합니다.
핵심 데이터는 infr_incident 테이블 한 곳에 저장되며, 이 화면은 그중 area='service' 행만 다룹니다. 같은 테이블을 보안 문제 해결 화면이 area='security' 로 공유합니다 — 스키마는 동일하지만 보드가 분리됩니다.
케이스에는 500 리포트(사후 보고서)에 준하는 4개 원인·조치 필드가 있습니다.
| 필드 | 의미 | 예시 |
|---|---|---|
direct_cause (직접적 원인) |
장애를 즉시 유발한 표면 원인 | mysql 연결 한도 초과 (Too many connections) |
root_cause (배경적 원인) |
그 표면 원인을 만든 근본 배경 | 5분 주기 스크립트가 연결을 반환하지 않아 누수 → 한도 고갈 |
resolution (해결) |
장애 중 서비스를 복구한 조치 | 연결 정리·프로세스 재시작·한도 상향으로 즉시 복구 |
action_taken (재발 방지) |
향후 재발을 막는 항구 대책 | 전용 계정 MAX_USER_CONNECTIONS 격리, 스크립트 수정, 경보 추가 |
이 화면은 옛 "SLA & Uptime · 가동률" 메뉴에서 개명된 것입니다(네임스페이스
sla→resolution). 업타임 목표 KPI(uptime_target)는 유지됩니다.
언제 쓰나
- 장애 사후 정리: 서비스가 다운되었다가 복구된 뒤, 원인·조치·재발 방지를 남겨 회고 자료로 쌓을 때.
- 재발 추적: 같은 오류가 반복되는지, 근본 원인이 실제로 제거되었는지 확인할 때.
- MTTR·다운타임 관리: 평균 해결 시간과 누적 다운타임을 지표로 관리하고 업타임 목표와 비교할 때.
- 자동 유입 처리: 외부 애플리케이션이 Pulse/예외 리포터로 보낸 오류가
source='pulse'케이스로 자동 등재되면, 그 큐를 사람이 분류·해결할 때.
화면 구성
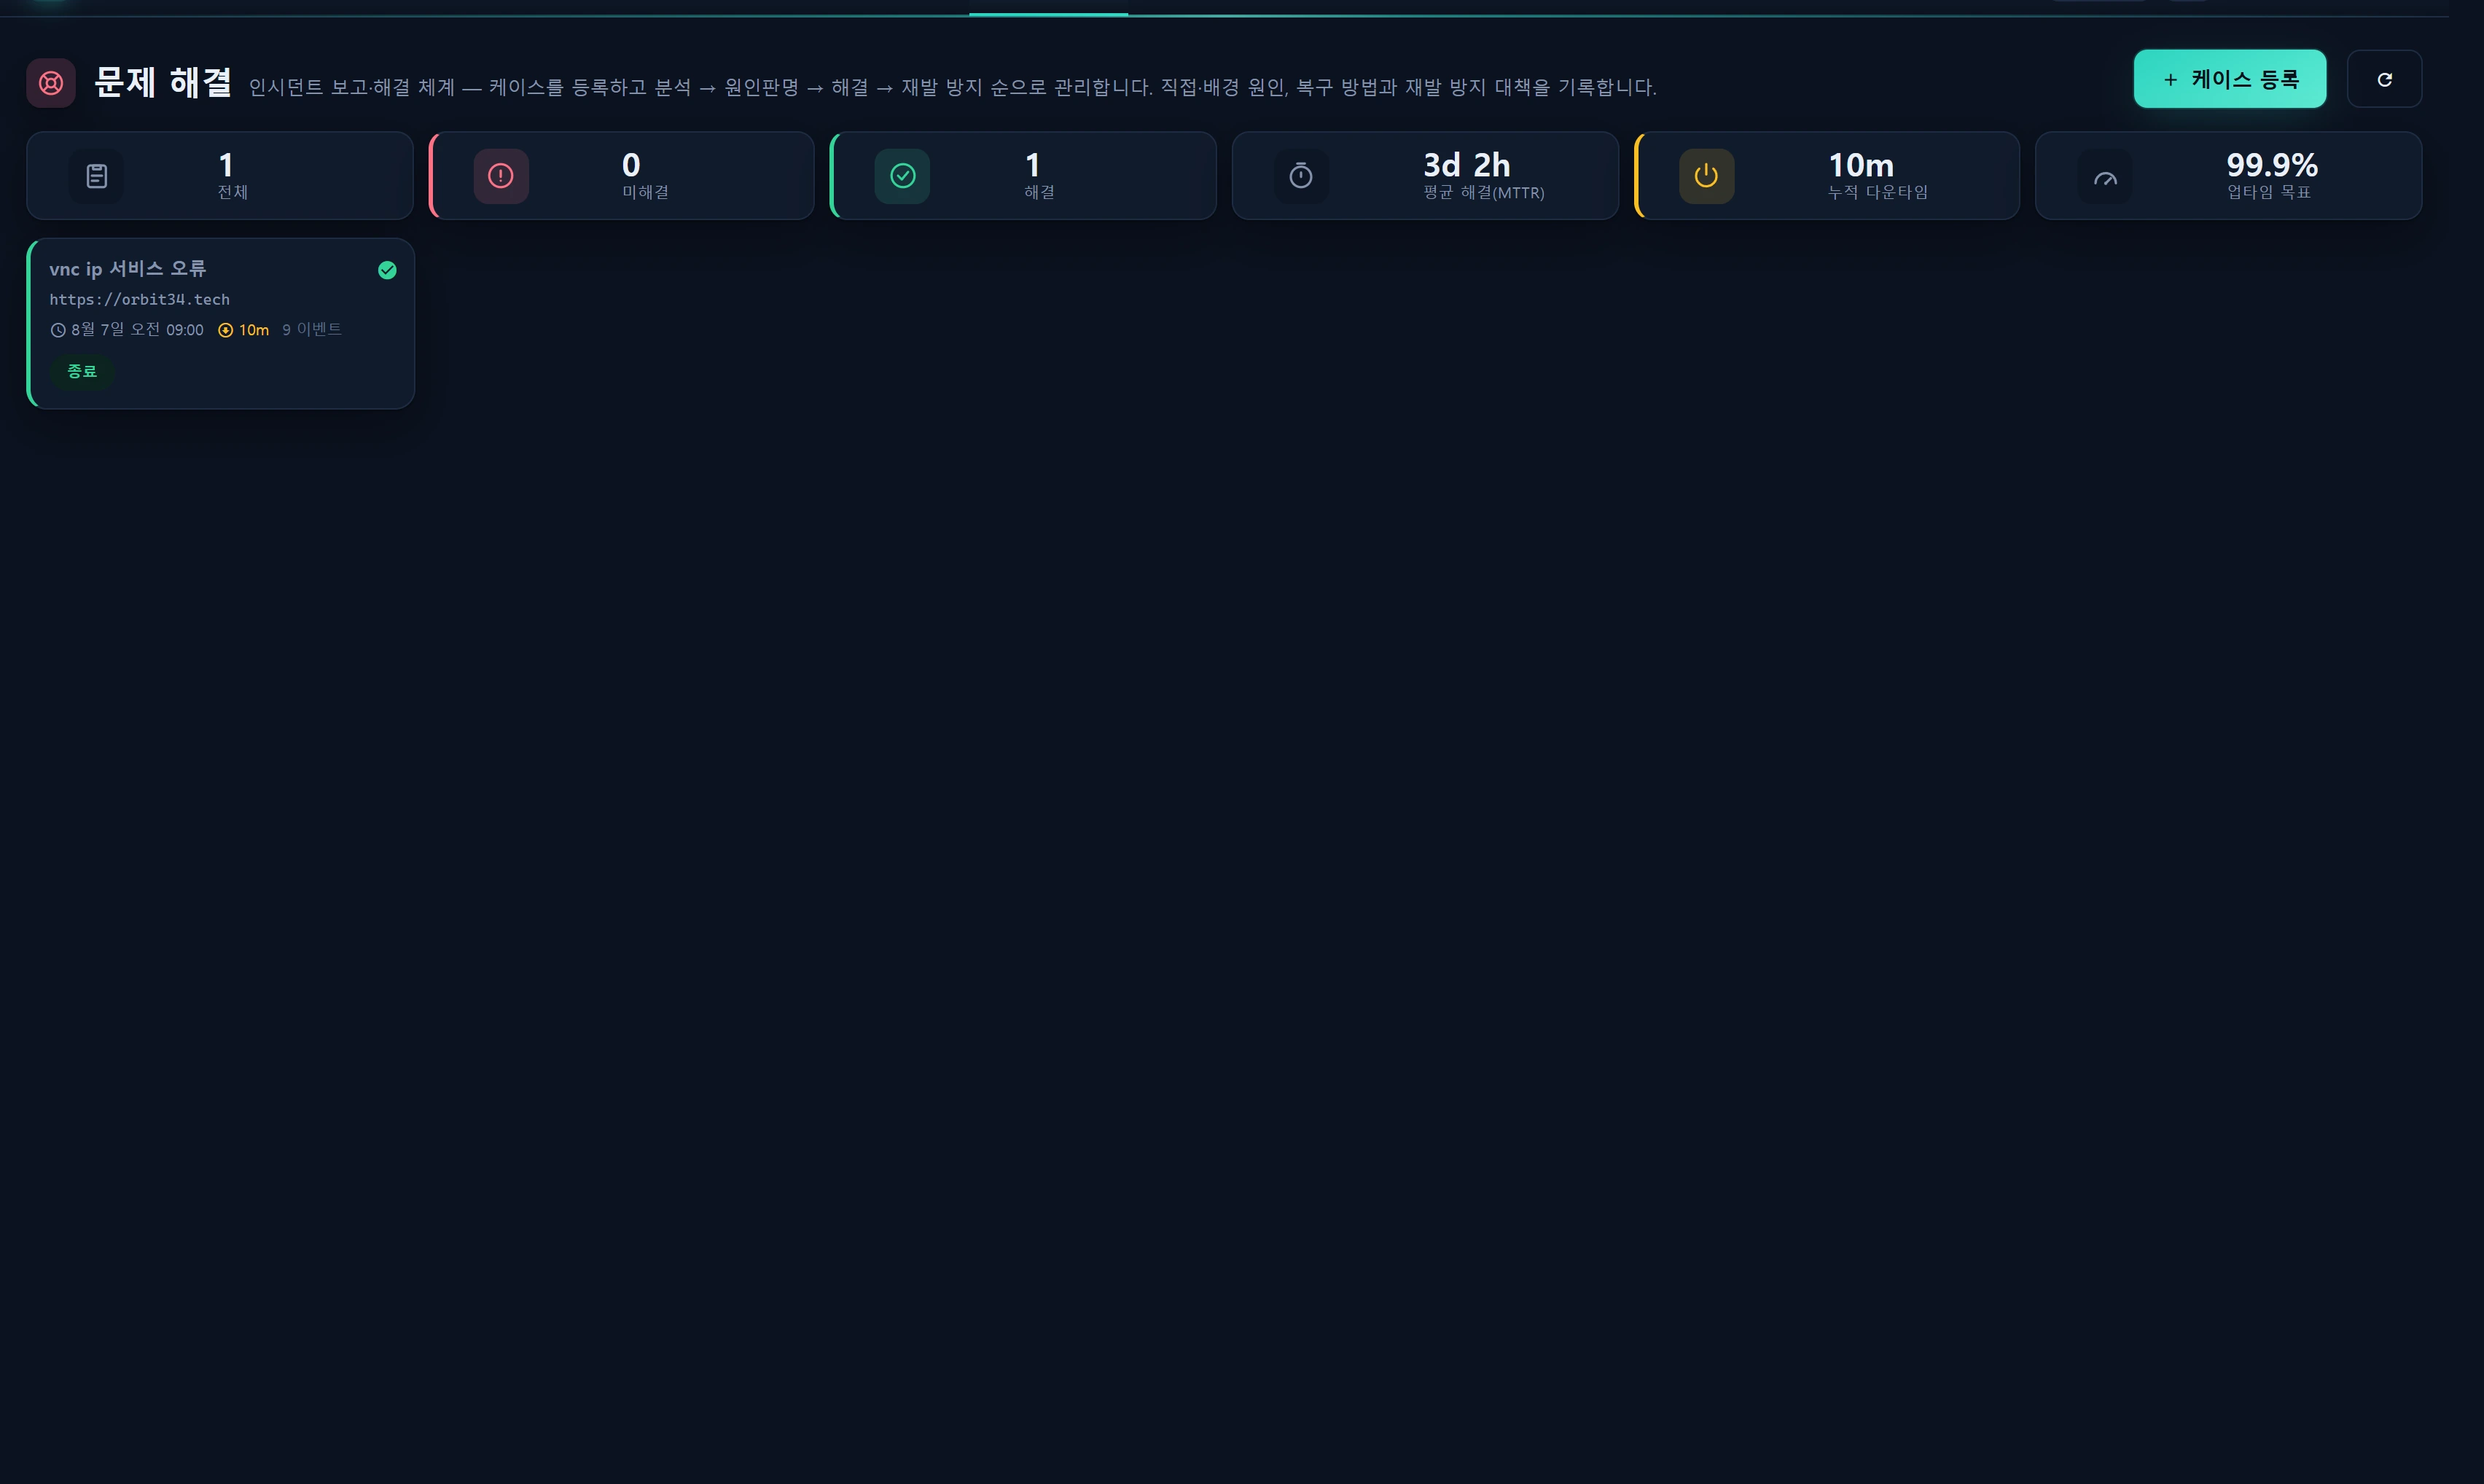
KPI 스트립
상단 KPI는 area='service' 케이스 전체에서 계산됩니다.
| KPI | 계산 방식 |
|---|---|
전체 (total) |
서비스 케이스 총 개수 |
미해결 (active) |
open + investigating + cause_identified 상태 합 |
해결 (resolved) |
resolved + closed 상태 합 |
평균 해결 MTTR (mttr_min) |
occurred_at 과 resolved_at 이 둘 다 있는 케이스만 (해결시각 − 발생시각)의 분 단위 평균 |
누적 다운타임 (downtime_min) |
각 케이스 downtime_min 필드의 단순 합(분) |
업타임 목표 (uptime_target) |
운영 정책 sla_uptime_target(기본 99.9%) |
MTTR을 정확히 얻으려면 케이스에 발생 일시(
occurred_at) 를 입력하고, 해결 단계로 전이할 때resolved_at이 자동 기록되게 하세요. 발생 일시가 비어 있으면 그 케이스는 MTTR 평균에서 제외됩니다.
케이스 보드
케이스는 카드/행으로 나열되며 정렬은 서버(PHP)에서 다음 우선순위로 계산됩니다(컨트롤러 raw SQL 회피):
- 상태 순위:
open→investigating→cause_identified→resolved→closed - 심각도 순위:
crit→warn→info - 최신 id 우선
즉 미해결·심각·최근 케이스가 위로 올라옵니다.
각 카드에는 소스 배지(수동/Pulse/경보/관련기관/격리/탐지 승격), 심각도, 상태, 프로젝트명, 발생 시각, 다운타임, 이벤트 수가 표시됩니다.
상세 모달
카드를 열면 좌측 리포트(요약·직접원인·배경원인·해결·재발방지), 우측 타임라인(상태 변경·노트)이 나오고, 상단에 상태 파이프라인 전이 버튼이 있습니다.
사용법
1) 케이스 등록
[케이스 등록] 버튼 → 모달 폼. 등록 시 source='manual', area='service', status='open' 으로 생성되고 detected_at(감지 시각)이 서버 now() 로 기록되며 타임라인에 created 이벤트가 남습니다.
입력 필드와 검증 한도:
| 필드 | 필수 | 한도 |
|---|---|---|
title (제목) |
✔ | 최대 200자 |
severity (심각도) |
info/warn/crit — 비우면 기본 warn(운영 정책 incident_default_severity) |
|
project_id (프로젝트) |
infr_project 존재 검증 |
|
service_id (서비스) |
infr_service 존재 검증 |
|
url |
최대 255자 | |
occurred_at (발생 일시) |
날짜 | |
summary (요약) |
최대 4000자 | |
direct_cause / root_cause / resolution / action_taken |
각 최대 4000자 | |
downtime_min (다운타임 분) |
정수, 0 이상 | |
impact (영향) |
최대 191자 |
2) 상태 전이 (파이프라인)
상세 모달에서 다음 단계 버튼을 누르면 스텝 전이 대화상자가 뜹니다. 각 단계가 "이 단계에서 할 일"을 안내하고, 그 단계에 해당하는 리포트 필드를 함께 입력·저장할 수 있습니다. 보낸 필드만 갱신되므로, 전이 없이 원인만 채워 넣거나 리포트만 보강하는 것이 가능합니다.
| 단계 | 코드 | 이 단계에서 할 일 |
|---|---|---|
| 등록 | open |
접수 상태로 되돌림(분석 이전) |
| 분석 | investigating |
증상 확인·영향 범위 파악·요약 정리 |
| 원인판명 | cause_identified |
직접 원인과 배경(근본) 원인 규명·기록 |
| 해결 | resolved |
적용한 복구 방법·재발 방지 대책 기록 |
| 종료 | closed |
조치·재발 방지 반영 확인 후 케이스 종료 |
전이 규칙:
resolved로 이동하면resolved_at이 비어 있을 때 서버now()로 자동 기록됩니다(MTTR 산정 기준).closed로 이동할 때 종료 일시(closed_at) 를 발생 일시와 동일한 방식(flatpickr)으로 직접 입력할 수 있습니다. 값을 넣으면 그 시각, 비우면(그리고 아직 미기록이면) 서버now()를 씁니다.- 상태가 실제로 바뀌면(
from !== to) 타임라인에status_change이벤트가 남고, 대화상자에 노트를 함께 적으면note이벤트도 추가됩니다.
날짜 표시는 활성 UI 로케일(
window.__locale)을 사용하는toLocaleString으로 렌더됩니다 — EN 모드에서도 월/시간이 올바른 로케일로 표시됩니다.
3) 협업 노트
상세 모달에서 노트를 추가하면 타임라인에 kind='note' 이벤트가 append 됩니다(별도 노트 테이블 없이 infr_incident_event 로 통합). 본문은 최대 4000자.
4) 삭제
케이스를 삭제하면 해당 인시던트와 연결된 모든 infr_incident_event 행이 함께 삭제됩니다. 삭제는 되돌릴 수 없습니다.
5) 자동 유입 (Pulse / 예외 리포터)
외부 Laravel 앱이 인시던트 인제스트 API(POST /api/v1/incidents)로 자신의 예외를 밀어 넣으면, IncidentIngestService 가 다음처럼 처리해 이 보드에 자동 등재합니다.
- 지문(fingerprint) 디둡: 같은 오류가 이미 열린 상태(
open/investigating/cause_identified)로 존재하면 새 케이스를 만들지 않고occurrence_count(재발 횟수)만 누적합니다. 해결/종료된 케이스는 새로 엽니다. - 신규 케이스는
source='pulse',status='open',entity_type='exception'으로 생성되고(area는 미지정 → 마이그레이션 기본값service→ 이 보드에 노출), 타임라인created이벤트가 남습니다. - 재발 노트는 300초 스로틀로만 타임라인에 남아 이벤트 폭주를 막습니다.
- 페이로드
level(error/warning/critical…)은 심각도(warn/crit…)로 매핑되고, 들어온 심각도가 기존보다 높으면 케이스가 승격됩니다.
키 발급·연동 코드는 Administration ▸ API 발급에서 관리합니다.
데이터 소스
| 테이블 | 역할 |
|---|---|
infr_incident |
케이스 본체. 이 화면은 area='service' 만 조회. 마이그레이션 000719(+ 000723 인제스트 필드 · 000731 area · 000732 source 확장) |
infr_incident_event |
타임라인(append-only). kind = created/note/action/status_change/cause/resolution/alert_added. created_at 만 사용(마이그레이션 000720) |
infr_project |
프로젝트 드롭다운·카드 프로젝트명 |
infr_service |
서비스 드롭다운 |
infr_audit_log |
생성·수정·전이·삭제 감사 기록 |
주요 infr_incident 컬럼: source, area, title, severity, status, project_id, service_id, url, occurred_at, detected_at, resolved_at, closed_at, summary, direct_cause, root_cause, resolution, action_taken, downtime_min, impact, fingerprint, occurrence_count, last_occurred_at, api_key_id, created_by, updated_by.
기본값은 운영 정책 OpsPolicy::slaDefaults() 에서 읽습니다.
sla_uptime_target        = 99.9   # SLA 목표 가동률(%)
incident_default_severity = warn  # 케이스 등록 기본 심각도(info|warn|crit)
라우트:
GET  /service/resolution              index (보드)
GET  /service/resolution/live         live  (JSON 폴링 갱신)
POST /service/resolution/save         케이스 등록/수정
POST /service/resolution/transition   상태 전이(+ 단계별 리포트/closed_at)
POST /service/resolution/note         협업 노트 추가
POST /service/resolution/delete       케이스 삭제
권한
| 동작 | 필요 레벨 |
|---|---|
보드 조회 (index/live) |
인증 사용자(infr.auth, 레벨 ≥ 1) |
등록·수정·전이·노트·삭제 (save/transition/note/delete) |
레벨 ≥ 2 |
- demo(1) — 읽기 전용. 쓰기 시도 시 403(
resolution.err.forbidden, "권한이 없습니다(레벨 2 이상 필요)"). - staff(5) · admin(10) — 전체 CRUD·전이 가능.
모든 쓰기(등록·수정·전이·삭제)는 infr_audit_log 에 incident.create / incident.update / incident.transition / incident.delete 로 기록되며 행위자·전/후 상태가 함께 남습니다. 자세한 레벨 체계는 RBAC 레벨을 참고하세요.
문제해결 · FAQ
Q. MTTR이 계산되지 않아요(빈 값).
케이스에 발생 일시(occurred_at) 와 해결 시각(resolved_at) 이 둘 다 있어야 MTTR 평균에 포함됩니다. 발생 일시를 입력했는지, 해결 단계로 전이해 resolved_at 이 기록되었는지 확인하세요.
Q. 누적 다운타임이 0으로 보여요.
다운타임 KPI는 각 케이스의 downtime_min 필드를 단순 합산한 값입니다. 케이스에 다운타임(분)을 직접 입력해야 반영됩니다(발생~해결 시각으로 자동 계산하지 않습니다).
Q. Pulse로 들어온 케이스가 안 보여요.
인제스트 케이스는 source='pulse' 이고 area 를 지정하지 않아 기본값 service 로 이 보드에 등재됩니다. 그래도 안 보이면 (1) API 키가 유효한지, (2) 같은 지문이 이미 열린 케이스로 디둡되어 occurrence_count 만 올라갔는지 확인하세요. 보안 인시던트는 이 보드가 아니라 보안 문제 해결(area='security')에 나타납니다.
Q. 종료 시각을 과거로 지정할 수 있나요?
네. closed 전이 대화상자의 종료 일시(flatpickr) 필드에 원하는 시각을 입력하면 그 값이 저장됩니다. 비우면 서버 현재 시각(now())이 쓰입니다.
Q. 상태를 바꾸지 않고 원인만 보강하고 싶어요. 전이 대화상자는 보낸 필드만 갱신합니다. 같은 상태로 전이하면서 리포트 필드만 채우면 상태 변경 이벤트 없이 리포트만 업데이트됩니다(또는 케이스 편집으로 직접 수정).
Q. 삭제한 케이스를 복구할 수 있나요? 아니요. 삭제는 케이스와 모든 타임라인 이벤트를 함께 제거하며 되돌릴 수 없습니다. 삭제 행위 자체는 감사 로그에 남습니다.
관련 항목
- 보안 문제 해결 — 같은
infr_incident테이블을area='security'로 공유하는 미러 보드. - 인시던트 인제스트 API · API 키 발급 — 외부 앱 오류를
source='pulse'케이스로 자동 등재. - 프로젝트 — 케이스에 연결하는 프로젝트 메타 레지스트리.
- 서비스 개요 — 라이브 서비스 관제(미해결 인시던트 KPI 연동).
- 관측(Pulse/Horizon) — 예외 수집 파이프라인 배경.