개요 — 무엇을 하나
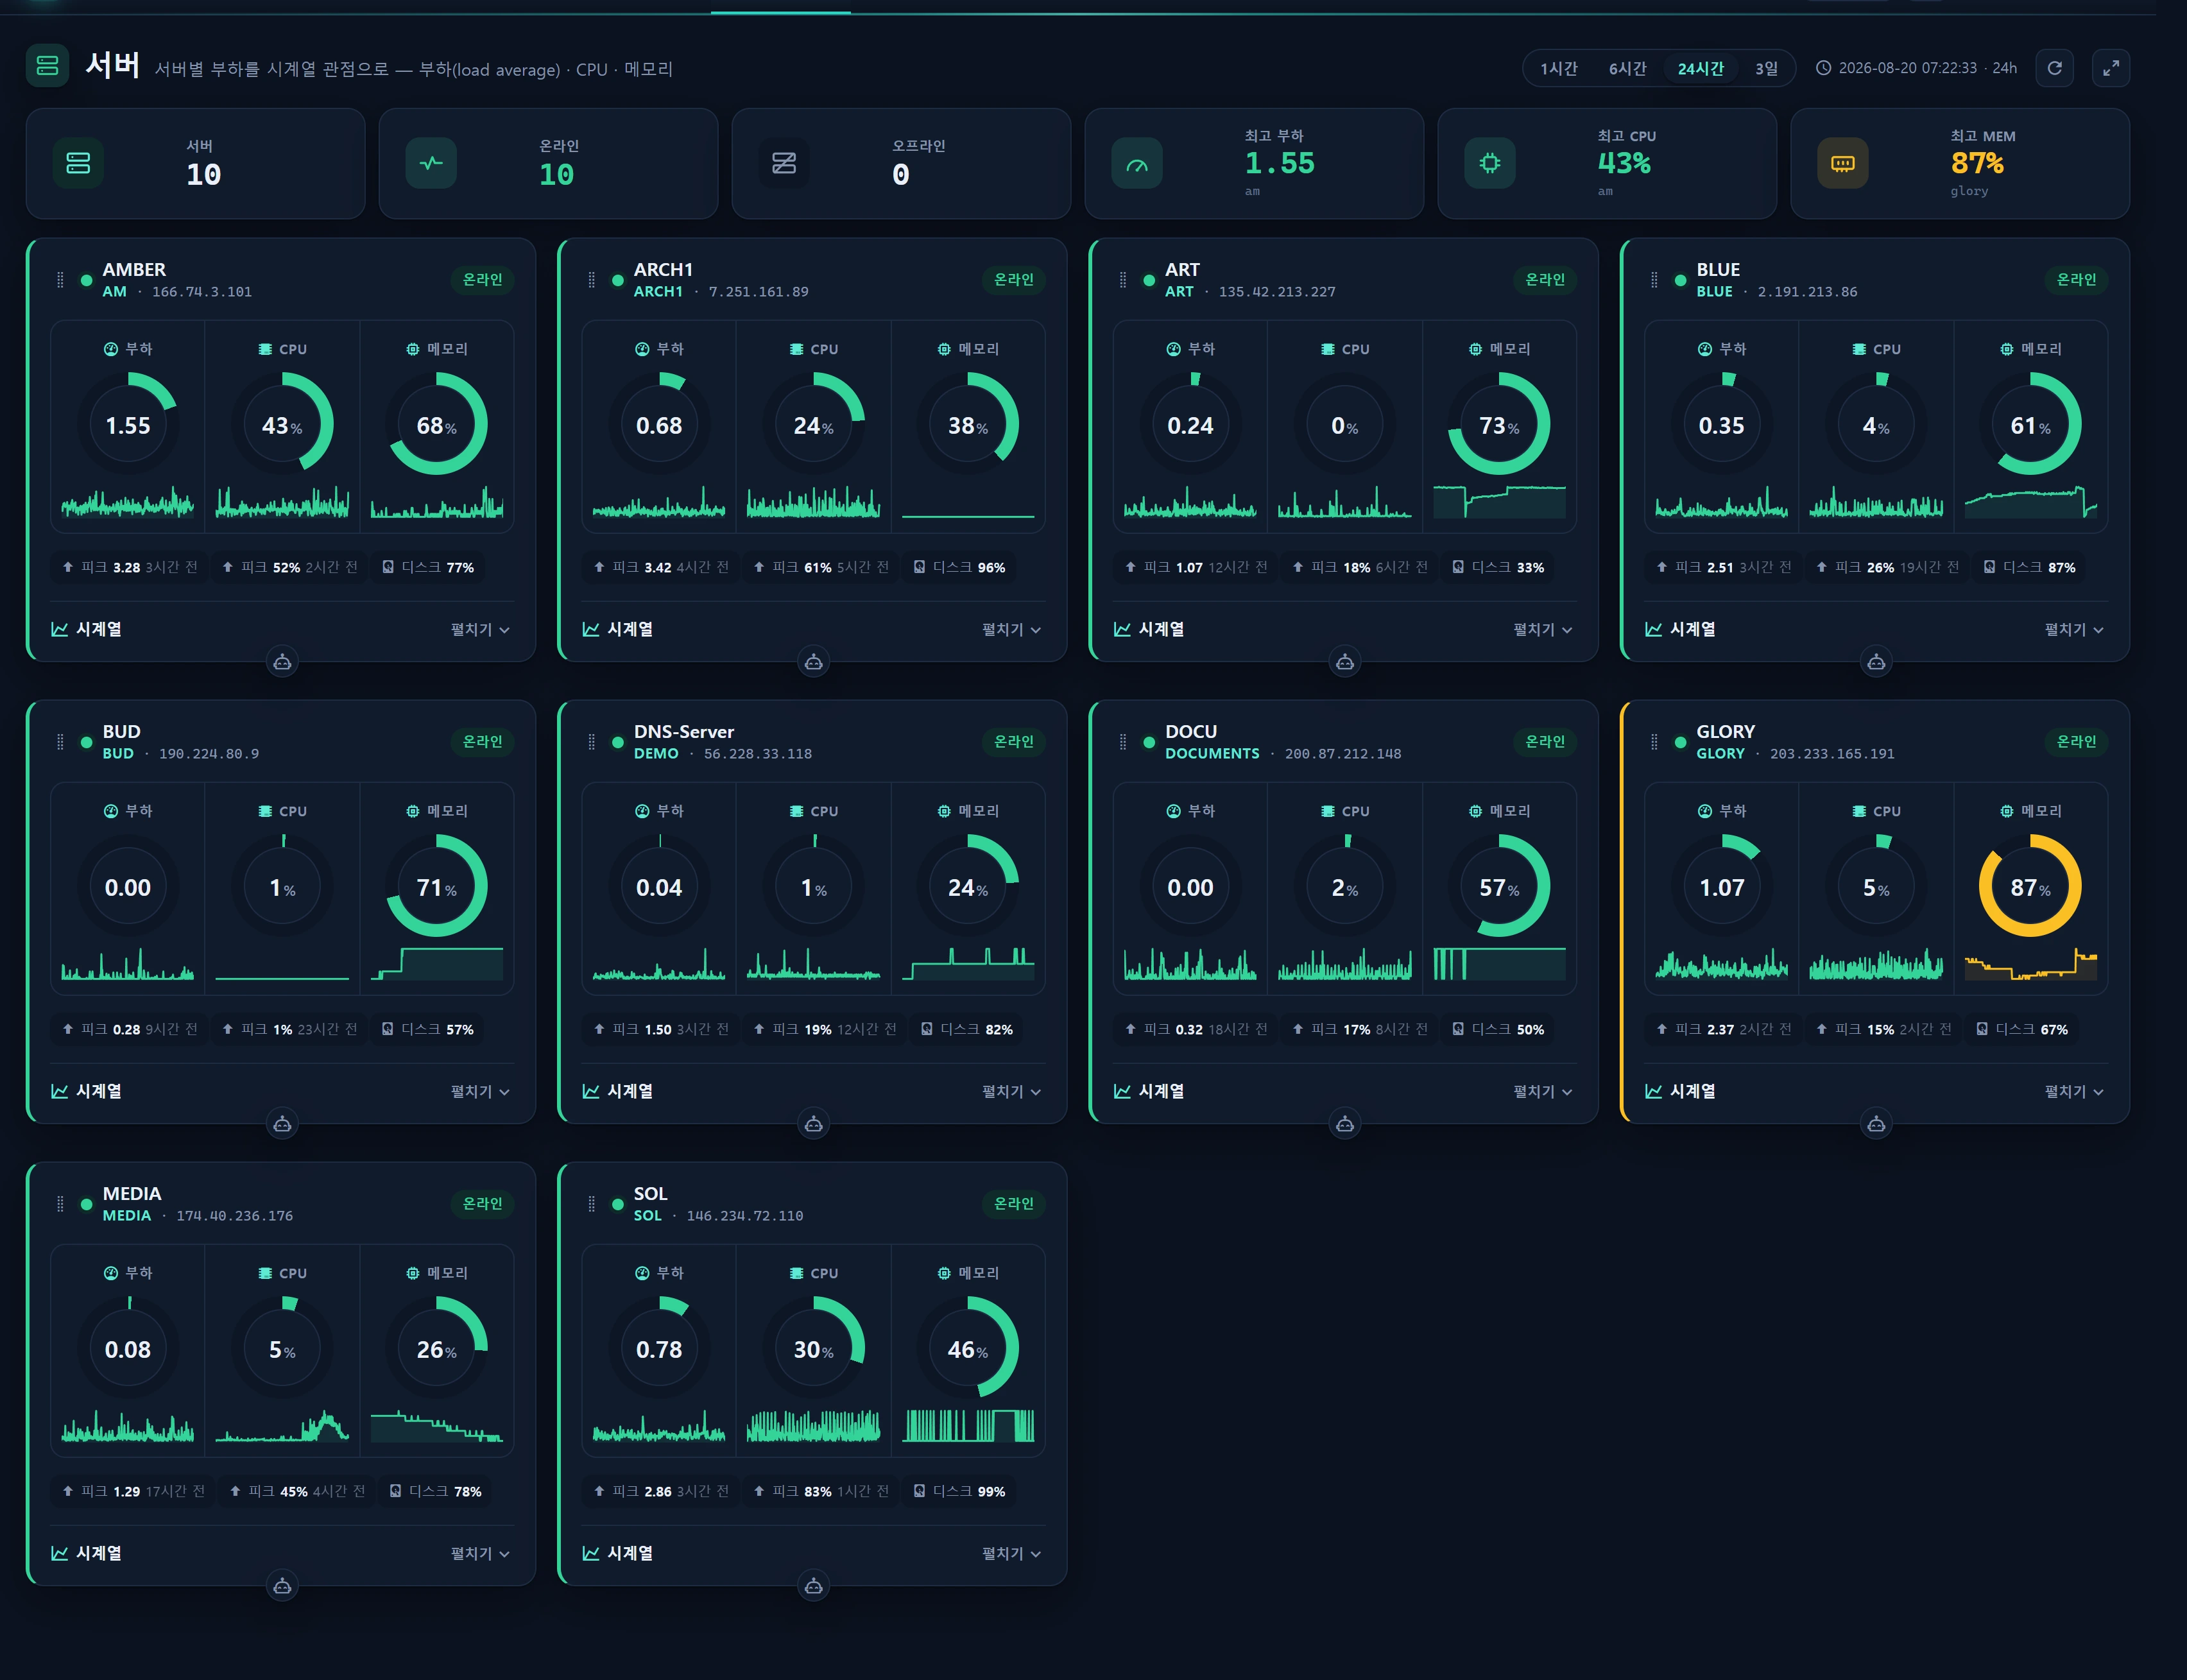
Infrastructure ▸ Servers(/infra/servers)는 등록된 모든 서버 노드의 부하(load average) · CPU · 메모리를 시계열 관점으로 보여줍니다. 헬스 화면이 "지금 이 순간의 노드 상태"를 라이브 프로브로 찍는다면, Servers 화면은 "최근 몇 시간~며칠 동안 부하가 어떻게 흘렀나"를 되짚는 데 초점을 둡니다. stats-design 의 monitoring/part(load_average·cpu_usage·memory_usage)를 재구현한 것입니다.
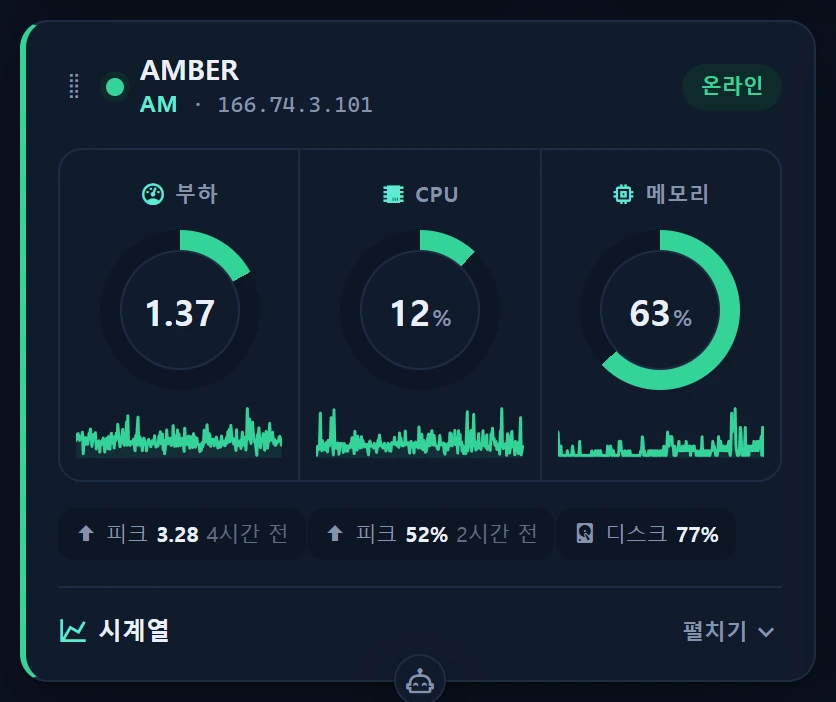
노드마다 카드 하나:
- 3-링 게이지(Load / CPU / MEM 현재값) — 한눈에 심각도 파악.
- SVG 스파크라인 — 최근 추세 미리보기.
- [펼치기] → ECharts 결합 선그래프(CPU%·MEM% 좌축 + Load 우축)와 통계표(현재/평균/최소/최대 + 피크 시각).
지표 원천은 레거시 server_status 테이블(읽기 전용)이며, 빌더 ServerMetricService 가 최근 seq 창만 좁혀 조회(slow query 회피) + 20초 캐시로 대용량 스캔을 피합니다. 카드 그리드는 드래그 재정렬 + masonry 이고 30초 폴링으로 자동 갱신됩니다.
server_status는 Laravel 밖에서 도는 Node 수집기run_report.js가 약 5분 주기로 직접 채웁니다. 따라서 시간축 해상도는 대략 5분 간격이며, 실시간 push(Reverb)가 아니라 폴링으로 갱신합니다.
언제 쓰나
- 어떤 서버가 지속적으로 높은 부하를 받고 있는지 fleet 전체에서 비교하고 싶을 때.
- 장애·경보가 발생한 시각 주변으로 부하/CPU/메모리 곡선의 변곡점을 되짚고 싶을 때(피크 발생 시각까지 표시).
- 배포·트래픽 급증 이후 메모리 사용률 추세나 CPU 포화를 확인할 때.
- Alerts 가 로드에버리지·디스크 여유 조건으로 발화했을 때, 원인 노드를 시계열로 확인하는 후속 조사.
세션 단위 실시간 관제(서비스 도트 nginx/php/mysql 포함)는 헬스, 네트워크 I/O 바이트/패킷 그래프는 Traffic, 디스크·RAID 건전성은 Storage & RAID 로 분리되어 있습니다.
화면 구성
상단 KPI 바
ServerMetricService::kpi() 가 계산합니다.
| KPI | 의미 |
|---|---|
| 서버 | 창에 등장한 전체 노드 수 |
| 온라인 | 최근 2개 수집 사이클 안에 loadavg 를 보고한 노드 수 |
| 오프라인 | 전체 − 온라인 |
| 최고 부하 | 현재 1분 부하가 가장 높은 노드 + alias |
| 최고 CPU | 현재 CPU% 가 가장 높은 노드 + alias |
| 최고 MEM | 현재 메모리% 가 가장 높은 노드 + alias |
range 토글
표시 창(seq 창 포인트 수)을 고릅니다. 선택은 localStorage(infr:range:infra-servers)에 저장되어 다음 방문에 유지됩니다.
| range | seq 포인트 수 | ≈ 실제 창(5분 주기 기준) |
|---|---|---|
| 1h | 12 | 약 1시간 |
| 6h | 72 | 약 6시간 |
| 24h | 288 | 약 24시간 (기본값) |
| 3d | 864 | 약 3일 |
range 는 "최근 N개 수집 사이클"로 환산됩니다(시각 절대범위가 아님). 수집 주기가 5분이면 24h ≈ 288 포인트입니다. 수집이 드문 노드는 같은 range 라도 실제 창이 짧게 표시될 수 있습니다(하단 창 라벨이 실제 span 을
24h/6h/45m/2d로 알려줍니다).
노드 카드
┌──────────────────────────────────────────────┐
│ label · alias · IP           online / last N분전│   ← 헤더(라벨은 infr_instance 인리치)
│  ( Load )   ( CPU )   ( MEM )                    │   ← 3-링 게이지(현재값)
│  ▁▂▅▇▅▃  스파크라인(SVG polyline)               │
│  피크 · 디스크 42% · net out 1,234    [펼치기]  │   ← 푸터
└──────────────────────────────────────────────┘
카드 테두리·게이지 색은 임계 톤으로 칠해지며, 카드 전체 심각도는 세 지표 중 가장 나쁜 값을 따릅니다.
| 지표 | good | warn | crit |
|---|---|---|---|
| Load (1분) | < 8 | ≥ 8 | ≥ 16 |
| CPU % | < 70 | ≥ 70 | ≥ 90 |
| MEM % | < 85 | ≥ 85 | ≥ 95 |
Load 링은 load 8 에서 가득 참(
LOAD_FULL=8)으로 정규화됩니다 — warn 임계와 정합. 코어 수가 많은 서버라면 load 8 이 곧 위험은 아닐 수 있으니, 절대값은 게이지 중앙 숫자로 함께 확인하세요.
펼침 상세 (ECharts + 통계)
[펼치기] 를 누르면 카드가 세로로 확장되고 masonry 가 높이 변화를 자동 재배치합니다.
- 결합 선그래프:
CPU%·MEM%(좌축 0~100%) +Load(우축, 자동 스케일). x축은 각 수집 사이클의 최신 시각(HH:MM), crosshair 툴팁. - 통계표: 각 지표(부하/CPU/메모리)의 현재 · 평균 · 최소 · 최대, 그리고 피크가 언제 발생했는지(예: "피크 12분 전").
사용법
/infra/servers진입 → 노드 카드가 alias 오름차순으로 배치됩니다.- 상단 range 로 관찰 창을 고릅니다(1h/6h/24h/3d). 폴링과 무관하게 즉시 다시 조회합니다.
- 관심 노드 카드의 [펼치기] 로 시계열 차트·통계표를 엽니다.
- 차트 위에 마우스를 올려 특정 시각의 CPU/MEM/Load 값을 crosshair 로 읽습니다.
- 카드를 드래그해 자주 보는 노드를 위로 정렬합니다 — 순서는
localStorage(infr:order:infra-servers)에 영속됩니다. - 헤더의 전체화면 버튼으로 상단 네비를 숨기고 대시보드 모드로 볼 수 있습니다.
화면은 30초마다 /infra/servers/live 를 폴링해 자동 갱신됩니다(브라우저 조작 불필요). 이 화면에는 쓰기/제어 액션이 없습니다 — 순수 관측용입니다.
폴링 프론트는 값싼 변경 감지 토큰
rev(=server_status의 최신 seq)로 갱신 필요를 판단합니다. 새 수집 사이클이 들어오기 전에는 화면이 그대로입니다 — "안 움직입니다"가 아니라 아직 새 스냅샷이 없는 것입니다.
데이터 소스
원천은 레거시 server_status(MAIN DB, key-value part 스키마, 읽기 전용). run_report.js 저장 규약을 그대로 해석합니다.
| part | 값 형식 | 의미 | 시리즈 사용 |
|---|---|---|---|
loadavg |
"1m 5m 15m" 공백 구분 (예 "0.50 0.42 0.38") |
부하 평균 | 시리즈·링은 1분 부하만, 푸터는 5/15분 함께 |
top |
"NN%" (예 "3.6%") |
CPU user 사용률 | CPU 시리즈·링 |
free |
"NN%" |
메모리 사용률 = round(used/total×100) | MEM 시리즈·링 |
df-data / df- / df-home |
JSON {p,u,a} |
디스크 사용률(p)·사용(u)·크기(a) | 최신 디스크 배지(df-data → df- → df-home 우선순위) |
traffic-out |
숫자 | 네트워크 out 패킷 델타 | net 시리즈·푸터 |
조회·가공 규율:
- seq 창:
SELECT DISTINCT seq ORDER BY seq DESC LIMIT N(인덱스 스캔)으로 최근 N개 수집 사이클만 뽑고, 그 seq·part 로whereIn조회 → 2억행급 테이블에서도 좁은 창만 스캔.OverviewService·HealthService와 동일 규율. - seq = 전 서버 공용 스냅샷 배치 id. 시리즈는 항상 과거→현재 정렬.
- 결측 carry-forward: 어떤 사이클에 특정 part 가 없으면 직전 값을 이어 붙입니다(그래프 끊김 방지).
- 온라인 판정: 최근 2개 사이클 안에 loadavg 가 있으면 온라인(1사이클 누락 허용).
last_seen= 마지막으로 loadavg 를 보고한 사이클 시각. - 20초 캐시:
Cache::remember("infr:srvmetric:v1:{points}", 20, …). 즉, 30초 폴링이라도 실제 DB 조회는 최대 20초에 한 번. - 라벨·IP 인리치: alias/hostname(소문자)을 Instances(
infr_instance)의name·ip_public/ip_private로 매핑(60초 캐시). 미등록 노드는 alias 그대로 표시됩니다.
server_status 를 채우는 run_report.js 수집기의 등록·크리덴셜은 Administration ▸ Collectors 에서 관리합니다.
권한
- 읽기 전용 화면. 콘솔 인증(
infr.auth)을 통과한 모든 사용자가 볼 수 있습니다(Infrastructure 역할 영역 최소user_level= 1, 즉 demo=1 이상). - 쓰기/제어 액션 없음 — 차단·재시작 같은 조치 버튼이 없습니다.
- 카드 순서·range 선택은 서버에 저장하지 않고 브라우저
localStorage에만 저장됩니다(사용자·브라우저별).
레벨 체계: demo=1 · staff=5 · admin=10 (RBAC 레벨 참조).
문제해결 · FAQ
"서버 지표가 없습니다." 만 보입니다.
server_status 에 최근 스냅샷이 없습니다. run_report.js 수집기가 도는지, Collectors 에 등록됐는지 확인하세요. 레거시 DB(MAIN) 연결도 점검.
노드가 오프라인으로 표시됩니다.
최근 2개 수집 사이클 안에 loadavg 보고가 없다는 뜻입니다. 해당 노드의 run_report 실행 상태, 시각(clock skew), 네트워크를 확인하세요. last_seen 상대 라벨로 마지막 보고 시각을 알 수 있습니다.
카드 라벨이 예쁜 이름 대신 alias(예 sol)로 뜹니다.
그 alias 가 Instances(infr_instance)에 등록되지 않았습니다. 인스턴스를 등록하면 name 이 라벨로, ip_public/ip_private 가 IP 로 표시됩니다.
디스크 배지가 비어 있습니다.
해당 노드가 df-data/df-/df-home 중 어느 것도 JSON {p,u,a} 형식으로 보고하지 않았습니다. 디스크 사용률·RAID 건전성 상세는 Storage & RAID 를 사용하세요.
Load 링이 항상 가득 차 보입니다. Load 링은 load 8 을 상한으로 정규화합니다. 코어가 많은 서버는 load 8 이 정상일 수 있으니 게이지 **중앙 숫자(절대 load 값)**로 판단하세요. 색 톤 임계(warn 8 / crit 16)만으로 위험을 단정하지 말 것.
30초 폴링인데 값이 안 바뀝니다.
(1) 아직 새 수집 사이클(약 5분)이 안 들어왔거나, (2) 20초 캐시 창 안입니다. stamp·창 라벨과 rev(최신 seq)로 실제 갱신 여부를 확인하세요.
range 를 3d 로 했는데 창이 짧게 나옵니다.
range 는 "최근 N개 사이클"이라 수집이 드문 노드는 실제 시간 span 이 짧습니다. 하단 창 라벨이 실제 span(45m/6h/2d)을 보여줍니다. 포인트 수 상한은 1000.
관련 항목
- 헬스 — 같은 노드의 라이브 상태·서비스 도트(nginx/php/mysql) 관제.
- Storage & RAID — 디스크 사용률·RAID 컨트롤러 건전성·물리 디스크 맵.
- Traffic — 네트워크 I/O 바이트/패킷 시계열.
- Alerts — 로드에버리지·디스크 여유 조건으로 담당자에게 SMS/메일 발송.
- Instances — alias→라벨·IP 인리치의 원천(자산 대장).
- Collectors —
server_status를 채우는run_report수집기 레지스트리.