Überblick – was dieser Bildschirm leistet
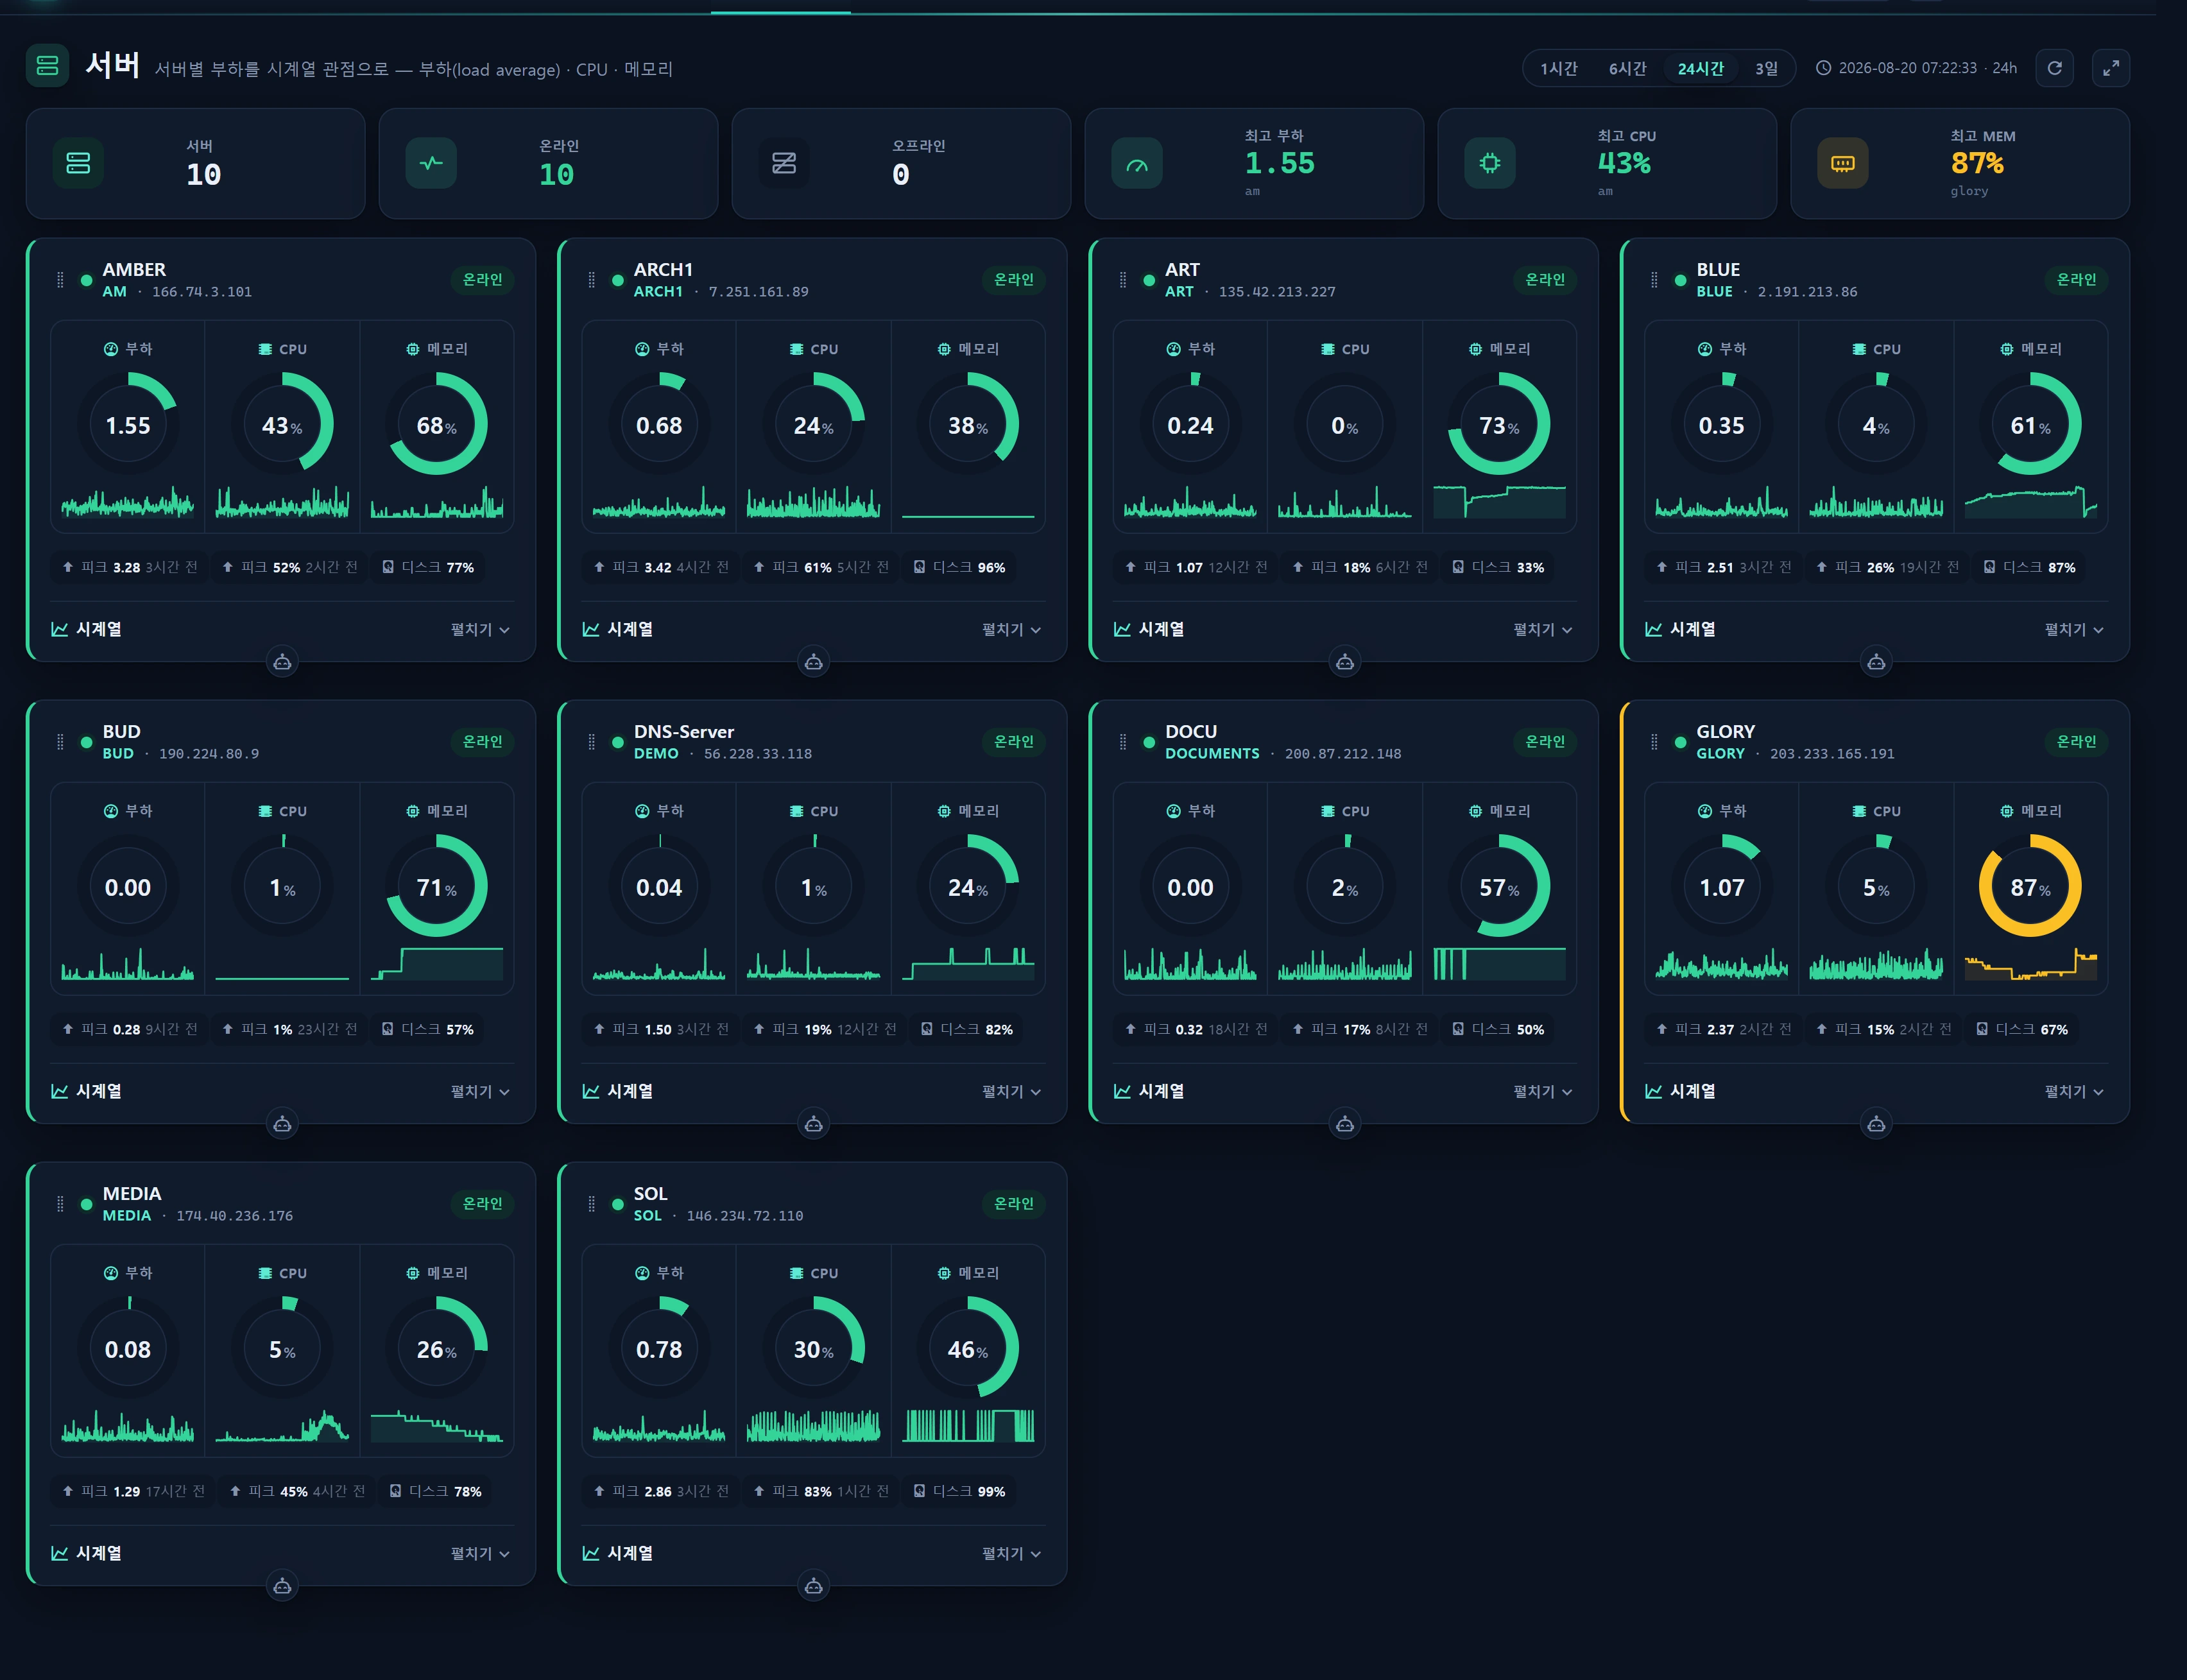
Infrastruktur ▸ Server (/infra/servers) zeigt Durchschnittslast · CPU · Arbeitsspeicher für jeden registrierten Serverknoten aus einer Zeitreihen-Perspektive. Während der Bildschirm Zustand über Live-Prüfungen den „Zustand jedes Knotens im Augenblick“ erfasst, konzentriert sich der Bildschirm Server darauf, „wie sich die Last über die letzten Stunden bis Tage entwickelt hat“. Er ist eine Neuimplementierung von monitoring/part aus stats-design (load_average · cpu_usage · memory_usage).
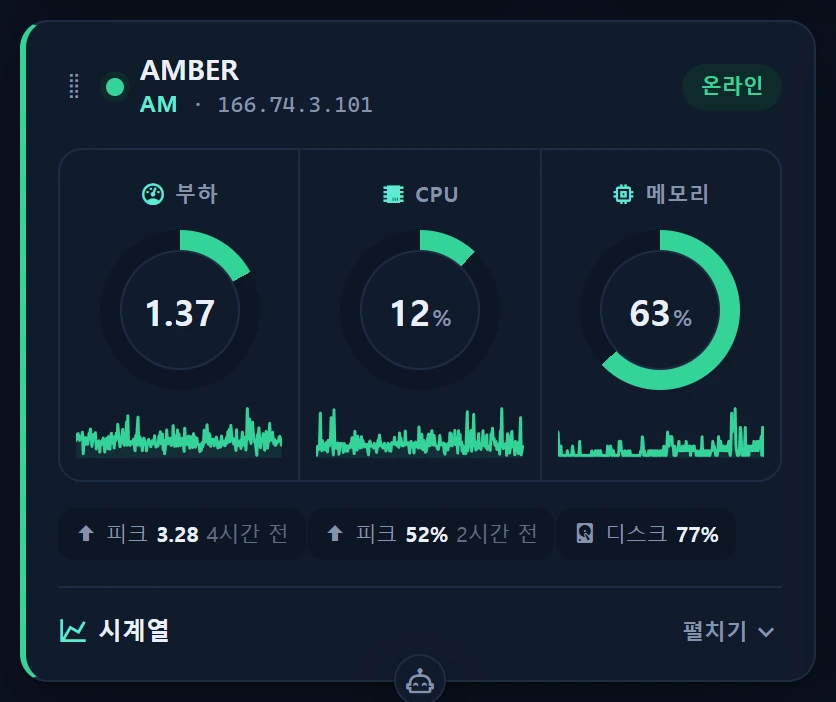
Eine Karte je Knoten:
- Drei Ringanzeigen (aktueller Wert für Load / CPU / MEM) – der Schweregrad auf einen Blick.
- SVG-Sparkline – eine Vorschau des jüngsten Verlaufs.
- [Details] → kombiniertes ECharts-Liniendiagramm (CPU% · MEM% auf der linken Achse + Load auf der rechten Achse) und eine Statistiktabelle (aktuell / Durchschnitt / Min / Max + Zeitpunkt des Spitzenwerts).
Die Metriken stammen aus der Alt-Tabelle server_status (nur lesend). Der Builder ServerMetricService grenzt die Abfrage auf ein aktuelles seq-Fenster ein (und vermeidet so einen langsamen vollständigen Durchlauf) und wendet einen 20-Sekunden-Cache an. Das Kartenraster unterstützt Umsortieren per Drag-and-drop + Masonry und aktualisiert sich automatisch per 30-Sekunden-Abfrage.
server_statuswird vom Node-Collectorrun_report.jsbefüllt, der außerhalb von Laravel in einem Zyklus von etwa 5 Minuten läuft. Die Auflösung der Zeitachse beträgt daher rund 5 Minuten, und der Bildschirm aktualisiert sich per Abfrage (nicht per Echtzeit-Push / Reverb).
Wann Sie ihn verwenden
- Um über den gesamten Bestand hinweg zu vergleichen, welche Server eine dauerhaft hohe Last tragen.
- Um die Wendepunkte der Last-, CPU- und Speicherkurven rund um den Zeitpunkt zu betrachten, an dem ein Vorfall auftrat oder ein Alarm ausgelöst wurde (der Zeitpunkt des Spitzenwerts wird ebenfalls angezeigt).
- Um nach einem Deployment oder einer Traffic-Spitze einen Trend der Speichernutzung oder eine CPU-Sättigung zu prüfen.
- Als Anschlussuntersuchung, wenn Alarme aufgrund von Bedingungen zur Durchschnittslast oder zum freien Plattenplatz auslösen – bestätigen Sie den betroffenen Knoten anhand der Zeitreihe.
Die Live-Sitzungsüberwachung (mit Dienstpunkten für nginx/php/mysql) finden Sie unter Zustand, Byte-/Paket-Diagramme zur Netzwerk-E/A unter Traffic und den Zustand von Platten und RAID unter Speicher und RAID.
Aufbau
Obere KPI-Leiste
Wird von ServerMetricService::kpi() berechnet.
| KPI | Bedeutung |
|---|---|
| Server | Gesamtzahl der im Fenster vorhandenen Knoten |
| Online | Knoten, die innerhalb der letzten 2 Erfassungszyklen loadavg gemeldet haben |
| Offline | Gesamt − Online |
| Höchste Last | Knoten mit der höchsten aktuellen 1-Minuten-Last + Alias |
| Höchste CPU | Knoten mit dem höchsten aktuellen CPU% + Alias |
| Höchster Speicher | Knoten mit dem höchsten aktuellen Speicher-Prozentwert + Alias |
range-Umschalter
Wählt das Anzeigefenster aus (Anzahl der Punkte des seq-Fensters). Die Auswahl wird im localStorage (infr:range:infra-servers) gespeichert und bleibt über Besuche hinweg erhalten.
| range | seq-Punkte | ≈ tatsächliches Fenster (5-Minuten-Zyklus) |
|---|---|---|
| 1h | 12 | ~1 Stunde |
| 6h | 72 | ~6 Stunden |
| 24h | 288 | ~24 Stunden (Standard) |
| 3d | 864 | ~3 Tage |
range wird in „die letzten N Erfassungszyklen“ übersetzt (nicht in eine absolute Zeitspanne). Bei einem 5-Minuten-Zyklus entspricht 24h ≈ 288 Punkten. Ein Knoten, der selten meldet, kann bei gleichem range ein kürzeres tatsächliches Fenster zeigen – die Fensterbezeichnung am unteren Rand nennt die reale Spanne als
24h/6h/45m/2d.
Knotenkarte
┌──────────────────────────────────────────────┐
│ label · alias · IP           online / last Nm │   ← Kopf (Bezeichnung aus infr_instance angereichert)
│  ( Load )   ( CPU )   ( MEM )                    │   ← 3 Ringanzeigen (aktueller Wert)
│  ▁▂▅▇▅▃  Sparkline (SVG-Polylinie)              │
│  peak · disk 42% · net out 1,234      [Details] │   ← Fuß
└──────────────────────────────────────────────┘
Kartenrahmen und Anzeigen werden mit einem Schwellenwert-Farbton gezeichnet; der Gesamtschweregrad der Karte richtet sich nach der schlechtesten der drei Metriken.
| Metrik | good | warn | crit |
|---|---|---|---|
| Load (1 Min.) | < 8 | ≥ 8 | ≥ 16 |
| CPU % | < 70 | ≥ 70 | ≥ 90 |
| MEM % | < 85 | ≥ 85 | ≥ 95 |
Der Load-Ring ist so normiert, dass er bei Last 8 voll ist (
LOAD_FULL=8) – abgestimmt auf den warn-Schwellenwert. Auf einer Maschine mit vielen Kernen ist eine Last von 8 nicht zwangsläufig gefährlich; lesen Sie daher stets auch den absoluten Wert aus der Zahl in der Ringmitte ab.
Ausgeklappte Detailansicht (ECharts + Statistik)
Ein Druck auf [Details] lässt die Karte vertikal wachsen; Masonry ordnet die Höhenänderung automatisch neu an.
- Kombiniertes Liniendiagramm:
CPU%·MEM%(linke Achse 0–100 %) +Load(rechte Achse, automatisch skaliert). Die x-Achse ist der jeweils letzte Zeitstempel eines Erfassungszyklus (HH:MM), mit einem Fadenkreuz-Tooltip. - Statistiktabelle: für jede Metrik (Last / CPU / Arbeitsspeicher) die Werte aktuell · Durchschnitt · Min · Max sowie wann der Spitzenwert auftrat (z. B. „Spitze vor 12 Min.“).
Vorgehen
- Öffnen Sie
/infra/servers→ die Knotenkarten werden in aufsteigender Alias-Reihenfolge angeordnet. - Wählen Sie mit dem Umschalter range (1h/6h/24h/3d) ein Beobachtungsfenster. Die Abfrage wird sofort erneut ausgeführt, unabhängig von der periodischen Abfrage.
- Öffnen Sie mit [Details] das Zeitreihendiagramm und die Statistiktabelle eines Knotens.
- Fahren Sie über das Diagramm, um die CPU-/MEM-/Load-Werte zu einem bestimmten Zeitpunkt über das Fadenkreuz abzulesen.
- Ziehen Sie Karten, um die von Ihnen am häufigsten beobachteten Knoten nach oben zu holen – die Reihenfolge bleibt im
localStorage(infr:order:infra-servers) erhalten. - Verwenden Sie die Vollbild-Schaltfläche im Kopfbereich, um die obere Navigation auszublenden und die Ansicht im Dashboard-Modus zu nutzen.
Der Bildschirm aktualisiert sich alle 30 Sekunden automatisch durch Abfrage von /infra/servers/live (ohne Zutun). Dieser Bildschirm kennt keine Schreib- oder Steueraktionen – er dient rein der Beobachtung.
Das abfragende Frontend entscheidet anhand des günstigen Änderungstokens
rev(= das letzte seq vonserver_status), ob eine Aktualisierung nötig ist. Bis ein neuer Erfassungszyklus eintrifft, bleibt der Bildschirm unverändert – das ist nicht „eingefroren“, es gibt schlicht noch keine neue Momentaufnahme.
Datenquellen
Die Quelle ist die Alt-Tabelle server_status (MAIN-DB, Schlüssel-Wert-Schema über part, nur lesend). Sie interpretiert die Speicherkonvention von run_report.js unmittelbar.
| part | Wertformat | Bedeutung | Verwendung in der Reihe |
|---|---|---|---|
loadavg |
"1m 5m 15m" durch Leerzeichen getrennt (z. B. "0.50 0.42 0.38") |
Durchschnittslasten | Reihe und Ring verwenden nur die 1-Minuten-Last; der Fuß zeigt zusätzlich 5/15 Min. |
top |
"NN%" (z. B. "3.6%") |
CPU-Nutzung im User-Modus | CPU-Reihe/-Ring |
free |
"NN%" |
Speichernutzung = round(used/total×100) | MEM-Reihe/-Ring |
df-data / df- / df-home |
JSON {p,u,a} |
Platten-Prozentwert (p) · belegt (u) · Größe (a) | Aktuellstes Platten-Abzeichen (Priorität df-data → df- → df-home) |
traffic-out |
numerisch | Delta der ausgehenden Netzwerkpakete | net-Reihe/-Fuß |
Disziplin bei Abfrage und Aufbereitung:
- seq-Fenster:
SELECT DISTINCT seq ORDER BY seq DESC LIMIT N(Index-Durchlauf) wählt nur die letzten N Erfassungszyklen aus; diese seq-/part-Werte steuern anschließend einewhereIn-Abfrage – so durchsucht selbst eine Tabelle mit 200 Mio. Zeilen nur ein schmales Fenster. Dieselbe Disziplin wie beiOverviewService/HealthService. - seq = eine bestandsweite Batch-ID einer Momentaufnahme. Reihen werden stets von Vergangenheit zu Gegenwart sortiert.
- Fortschreiben fehlender Werte: Fehlt ein part in einem Zyklus, wird der vorherige Wert fortgeschrieben (um Lücken im Diagramm zu vermeiden).
- Online-Entscheidung: Ein Knoten gilt als online, wenn loadavg in den letzten 2 Zyklen vorhanden ist (ein ausgefallener Zyklus wird toleriert).
last_seen= der Zeitstempel des letzten Zyklus, der loadavg gemeldet hat. - 20-Sekunden-Cache:
Cache::remember("infr:srvmetric:v1:{points}", 20, …). Selbst bei einer 30-Sekunden-Abfrage läuft die eigentliche Datenbankabfrage daher höchstens alle 20 Sekunden. - Anreicherung von Bezeichnung/IP: Alias/Hostname (in Kleinbuchstaben) wird auf
namesowieip_public/ip_privateaus Instanzen (infr_instance) abgebildet, mit 60 s Cache. Nicht registrierte Knoten zeigen ihren rohen Alias an.
Registrierung und Zugangsdaten für den Collector run_report.js, der server_status befüllt, werden unter Verwaltung ▸ Collectors verwaltet.
Zugriff
- Nur-Lese-Bildschirm. Jede Benutzerin und jeder Benutzer, der die Konsolenauthentifizierung (
infr.auth) besteht, kann ihn ansehen (das minimaleuser_leveldes Rollenbereichs Infrastruktur ist 1 – also demo=1 und höher). - Keine Schreib- oder Steueraktionen – es gibt hier keine Schaltflächen zum Sperren oder Neustarten.
- Kartenreihenfolge und range-Auswahl werden nicht serverseitig gespeichert; sie leben ausschließlich im
localStoragedes Browsers (je Benutzer, je Browser).
Stufenschema: demo=1 · staff=5 · admin=10 (siehe RBAC-Stufen).
Fehlersuche und FAQ
Ich sehe nur „Keine Servermetriken.“
In server_status gibt es keine aktuelle Momentaufnahme. Prüfen Sie, ob der Collector run_report.js läuft und unter Collectors registriert ist. Prüfen Sie außerdem die Verbindung zur Alt-Datenbank (MAIN).
Ein Knoten wird als offline angezeigt.
Das bedeutet, dass in den letzten 2 Erfassungszyklen kein loadavg gemeldet wurde. Prüfen Sie den Laufstatus von run_report auf diesem Knoten, seine Uhr (Abweichung) und das Netzwerk. Die relative Bezeichnung last_seen sagt Ihnen, wann er zuletzt gemeldet hat.
Eine Karte zeigt einen Alias (z. B. sol) statt eines sprechenden Namens.
Dieser Alias ist nicht in Instanzen (infr_instance) registriert. Registrieren Sie die Instanz, dann wird ihr name zur Bezeichnung, und ip_public/ip_private werden als IP angezeigt.
Das Platten-Abzeichen ist leer.
Dieser Knoten hat keines von df-data/df-/df-home im JSON-Format {p,u,a} gemeldet. Für detaillierte Plattennutzung und RAID-Zustand verwenden Sie Speicher und RAID.
Der Load-Ring wirkt immer voll. Der Load-Ring ist mit einer Obergrenze von Last 8 normiert. Auf Servern mit vielen Kernen kann eine Last von 8 normal sein; beurteilen Sie daher nach dem absoluten Wert in der Ringmitte. Schließen Sie nicht allein aus den Farbton-Schwellenwerten (warn 8 / crit 16) auf eine Gefahr.
Es wird alle 30 s abgefragt, aber nichts ändert sich.
Entweder ist (1) noch kein neuer Erfassungszyklus (~5 Min.) eingetroffen, oder (2) Sie befinden sich innerhalb des 20-Sekunden-Cache-Fensters. Bestätigen Sie tatsächliche Aktualisierungen über stamp, die Fensterbezeichnung und rev (das letzte seq).
Ich habe range auf 3d gestellt, doch das Fenster wirkt kurz.
range bedeutet „die letzten N Zyklen“, daher deckt ein Knoten, der selten erfasst, nur eine kurze reale Zeitspanne ab. Die Fensterbezeichnung am unteren Rand zeigt die tatsächliche Spanne (45m/6h/2d). Die Obergrenze der Punktanzahl liegt bei 1000.
Verwandte Themen
- Zustand – Live-Status und Dienstpunkte (nginx/php/mysql) für dieselben Knoten.
- Speicher und RAID – Plattennutzung, Zustand des RAID-Controllers, Karte der physischen Platten.
- Traffic – Zeitreihen zu Bytes/Paketen der Netzwerk-E/A.
- Alarme – SMS/E-Mail an Empfänger bei Bedingungen zu Durchschnittslast und freiem Plattenplatz.
- Instanzen – die Quelle der Anreicherung Alias→Bezeichnung/IP (Asset-Register).
- Collectors – Register für den Collector
run_report, derserver_statusbefüllt.