Vue d’ensemble — à quoi sert cet écran
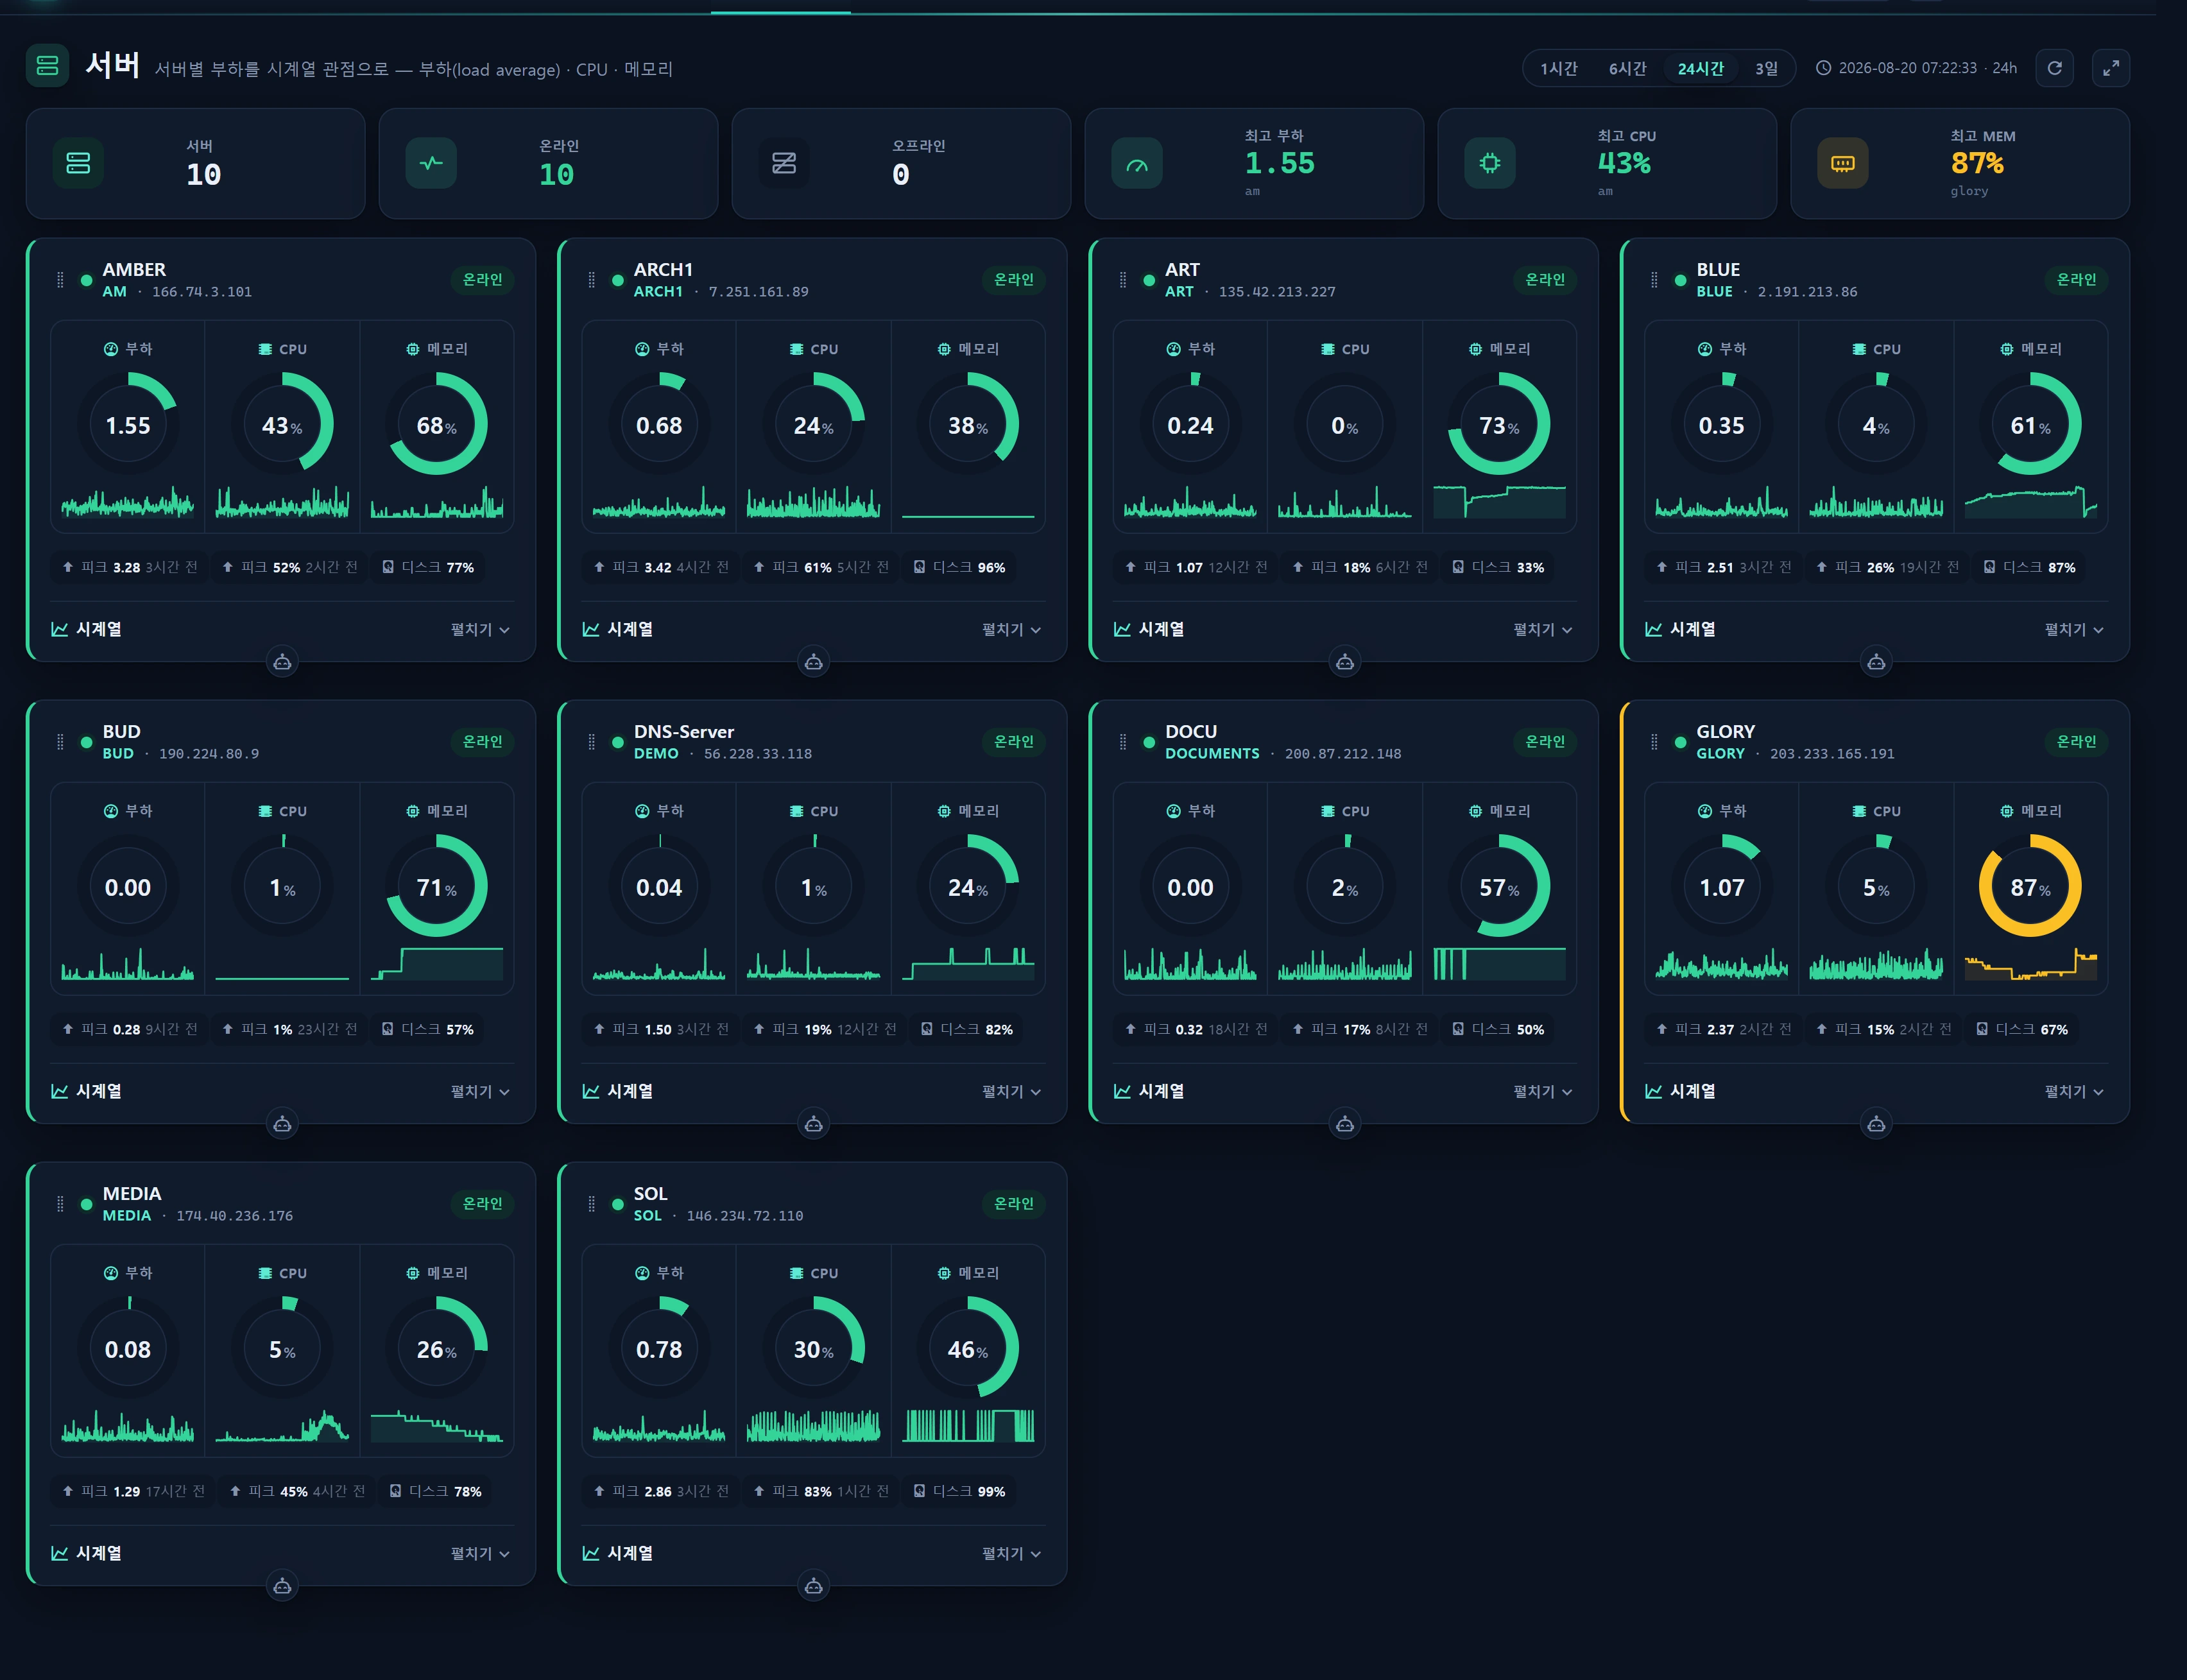
Infrastructure ▸ Serveurs (/infra/servers) affiche la charge moyenne · CPU · mémoire de chaque nœud serveur enregistré selon une perspective chronologique. Là où l’écran Santé saisit « l’état de chaque nœud à l’instant présent » grâce à des sondes en direct, l’écran Serveurs se concentre sur « la façon dont la charge a évolué au cours des dernières heures, voire des derniers jours ». Il s’agit d’une réimplémentation du monitoring/part de stats-design (load_average · cpu_usage · memory_usage).
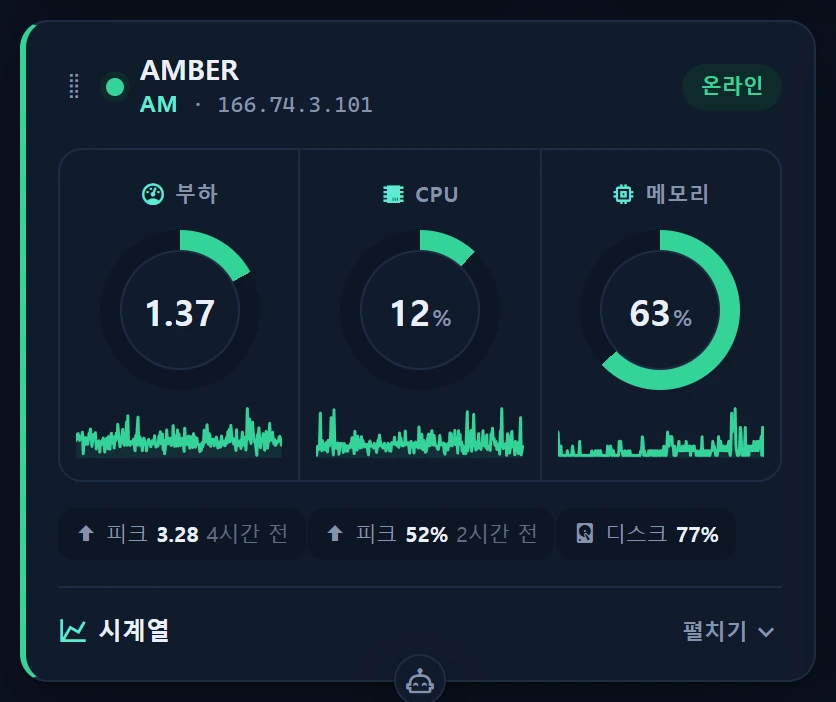
Une carte par nœud :
- Trois anneaux indicateurs (valeur actuelle de Load / CPU / MEM) — la gravité en un coup d’œil.
- Sparkline SVG — un aperçu de la tendance récente.
- [Détails] → graphique en courbes combiné ECharts (CPU% · MEM% sur l’axe de gauche + Load sur l’axe de droite) et tableau de statistiques (actuel / moyenne / min / max + heure du pic).
Les métriques proviennent de la table héritée server_status (en lecture seule). Le constructeur ServerMetricService restreint la requête à une fenêtre récente de seq (ce qui évite un balayage complet lent) et applique un cache de 20 secondes. La grille de cartes prend en charge la réorganisation par glisser-déposer + masonry et se rafraîchit automatiquement par interrogation toutes les 30 secondes.
server_statusest alimentée par le collecteur Noderun_report.js, qui s’exécute en dehors de Laravel selon un cycle d’environ 5 minutes. La résolution de l’axe temporel est donc d’environ 5 minutes, et l’écran se rafraîchit par interrogation (et non par envoi temps réel / Reverb).
Quand l’utiliser
- Pour comparer, sur l’ensemble du parc, quels serveurs supportent une charge élevée durable.
- Pour revenir sur les points d’inflexion des courbes de charge / CPU / mémoire autour du moment où un incident est survenu ou une alerte s’est déclenchée (l’heure du pic est également indiquée).
- Pour vérifier une tendance d’utilisation mémoire ou une saturation CPU après un déploiement ou un pic de trafic.
- En investigation complémentaire lorsque les Alertes se déclenchent sur des conditions de charge moyenne ou d’espace disque disponible — confirmez le nœud incriminé sur la série temporelle.
La surveillance de session en direct (avec les points de service nginx/php/mysql) se trouve dans Santé, les graphiques d’octets/paquets d’E/S réseau dans Trafic, et la santé disque / RAID dans Stockage et RAID.
Disposition
Barre de KPI supérieure
Calculée par ServerMetricService::kpi().
| KPI | Signification |
|---|---|
| Serveurs | Nombre total de nœuds présents dans la fenêtre |
| En ligne | Nœuds ayant remonté loadavg au cours des 2 derniers cycles de collecte |
| Hors ligne | Total − en ligne |
| Charge maximale | Nœud dont la charge sur 1 minute est la plus élevée + alias |
| CPU maximal | Nœud dont le CPU% actuel est le plus élevé + alias |
| Mémoire maximale | Nœud dont le pourcentage de mémoire actuel est le plus élevé + alias |
Sélecteur range
Sélectionne la fenêtre d’affichage (nombre de points de la fenêtre de seq). Le choix est conservé dans le localStorage (infr:range:infra-servers) et persiste d’une visite à l’autre.
| range | points de seq | ≈ fenêtre réelle (cycle de 5 min) |
|---|---|---|
| 1h | 12 | ~1 heure |
| 6h | 72 | ~6 heures |
| 24h | 288 | ~24 heures (par défaut) |
| 3d | 864 | ~3 jours |
range est converti en « les N derniers cycles de collecte » (et non en une durée absolue). Avec un cycle de 5 minutes, 24h ≈ 288 points. Un nœud qui remonte peu fréquemment peut afficher une fenêtre réelle plus courte pour un même range — l’étiquette de fenêtre en bas indique la durée réelle sous la forme
24h/6h/45m/2d.
Carte de nœud
┌──────────────────────────────────────────────┐
│ label · alias · IP           online / last Nm │   ← en-tête (libellé enrichi depuis infr_instance)
│  ( Load )   ( CPU )   ( MEM )                    │   ← 3 anneaux indicateurs (valeur actuelle)
│  ▁▂▅▇▅▃  sparkline (polyligne SVG)              │
│  peak · disk 42% · net out 1,234      [Détails] │   ← pied
└──────────────────────────────────────────────┘
La bordure de la carte et les anneaux sont peints avec une teinte de seuil ; la gravité globale de la carte suit la pire des trois métriques.
| Métrique | good | warn | crit |
|---|---|---|---|
| Load (1 min) | < 8 | ≥ 8 | ≥ 16 |
| CPU % | < 70 | ≥ 70 | ≥ 90 |
| MEM % | < 85 | ≥ 85 | ≥ 95 |
L’anneau Load est normalisé de sorte à être plein à une charge de 8 (
LOAD_FULL=8) — en cohérence avec le seuil warn. Sur une machine dotée de nombreux cœurs, une charge de 8 n’est pas nécessairement dangereuse : lisez donc toujours aussi la valeur absolue indiquée par le nombre au centre de l’anneau.
Détail déplié (ECharts + statistiques)
Un appui sur [Détails] agrandit la carte verticalement ; masonry réagence automatiquement le changement de hauteur.
- Graphique en courbes combiné :
CPU%·MEM%(axe de gauche 0–100 %) +Load(axe de droite, mise à l’échelle automatique). L’axe des x correspond au dernier horodatage de chaque cycle de collecte (HH:MM), avec une infobulle à réticule. - Tableau de statistiques : pour chaque métrique (charge / CPU / mémoire), les valeurs actuelle · moyenne · min · max, ainsi que le moment où le pic s’est produit (par exemple « pic il y a 12 min »).
Mode d’emploi
- Ouvrez
/infra/servers→ les cartes de nœuds sont disposées par ordre croissant d’alias. - Choisissez une fenêtre d’observation avec le sélecteur range (1h/6h/24h/3d). La requête est relancée immédiatement, indépendamment de l’interrogation périodique.
- Ouvrez le graphique chronologique et le tableau de statistiques d’un nœud avec [Détails].
- Survolez le graphique pour lire les valeurs CPU/MEM/Load à un instant donné grâce au réticule.
- Faites glisser les cartes pour remonter en haut les nœuds que vous surveillez le plus — l’ordre est conservé dans le
localStorage(infr:order:infra-servers). - Utilisez le bouton plein écran de l’en-tête pour masquer la navigation supérieure et consulter l’écran en mode tableau de bord.
L’écran se rafraîchit automatiquement toutes les 30 secondes en interrogeant /infra/servers/live (aucune interaction nécessaire). Cet écran ne comporte aucune action d’écriture ni de commande — il est purement d’observation.
Le front-end qui interroge décide s’il faut rafraîchir grâce au jeton de changement peu coûteux
rev(= le dernier seq deserver_status). Tant qu’un nouveau cycle de collecte n’est pas arrivé, l’écran reste en l’état — il n’est pas « figé », il n’existe simplement pas encore de nouvel instantané.
Sources de données
La source est la table héritée server_status (BD MAIN, schéma clé-valeur part, en lecture seule). Elle interprète directement la convention de stockage de run_report.js.
| part | Format de la valeur | Signification | Usage dans les séries |
|---|---|---|---|
loadavg |
"1m 5m 15m" séparées par des espaces (p. ex. "0.50 0.42 0.38") |
Charges moyennes | La série et l’anneau n’utilisent que la charge sur 1 minute ; le pied affiche aussi 5/15 min |
top |
"NN%" (p. ex. "3.6%") |
Utilisation CPU en mode utilisateur | Série/anneau CPU |
free |
"NN%" |
Utilisation mémoire = round(used/total×100) | Série/anneau MEM |
df-data / df- / df-home |
JSON {p,u,a} |
Pourcentage disque (p) · utilisé (u) · taille (a) | Badge disque le plus récent (priorité df-data → df- → df-home) |
traffic-out |
numérique | Delta de paquets sortants réseau | Série/pied net |
Discipline de requête et de mise en forme :
- Fenêtre de seq :
SELECT DISTINCT seq ORDER BY seq DESC LIMIT N(balayage d’index) ne retient que les N derniers cycles de collecte, puis ces valeurs de seq/part alimentent une requêtewhereIn— ainsi, même une table de 200 millions de lignes ne balaie qu’une fenêtre étroite. Même discipline queOverviewService/HealthService. - seq = identifiant de lot d’un instantané couvrant tout le parc. Les séries sont toujours triées du passé vers le présent.
- Report des valeurs manquantes : si un part est absent pour un cycle, la valeur précédente est reportée (afin d’éviter des trous dans le graphique).
- Décision « en ligne » : un nœud est en ligne si loadavg est présent sur les 2 derniers cycles (un cycle manqué est toléré).
last_seen= l’horodatage du dernier cycle ayant remonté loadavg. - Cache de 20 secondes :
Cache::remember("infr:srvmetric:v1:{points}", 20, …). Ainsi, même avec une interrogation toutes les 30 secondes, la requête réelle en base ne s’exécute au maximum qu’une fois toutes les 20 secondes. - Enrichissement libellé/IP : l’alias/nom d’hôte (en minuscules) est mis en correspondance avec
nameetip_public/ip_privateissus des Instances (infr_instance), avec un cache de 60 s. Les nœuds non enregistrés affichent leur alias brut.
L’enregistrement et les identifiants du collecteur run_report.js qui alimente server_status sont gérés dans Administration ▸ Collecteurs.
Accès
- Écran en lecture seule. Tout utilisateur qui passe l’authentification de la console (
infr.auth) peut le consulter (leuser_levelminimal de la zone de rôle Infrastructure est 1, c’est-à-dire demo=1 et au-delà). - Aucune action d’écriture ni de commande — il n’y a ici ni bouton de blocage ni bouton de redémarrage.
- L’ordre des cartes et la sélection de range ne sont pas stockés côté serveur ; ils vivent uniquement dans le
localStoragedu navigateur (par utilisateur et par navigateur).
Échelle des niveaux : demo=1 · staff=5 · admin=10 (voir Niveaux RBAC).
Dépannage et FAQ
Je ne vois que « Aucune métrique de serveur. »
Il n’existe aucun instantané récent dans server_status. Vérifiez que le collecteur run_report.js fonctionne et qu’il est enregistré dans Collecteurs. Vérifiez également la connexion à la BD héritée (MAIN).
Un nœud apparaît hors ligne.
Cela signifie qu’aucun loadavg n’a été remonté au cours des 2 derniers cycles de collecte. Vérifiez l’état d’exécution de run_report sur ce nœud, son horloge (dérive) et le réseau. L’étiquette relative last_seen vous indique la date de sa dernière remontée.
Une carte affiche un alias (p. ex. sol) au lieu d’un nom lisible.
Cet alias n’est pas enregistré dans les Instances (infr_instance). Enregistrez l’instance et son name devient le libellé, avec ip_public/ip_private affichés comme IP.
Le badge disque est vide.
Ce nœud n’a remonté aucun de df-data/df-/df-home au format JSON {p,u,a}. Pour l’utilisation disque détaillée et la santé RAID, utilisez Stockage et RAID.
L’anneau Load paraît toujours plein. L’anneau Load est normalisé avec un plafond à une charge de 8. Sur des serveurs à nombreux cœurs, une charge de 8 peut être normale : jugez donc d’après la valeur absolue affichée au centre de l’anneau. Ne concluez pas au danger sur la seule base des seuils de teinte (warn 8 / crit 16).
L’interrogation a lieu toutes les 30 s mais rien ne change.
Soit (1) un nouveau cycle de collecte (~5 min) n’est pas encore arrivé, soit (2) vous vous trouvez dans la fenêtre de cache de 20 secondes. Confirmez les mises à jour réelles via stamp, l’étiquette de fenêtre et rev (le dernier seq).
J’ai réglé range sur 3d mais la fenêtre paraît courte.
range signifie « les N derniers cycles » : un nœud qui collecte peu fréquemment couvre donc une durée réelle courte. L’étiquette de fenêtre du bas affiche la durée réelle (45m/6h/2d). Le plafond du nombre de points est de 1000.
Rubriques liées
- Santé — état en direct et points de service (nginx/php/mysql) pour les mêmes nœuds.
- Stockage et RAID — utilisation disque, santé du contrôleur RAID, carte des disques physiques.
- Trafic — séries temporelles d’octets/paquets d’E/S réseau.
- Alertes — SMS/e-mail aux destinataires sur les conditions de charge moyenne et d’espace disque disponible.
- Instances — la source de l’enrichissement alias→libellé/IP (registre des actifs).
- Collecteurs — registre du collecteur
run_reportqui alimenteserver_status.