概览 —— 这个页面做什么
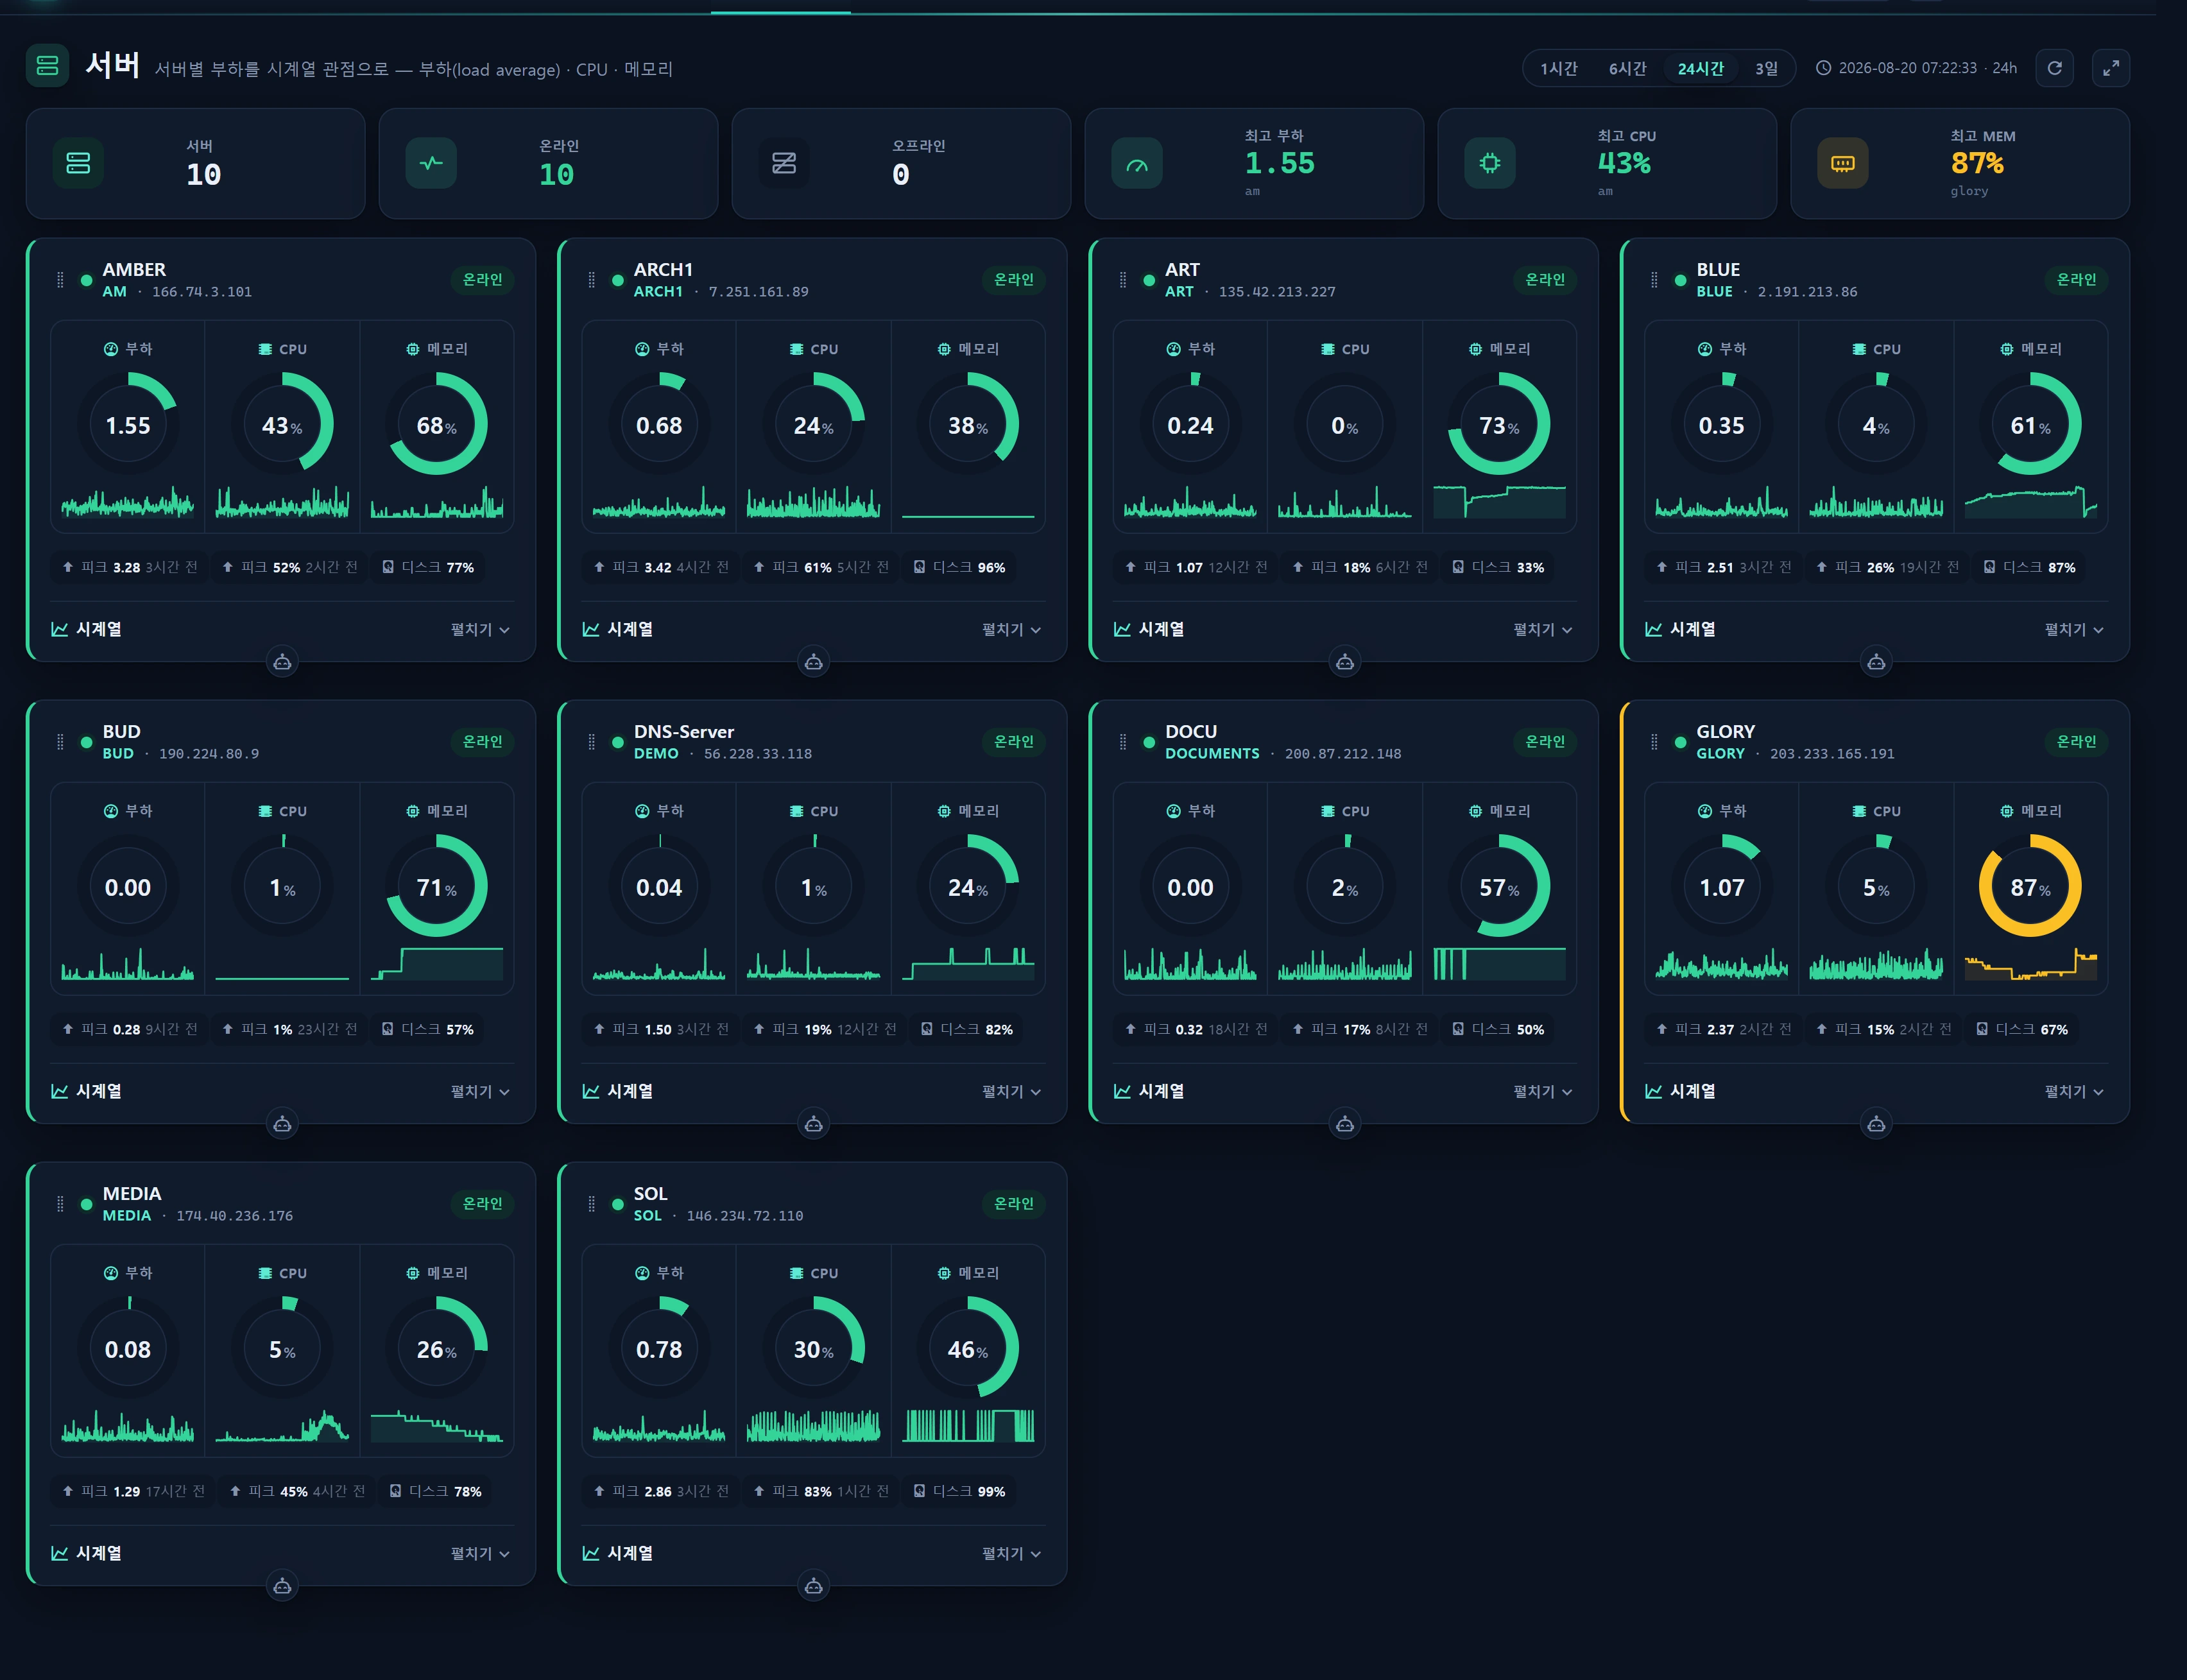
基础设施 ▸ 服务器(/infra/servers)以时间序列视角展示每个已注册服务器节点的平均负载 · CPU · 内存。健康状态 页面通过实时探测捕捉“每个节点此刻的状态”,而服务器页面聚焦于“过去几小时到几天里负载是如何变化的”。它是对 stats-design 的 monitoring/part(load_average · cpu_usage · memory_usage)的重新实现。
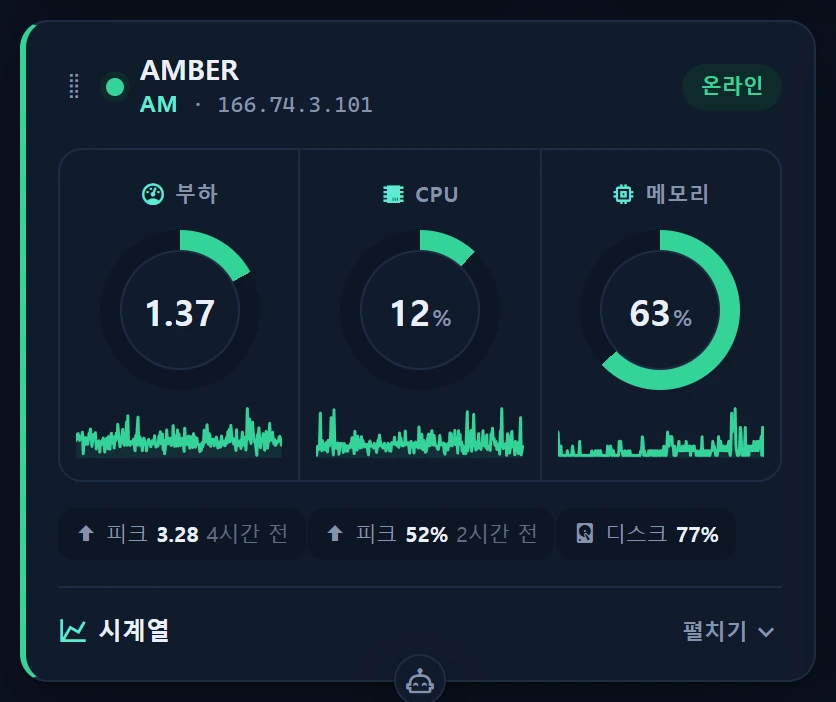
每个节点一张卡片:
- 三个环形仪表(Load / CPU / MEM 当前值)—— 一眼看出严重程度。
- SVG 迷你曲线 —— 近期趋势的预览。
- [详情] → ECharts 组合折线图(左轴 CPU% · MEM%,右轴 Load)以及统计表(当前 / 平均 / 最小 / 最大 + 峰值时刻)。
指标来自遗留的 server_status 表(只读)。构建器 ServerMetricService 将查询收窄到最近的 seq 窗口(避免全表扫描造成慢查询),并应用 20 秒缓存。卡片网格支持拖拽排序 + 瀑布流布局,并通过 30 秒轮询自动刷新。
server_status由运行在 Laravel 之外、约 5 分钟一个周期的 Node 采集器run_report.js写入。因此时间轴的分辨率约为 5 分钟,页面通过轮询刷新(而不是实时推送 / Reverb)。
使用场景
- 在整个服务器群中比较哪些服务器承受着持续的高负载。
- 在故障或告警发生的时刻前后,回溯负载 / CPU / 内存曲线的拐点(同时会显示峰值时刻)。
- 在发布或流量高峰之后,查看内存使用趋势或 CPU 饱和情况。
- 当 告警 因平均负载或磁盘余量条件触发时,作为后续排查手段 —— 在时间序列上确认出问题的节点。
实时会话监控(含 nginx/php/mysql 的服务状态点)位于 健康状态,网络 I/O 的字节 / 数据包图表位于 流量,磁盘与 RAID 健康状况位于 存储与 RAID。
布局
顶部 KPI 栏
由 ServerMetricService::kpi() 计算。
| KPI | 含义 |
|---|---|
| 服务器 | 窗口内出现的节点总数 |
| 在线 | 在最近 2 个采集周期内上报过 loadavg 的节点 |
| 离线 | 总数 − 在线数 |
| 负载最高 | 当前 1 分钟负载最高的节点 + 别名 |
| CPU 最高 | 当前 CPU% 最高的节点 + 别名 |
| 内存最高 | 当前内存 % 最高的节点 + 别名 |
range 切换
选择显示窗口(seq 窗口的点数)。所选内容保存在 localStorage(infr:range:infra-servers)中,再次访问时依然保留。
| range | seq 点数 | ≈ 实际窗口(5 分钟周期) |
|---|---|---|
| 1h | 12 | 约 1 小时 |
| 6h | 72 | 约 6 小时 |
| 24h | 288 | 约 24 小时(默认) |
| 3d | 864 | 约 3 天 |
range 会被换算为“最近 N 个采集周期”(而不是绝对的时间跨度)。在 5 分钟周期下,24h ≈ 288 个点。上报不频繁的节点在相同 range 下实际窗口可能更短 —— 底部的窗口标签会以
24h/6h/45m/2d的形式给出真实跨度。
节点卡片
┌──────────────────────────────────────────────┐
│ label · alias · IP           online / last Nm │   ← 页眉(标签由 infr_instance 补全)
│  ( Load )   ( CPU )   ( MEM )                    │   ← 3 个环形仪表(当前值)
│  ▁▂▅▇▅▃  迷你曲线(SVG polyline)               │
│  peak · disk 42% · net out 1,234        [详情] │   ← 页脚
└──────────────────────────────────────────────┘
卡片边框与仪表按阈值色调绘制;卡片整体的严重程度取三项指标中最差的一项。
| 指标 | good | warn | crit |
|---|---|---|---|
| Load(1 分钟) | < 8 | ≥ 8 | ≥ 16 |
| CPU % | < 70 | ≥ 70 | ≥ 90 |
| MEM % | < 85 | ≥ 85 | ≥ 95 |
Load 环经过归一化,使其在 load 8 时充满(
LOAD_FULL=8)—— 与 warn 阈值保持一致。在核心数很多的机器上,load 8 未必危险,因此请务必同时读取环中心数字给出的绝对值。
展开详情(ECharts + 统计)
按下 [详情] 会让卡片纵向展开;瀑布流布局会自动重排高度变化。
- 组合折线图:
CPU%·MEM%(左轴 0–100%)+Load(右轴,自动缩放)。x 轴为每个采集周期的最新时间戳(HH:MM),带十字准线提示框。 - 统计表:针对每项指标(load / CPU / 内存)给出当前 · 平均 · 最小 · 最大,以及峰值出现的时刻(例如“12 分钟前达到峰值”)。
使用方法
- 打开
/infra/servers→ 节点卡片按别名升序排列。 - 用 range 切换(1h/6h/24h/3d)选择观察窗口。它会立即重新查询,与轮询无关。
- 用 [详情] 打开某个节点的时间序列图与统计表。
- 将鼠标悬停在图表上,通过十字准线读取某一时刻的 CPU/MEM/Load 数值。
- 拖拽卡片,把你最常关注的节点移到最上面 —— 顺序保存在
localStorage(infr:order:infra-servers)中。 - 使用页眉中的全屏按钮隐藏顶部导航,以看板模式查看。
页面通过轮询 /infra/servers/live 每 30 秒自动刷新一次(无需任何操作)。本页面没有写入 / 控制类操作 —— 它纯粹用于观察。
轮询的前端使用轻量的变更令牌
rev(=server_status的最新 seq)来判断是否需要刷新。在新的采集周期到来之前页面保持不动 —— 这不是“卡住了”,只是还没有新的快照。
数据来源
数据源是遗留的 server_status 表(MAIN 库,键值式 part 结构,只读)。它直接按照 run_report.js 的存储约定进行解释。
| part | 值格式 | 含义 | 序列用途 |
|---|---|---|---|
loadavg |
"1m 5m 15m" 以空格分隔(例如 "0.50 0.42 0.38") |
平均负载 | 序列与环仅使用 1 分钟负载;页脚另外显示 5/15 分钟值 |
top |
"NN%"(例如 "3.6%") |
CPU 用户态占用 | CPU 序列 / 环 |
free |
"NN%" |
内存使用率 = round(used/total×100) | MEM 序列 / 环 |
df-data / df- / df-home |
JSON {p,u,a} |
磁盘百分比 (p) · 已用 (u) · 容量 (a) | 最新磁盘徽标(df-data → df- → df-home 优先级) |
traffic-out |
数值 | 网络出方向数据包增量 | net 序列 / 页脚 |
查询与整形的纪律:
- seq 窗口:
SELECT DISTINCT seq ORDER BY seq DESC LIMIT N(索引扫描)只挑出最近 N 个采集周期,随后用这些 seq/part 值驱动whereIn查询 —— 因此即使是 2 亿行的表也只扫描一个很窄的窗口。与OverviewService/HealthService的纪律相同。 - seq = 全服务器群一次快照的批次 id。序列始终按由过去到现在排序。
- 缺失值前向填充:若某个周期缺少某个 part,则沿用前一个值(以免图表出现断口)。
- 在线判定:若最近 2 个周期内出现过 loadavg,则该节点在线(允许丢失一个周期)。
last_seen= 最后一次上报 loadavg 的周期时间戳。 - 20 秒缓存:
Cache::remember("infr:srvmetric:v1:{points}", 20, …)。因此即使采用 30 秒轮询,真正的数据库查询最多也只有每 20 秒一次。 - 标签 / IP 补全:把别名 / 主机名(转为小写)映射到 实例(
infr_instance)中的name与ip_public/ip_private,缓存 60 秒。未注册的节点显示其原始别名。
填充 server_status 的 run_report.js 采集器,其注册与凭据在 管理 ▸ 采集器 中管理。
访问权限
- 只读页面。 任何通过控制台认证(
infr.auth)的用户都可以查看(基础设施角色区域的最低user_level为 1,即 demo=1 及以上)。 - 没有写入 / 控制类操作 —— 这里没有封禁或重启按钮。
- 卡片顺序与 range 选择不会保存在服务端;它们只存在于浏览器的
localStorage(按用户、按浏览器)。
级别体系:demo=1 · staff=5 · admin=10(参见 RBAC 级别)。
排查与常见问题
我只看到“暂无服务器指标。”
server_status 中没有近期快照。请检查 run_report.js 采集器是否正在运行,以及是否已在 采集器 中注册。另请确认遗留(MAIN)库的连接。
某个节点显示为离线。
这表示最近 2 个采集周期内没有上报 loadavg。请检查该节点的 run_report 运行状态、时钟(偏移)以及网络。last_seen 的相对标签会告诉你它最后一次上报的时间。
卡片显示的是别名(例如 sol)而不是易读的名称。
该别名未在 实例(infr_instance)中注册。注册该实例后,其 name 会成为标签,并以 ip_public/ip_private 作为 IP 显示。
磁盘徽标是空的。
该节点没有以 JSON {p,u,a} 格式上报 df-data/df-/df-home 中的任何一项。若需查看详细的磁盘使用率与 RAID 健康状况,请使用 存储与 RAID。
Load 环看起来总是满的。 Load 环以 load 8 为上限进行归一化。在多核服务器上 load 8 可能是正常的,因此请以环中心显示的绝对值为准。不要仅凭颜色色调阈值(warn 8 / crit 16)就断定处于危险状态。
每 30 秒轮询一次,但什么都没变。
要么是 (1) 新的采集周期(约 5 分钟)尚未到来,要么是 (2) 你正处在 20 秒缓存窗口内。可通过 stamp、窗口标签以及 rev(最新 seq)确认是否真的有更新。
我把 range 设成了 3d,但窗口看起来很短。
range 的含义是“最近 N 个周期”,因此采集频率低的节点其真实时间跨度会很短。底部的窗口标签会显示实际跨度(45m/6h/2d)。点数上限为 1000。
相关内容
- 健康状态 —— 同一批节点的实时状态与服务状态点(nginx/php/mysql)。
- 存储与 RAID —— 磁盘使用率、RAID 控制器健康状况、物理磁盘图。
- 流量 —— 网络 I/O 的字节 / 数据包时间序列。
- 告警 —— 在平均负载与磁盘余量条件下向责任人发送短信 / 邮件。
- 实例 —— 别名→标签 / IP 补全的来源(资产台账)。
- 采集器 —— 填充
server_status的run_report采集器注册表。