Resumen: qué hace
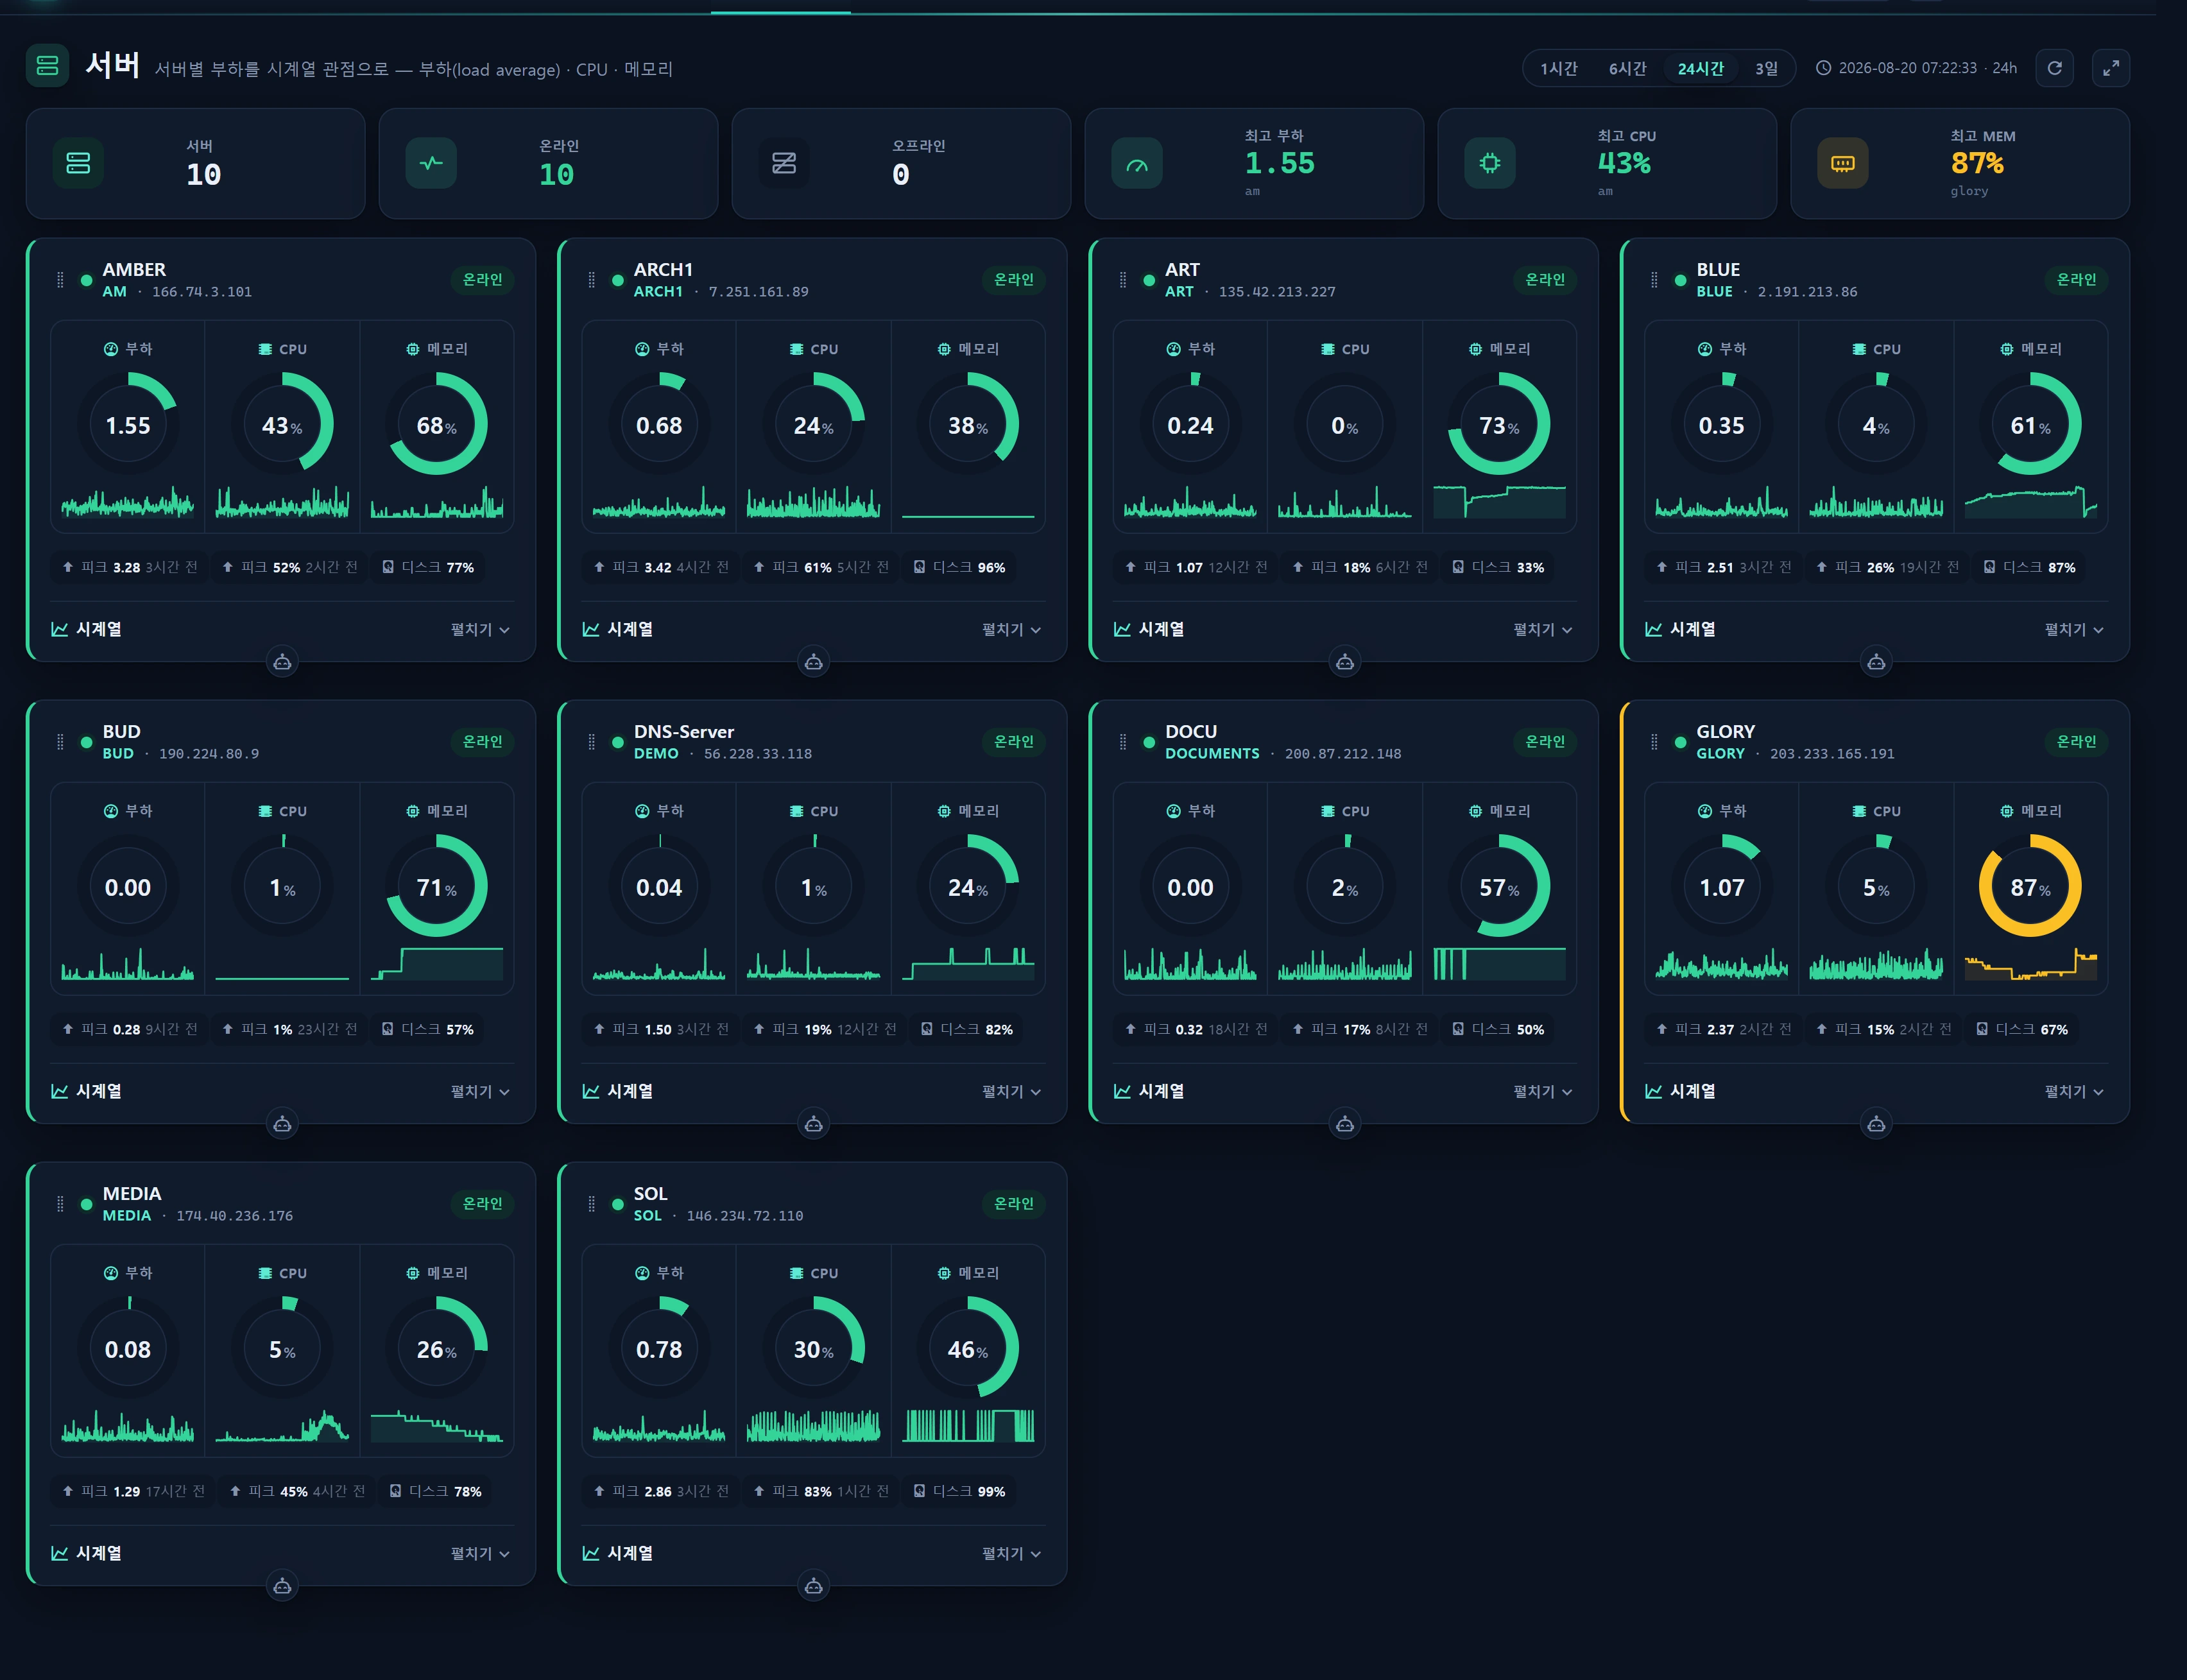
Infraestructura ▸ Servidores (/infra/servers) muestra la carga media · CPU · memoria de cada nodo de servidor registrado desde una perspectiva de series temporales. Mientras que la pantalla Estado capta «el estado de cada nodo en este momento» mediante sondeos en vivo, la pantalla Servidores se centra en «cómo ha evolucionado la carga durante las últimas horas o días». Es una reimplementación de monitoring/part de stats-design (load_average · cpu_usage · memory_usage).
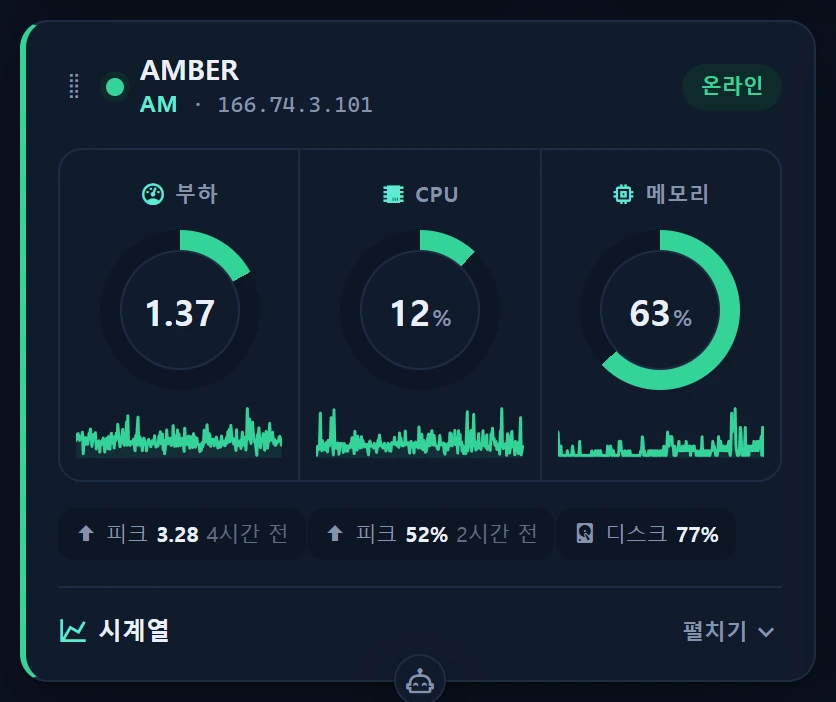
Una tarjeta por nodo:
- Tres anillos indicadores (valor actual de Load / CPU / MEM): la gravedad de un vistazo.
- Minigráfico SVG: una vista previa de la tendencia reciente.
- [Detalles] → gráfico de líneas combinado de ECharts (CPU% · MEM% en el eje izquierdo + Load en el eje derecho) y una tabla de estadísticas (actual / media / mínimo / máximo + hora del pico).
Las métricas proceden de la tabla heredada server_status (solo lectura). El constructor ServerMetricService acota la consulta a una ventana reciente de seq (evitando un recorrido completo lento) y aplica una caché de 20 segundos. La cuadrícula de tarjetas admite reordenación por arrastre + masonry y se refresca automáticamente mediante sondeo cada 30 segundos.
server_statusla rellena el recolector Noderun_report.js, que se ejecuta fuera de Laravel con un ciclo de aproximadamente 5 minutos. Por tanto, la resolución del eje temporal es de unos 5 minutos y la pantalla se actualiza por sondeo (no mediante inserción en tiempo real / Reverb).
Cuándo utilizarla
- Para comparar qué servidores soportan una carga alta sostenida en todo el parque.
- Para revisar los puntos de inflexión de las curvas de carga / CPU / memoria alrededor del momento en que se produjo un incidente o se disparó una alerta (también se muestra la hora del pico).
- Para comprobar una tendencia de uso de memoria o una saturación de CPU tras un despliegue o un pico de tráfico.
- Como investigación posterior cuando las Alertas se disparan por condiciones de carga media o de espacio libre en disco: confirme el nodo implicado en la serie temporal.
La supervisión de sesión en vivo (con los puntos de servicio de nginx/php/mysql) está en Estado, los gráficos de bytes/paquetes de E/S de red en Tráfico, y la salud de disco y RAID en Almacenamiento y RAID.
Diseño de la pantalla
Barra superior de KPI
La calcula ServerMetricService::kpi().
| KPI | Significado |
|---|---|
| Servidores | Número total de nodos presentes en la ventana |
| En línea | Nodos que han informado de loadavg en los últimos 2 ciclos de recolección |
| Fuera de línea | Total − en línea |
| Mayor carga | Nodo con la carga de 1 minuto más alta + alias |
| Mayor CPU | Nodo con el CPU% actual más alto + alias |
| Mayor memoria | Nodo con el porcentaje de memoria actual más alto + alias |
Selector de range
Selecciona la ventana de visualización (número de puntos de la ventana de seq). La elección se guarda en localStorage (infr:range:infra-servers) y se conserva entre visitas.
| range | puntos de seq | ≈ ventana real (ciclo de 5 min) |
|---|---|---|
| 1h | 12 | ~1 hora |
| 6h | 72 | ~6 horas |
| 24h | 288 | ~24 horas (predeterminado) |
| 3d | 864 | ~3 días |
range se convierte en «los últimos N ciclos de recolección» (no en un intervalo de tiempo absoluto). Con un ciclo de 5 minutos, 24h ≈ 288 puntos. Un nodo que informa con poca frecuencia puede mostrar una ventana real más corta para el mismo range: la etiqueta de ventana de la parte inferior indica el intervalo real como
24h/6h/45m/2d.
Tarjeta de nodo
┌──────────────────────────────────────────────┐
│ label · alias · IP           online / last Nm │   ← cabecera (etiqueta enriquecida desde infr_instance)
│  ( Load )   ( CPU )   ( MEM )                    │   ← 3 anillos indicadores (valor actual)
│  ▁▂▅▇▅▃  minigráfico (polilínea SVG)            │
│  peak · disk 42% · net out 1,234     [Detalles] │   ← pie
└──────────────────────────────────────────────┘
El borde de la tarjeta y los anillos se pintan con un tono de umbral; la gravedad global de la tarjeta sigue a la peor de las tres métricas.
| Métrica | good | warn | crit |
|---|---|---|---|
| Load (1 min) | < 8 | ≥ 8 | ≥ 16 |
| CPU % | < 70 | ≥ 70 | ≥ 90 |
| MEM % | < 85 | ≥ 85 | ≥ 95 |
El anillo de Load está normalizado de modo que se llena en carga 8 (
LOAD_FULL=8), en consonancia con el umbral de warn. En una máquina con muchos núcleos, una carga de 8 no es necesariamente peligrosa, así que lea siempre también el valor absoluto que aparece en el número del centro del anillo.
Detalle expandido (ECharts + estadísticas)
Al pulsar [Detalles] la tarjeta crece en vertical; masonry recoloca automáticamente el cambio de altura.
- Gráfico de líneas combinado:
CPU%·MEM%(eje izquierdo 0–100%) +Load(eje derecho, escalado automático). El eje x es la marca de tiempo más reciente de cada ciclo de recolección (HH:MM), con un tooltip de retícula. - Tabla de estadísticas: para cada métrica (carga / CPU / memoria), el valor actual · medio · mínimo · máximo, además de cuándo se produjo el pico (por ejemplo, «pico hace 12 min»).
Cómo usarla
- Abra
/infra/servers→ las tarjetas de nodo se disponen en orden ascendente de alias. - Elija una ventana de observación con el selector range (1h/6h/24h/3d). Vuelve a consultar de inmediato, con independencia del sondeo.
- Abra el gráfico de series temporales y la tabla de estadísticas de un nodo con [Detalles].
- Pase el cursor por el gráfico para leer los valores de CPU/MEM/Load en un instante concreto mediante la retícula.
- Arrastre las tarjetas para llevar arriba los nodos que más vigila: el orden se conserva en
localStorage(infr:order:infra-servers). - Use el botón de pantalla completa de la cabecera para ocultar la navegación superior y ver la pantalla en modo panel.
La pantalla se refresca automáticamente cada 30 segundos sondeando /infra/servers/live (sin necesidad de interacción). Esta pantalla no tiene acciones de escritura ni de control: es puramente de observación.
El front-end que sondea decide si hace falta refrescar usando el token de cambio económico
rev(= el último seq deserver_status). Hasta que llega un nuevo ciclo de recolección, la pantalla no se mueve; eso no significa que esté «congelada», simplemente todavía no hay una instantánea nueva.
Fuentes de datos
La fuente es la tabla heredada server_status (BD MAIN, esquema clave-valor con part, solo lectura). Interpreta directamente la convención de almacenamiento de run_report.js.
| part | Formato del valor | Significado | Uso en las series |
|---|---|---|---|
loadavg |
"1m 5m 15m" separados por espacios (p. ej. "0.50 0.42 0.38") |
Cargas medias | La serie y el anillo usan solo la carga de 1 minuto; el pie muestra además las de 5/15 min |
top |
"NN%" (p. ej. "3.6%") |
Uso de CPU en modo usuario | Serie/anillo de CPU |
free |
"NN%" |
Uso de memoria = round(used/total×100) | Serie/anillo de MEM |
df-data / df- / df-home |
JSON {p,u,a} |
Porcentaje de disco (p) · usado (u) · tamaño (a) | Distintivo de disco más reciente (prioridad df-data → df- → df-home) |
traffic-out |
numérico | Delta de paquetes de salida de red | Serie/pie de net |
Disciplina de consulta y de modelado:
- Ventana de seq:
SELECT DISTINCT seq ORDER BY seq DESC LIMIT N(recorrido de índice) selecciona solo los últimos N ciclos de recolección, y esos valores de seq/part alimentan después una consultawhereIn, de modo que incluso una tabla de 200 millones de filas solo recorre una ventana estrecha. La misma disciplina queOverviewService/HealthService. - seq = identificador de lote de una instantánea de todo el parque. Las series se ordenan siempre del pasado al presente.
- Arrastre de valores ausentes: si falta un part en un ciclo, se arrastra el valor anterior (para evitar huecos en el gráfico).
- Decisión de estado en línea: un nodo está en línea si aparece loadavg en los últimos 2 ciclos (se tolera un ciclo perdido).
last_seen= la marca de tiempo del último ciclo que informó de loadavg. - Caché de 20 segundos:
Cache::remember("infr:srvmetric:v1:{points}", 20, …). Así, incluso con un sondeo de 30 segundos, la consulta real a la base de datos se ejecuta como mucho una vez cada 20 segundos. - Enriquecimiento de etiqueta/IP: el alias/nombre de host (en minúsculas) se asocia a
namey aip_public/ip_privatede Instancias (infr_instance), con caché de 60 s. Los nodos no registrados muestran su alias en bruto.
El registro y las credenciales del recolector run_report.js que rellena server_status se gestionan en Administración ▸ Recolectores.
Acceso
- Pantalla de solo lectura. Puede verla cualquier usuario que supere la autenticación de la consola (
infr.auth) (eluser_levelmínimo del área de rol de Infraestructura es 1, es decir, demo=1 y superiores). - Sin acciones de escritura ni de control: aquí no hay botones de bloqueo ni de reinicio.
- El orden de las tarjetas y la selección de range no se guardan en el servidor; viven únicamente en el
localStoragedel navegador (por usuario y por navegador).
Esquema de niveles: demo=1 · staff=5 · admin=10 (véase Niveles RBAC).
Resolución de problemas y preguntas frecuentes
Solo veo «No hay métricas de servidor.»
No hay ninguna instantánea reciente en server_status. Compruebe que el recolector run_report.js está en ejecución y registrado en Recolectores. Verifique también la conexión a la BD heredada (MAIN).
Un nodo aparece como fuera de línea.
Significa que no se informó de ningún loadavg en los últimos 2 ciclos de recolección. Compruebe el estado de ejecución de run_report en ese nodo, su reloj (desfase) y la red. La etiqueta relativa last_seen indica cuándo informó por última vez.
Una tarjeta muestra un alias (p. ej. sol) en lugar de un nombre legible.
Ese alias no está registrado en Instancias (infr_instance). Registre la instancia y su name pasará a ser la etiqueta, con ip_public/ip_private mostrados como IP.
El distintivo de disco está vacío.
Ese nodo no informó de ninguno de df-data/df-/df-home en el formato JSON {p,u,a}. Para ver el uso de disco detallado y la salud del RAID, utilice Almacenamiento y RAID.
El anillo de Load parece siempre lleno. El anillo de Load se normaliza con un techo de carga 8. En servidores con muchos núcleos, una carga de 8 puede ser normal, así que juzgue por el valor absoluto que aparece en el centro del anillo. No concluya que hay peligro basándose solo en los umbrales de tono de color (warn 8 / crit 16).
Sondea cada 30 s pero no cambia nada.
O bien (1) todavía no ha llegado un nuevo ciclo de recolección (~5 min), o bien (2) está dentro de la ventana de caché de 20 segundos. Confirme las actualizaciones reales mediante stamp, la etiqueta de ventana y rev (el último seq).
He puesto range en 3d, pero la ventana parece corta.
range significa «los últimos N ciclos», de modo que un nodo que recolecta con poca frecuencia tiene un intervalo real corto. La etiqueta de ventana inferior muestra el intervalo real (45m/6h/2d). El techo de número de puntos es 1000.
Contenido relacionado
- Estado: estado en vivo y puntos de servicio (nginx/php/mysql) de los mismos nodos.
- Almacenamiento y RAID: uso de disco, salud del controlador RAID, mapa de discos físicos.
- Tráfico: series temporales de bytes/paquetes de E/S de red.
- Alertas: SMS/correo a los destinatarios ante condiciones de carga media y de espacio libre en disco.
- Instancias: la fuente del enriquecimiento alias→etiqueta/IP (registro de activos).
- Recolectores: registro del recolector
run_reportque rellenaserver_status.