Resumen: qué hace
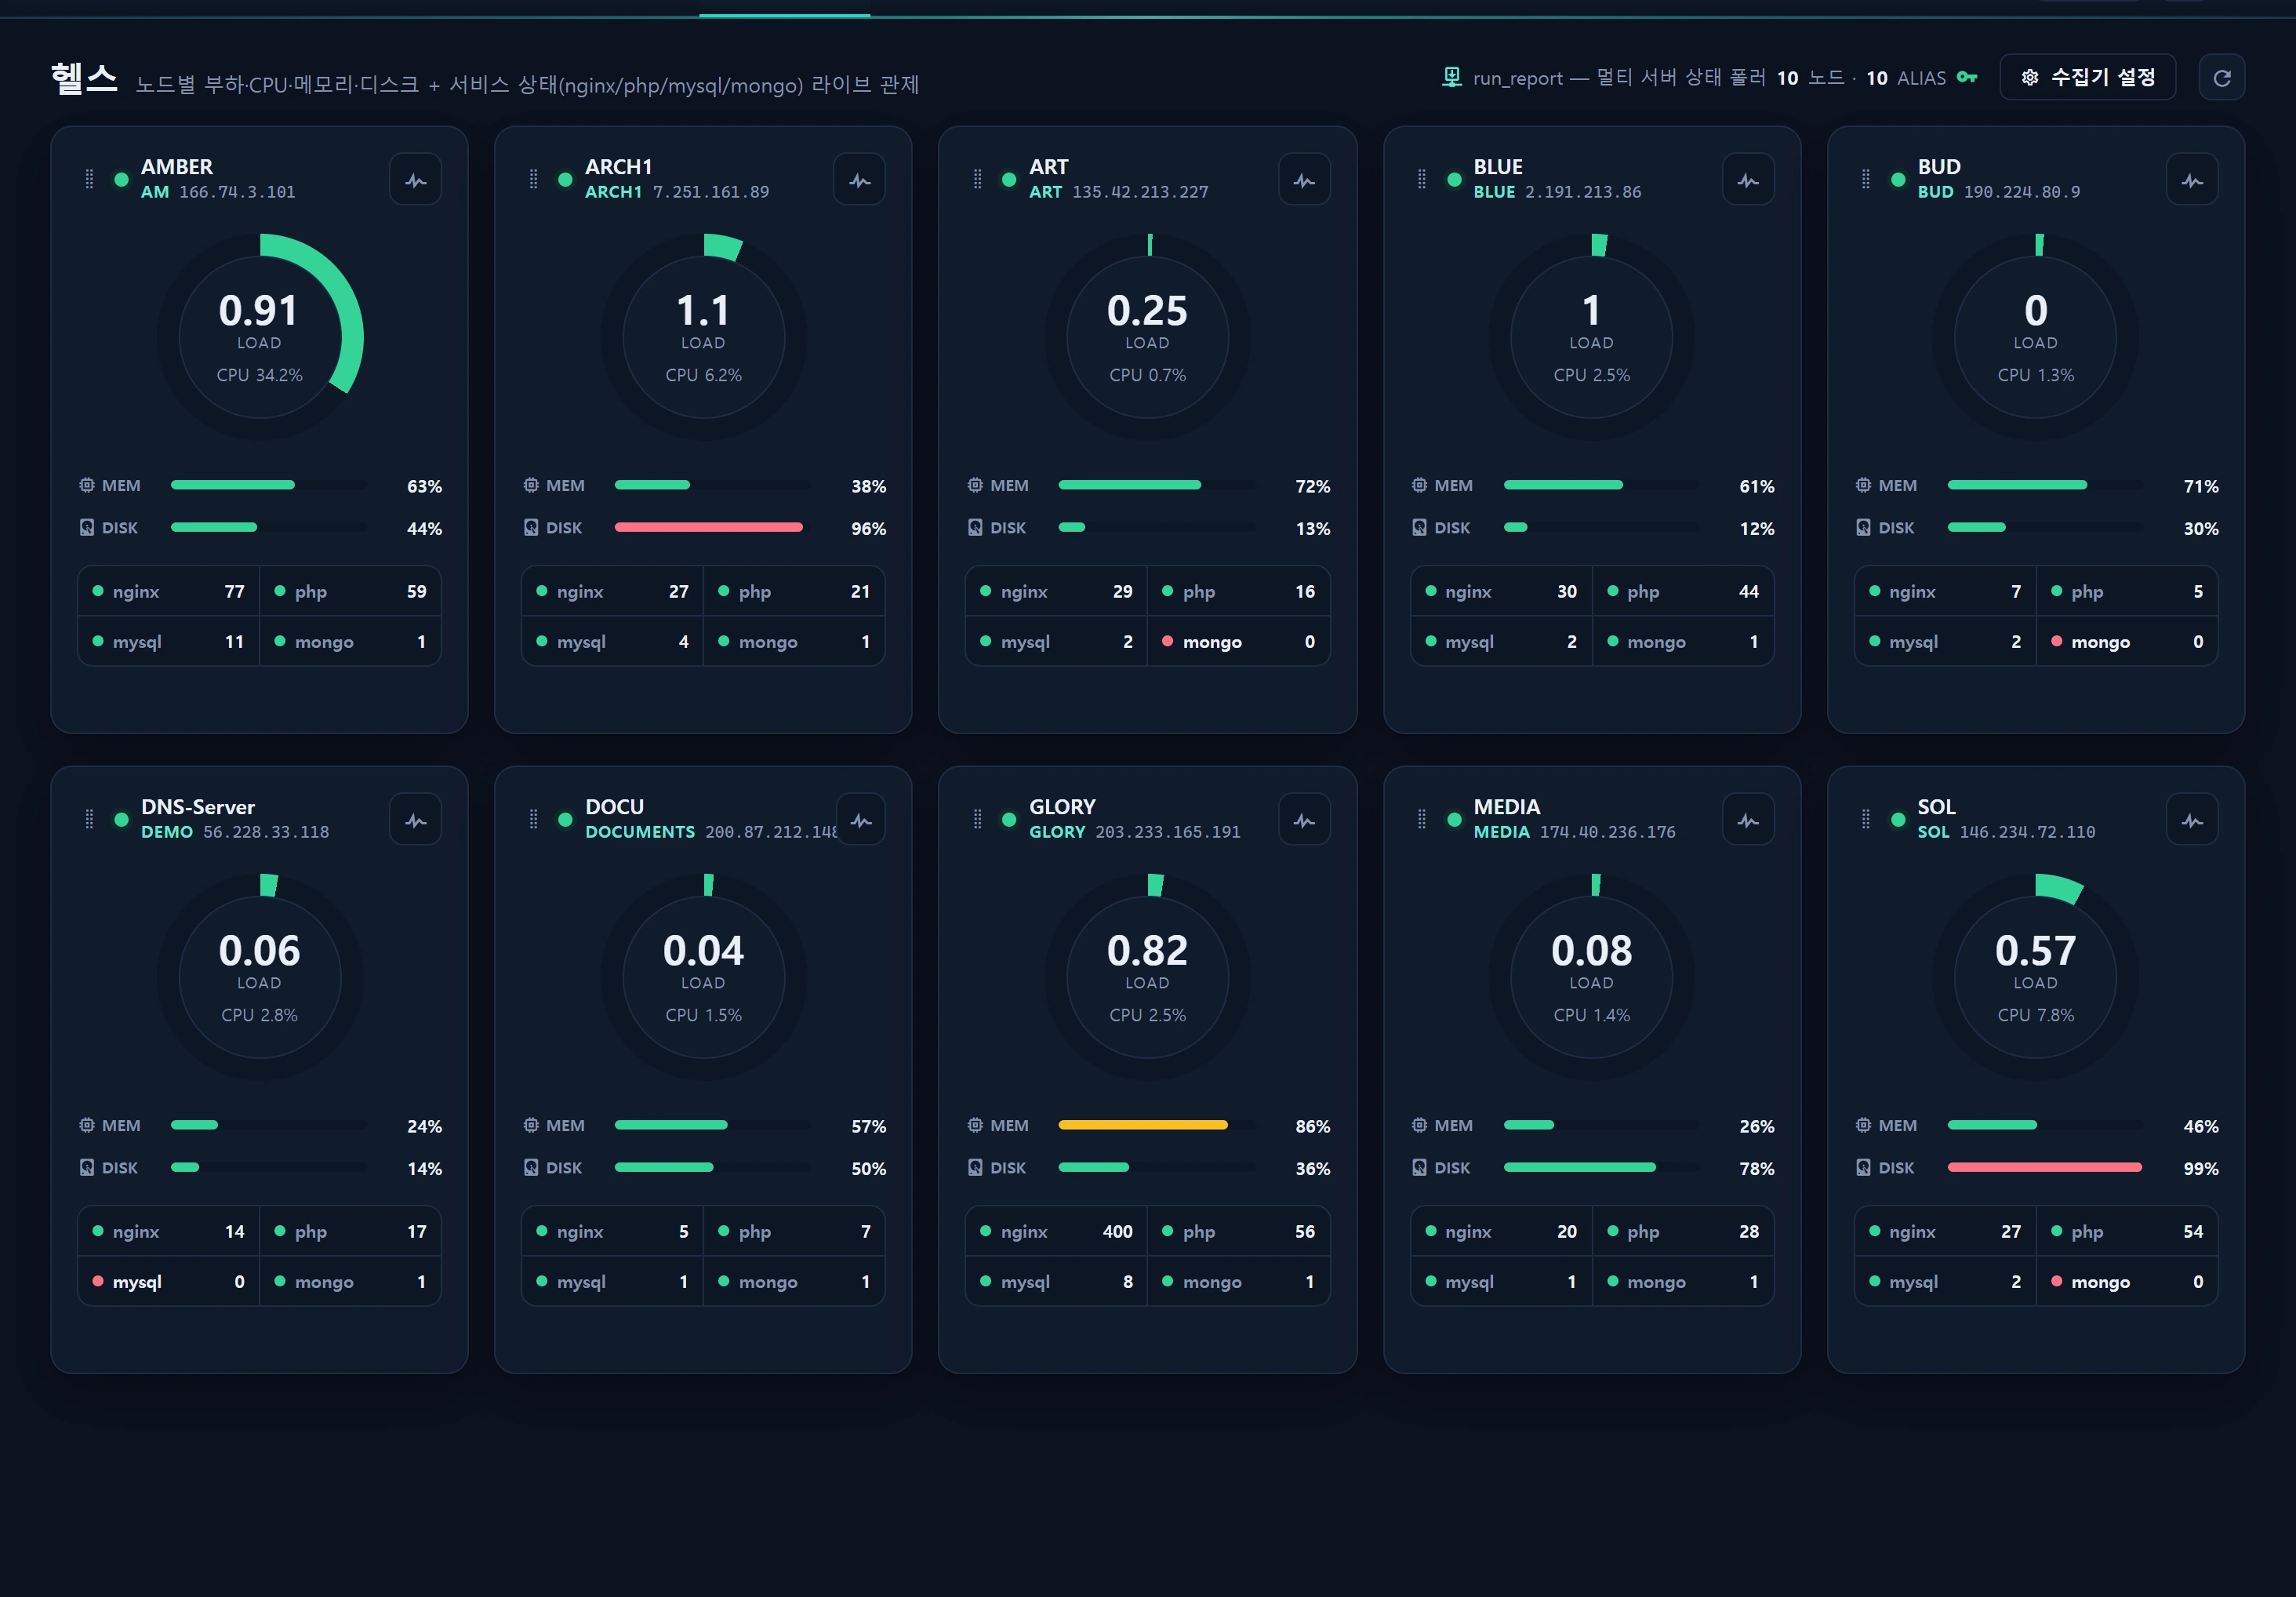
Infraestructura ▸ Estado (/infra/health) es el panel de operaciones de disponibilidad que muestra de un vistazo la salud de cada nodo en ejecución mediante una cuadrícula de tarjetas. Reimplementa la pantalla ./server/stat de stats-design y fusiona dos rutas de datos distintas en una sola tarjeta:
- Instantánea de métricas: los últimos valores de carga / CPU / memoria / disco que el recolector
run_reportescribe enserver_status(una tabla heredada) cada ~5 minutos. La aplicación los lee de una caché de 20 segundos (sin conexión remota directa). - Sondeo de servicios en vivo: una llamada en tiempo real al agente
tlx.phpdesplegado en cada nodo para comprobar, en el acto, si los demoniosnginx / php / mysql / mongoestán activos y para listar los contenedores Docker (TlxClient).
La lista de nodos y los alias (ALIAS_MAP) se cargan automáticamente —sin configuración por servidor— desde la configuración del recolector run_report (infr_collector.config) en Administración ▸ Recolectores.
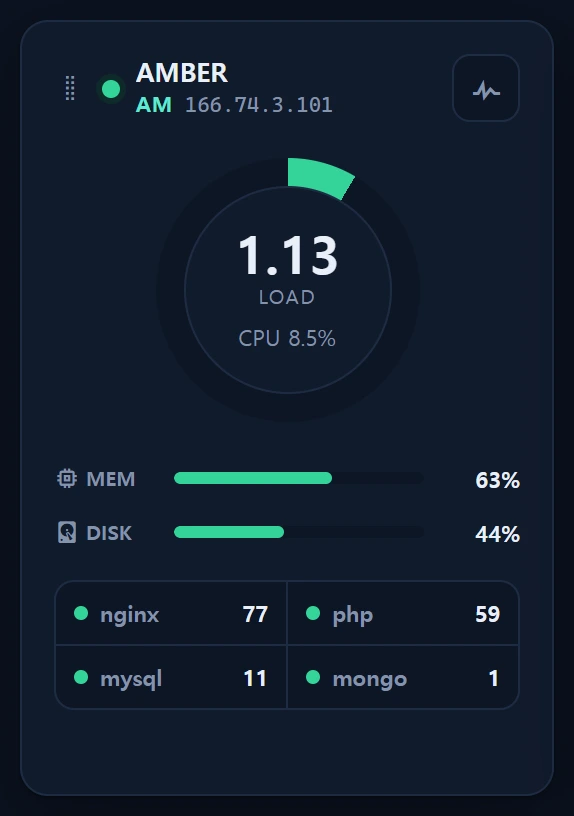
Cada tarjeta muestra información breve del nodo en la cabecera, un indicador circular de CPU (con la carga media en el centro), barras de MEM/DISK debajo y puntos de estado de servicio en la parte inferior.
Esta pantalla es de operación en modo solo lectura. Aquí no se editan los nodos, los alias ni la tlx api_key: todo eso reside en Recolectores.
Cuándo usarlo
- Revisión matinal: compruebe en 30 segundos si todos los nodos están en línea y si la carga, la memoria y el disco se mantienen en la banda saludable.
- Respuesta a incidentes: confirme al instante mediante un sondeo en vivo si
nginxomysqlhan caído en un servidor concreto. - Vigilancia de capacidad: detecte por el color los nodos cuyo uso de disco se acerca a los umbrales (80 % / 92 %).
- Comprobación de hosts Docker: verifique que los contenedores siguen vivos mediante la insignia con el número de contenedores en el pie del resultado del sondeo.
Para el análisis de tendencias (series temporales) vaya a Series temporales de servidores; para la salud de la controladora RAID y el mapa físico de discos vaya a Almacenamiento y RAID.
Disposición
Cabecera (barra superior)
| Elemento | Significado |
|---|---|
| Insignia del recolector | Título del recolector run_report + número de nodos + número de asignaciones ALIAS |
| Icono de llave | Si la tlx api_key está configurada. 🔑 (verde) = configurada · 🔑❗ (gris) = sin configurar, por lo que los sondeos de servicio no están disponibles |
| Botón de configuración del recolector | Lleva a Recolectores (/admin/collectors) |
| Botón de actualización | Vuelve a leer las métricas y relanza los sondeos en vivo en todos los nodos |
Si no existe ningún recolector run_report, en lugar de la cuadrícula de tarjetas se muestra un aviso de «No hay ningún recolector run_report registrado» junto con un botón de configuración.
Tarjeta de nodo
┌──────────────────────────────────────┐
│ ⠿ ●  glory                     ⟳(probe)│  ← cabecera: asa · punto de conexión · etiqueta/alias/IP
│      glory · 203.0.113.10              │
│                                        │
│            ╭───────────╮               │
│            │    0.84    │  ← anillo de CPU (color=CPU%), centro=load
│            │    load    │
│            │  CPU 12%   │
│            ╰───────────╯               │
│  🧠 MEM  ▓▓▓▓▓▓░░░░  63%                 │  ← barra MEM
│  💽 DISK ▓▓▓▓▓▓▓▓░░  81%                 │  ← barra DISK
│  ● nginx ● php ● mysql ● mongo          │  ← puntos de servicio (sondeo en vivo)
│  🐳 4                                   │  ← número de contenedores Docker (si el sondeo tiene éxito)
└──────────────────────────────────────┘
- Punto de conexión (a la izquierda de la cabecera): el nodo está en línea si ha informado
loadavgen los 2 últimos ciclos de recolección. En caso contrario la tarjeta se atenúa (is-offline) y muestra «Fuera de línea (sin informes recientes)». - Indicador circular de CPU: el relleno y el color del anillo representan el CPU us %, el número grande del centro es la carga media (1 minuto) y el texto pequeño inferior es el porcentaje de CPU.
- Barras MEM / DISK: uso (%), coloreado según el umbral.
- Puntos de servicio: cuatro,
nginx / php / mysql / mongo. El color sigue el resultado del sondeo (véase la tabla). - Insignia de Docker: muestra el número de contenedores cuando el sondeo tiene éxito y hay contenedores, o «Sondeo fallido (inaccesible)» cuando falla.
Umbrales (reglas de color)
| Métrica | good (verde) | warn (ámbar) | crit (rojo) |
|---|---|---|---|
| CPU us % (anillo) | < 60 | ≥ 60 | ≥ 85 |
| MEM % (barra) | < 80 | ≥ 80 | ≥ 92 |
| DISK % (barra) | < 80 | ≥ 80 | ≥ 92 |
Los valores ausentes (—) se representan en gris (na).
Tonos de los puntos de servicio
| Tono | Condición |
|---|---|
up (verde) |
Sondeo correcto + el número de procesos de ese demonio es > 0 |
down (rojo) |
El sondeo funcionó pero el número de procesos es 0, o el sondeo falló |
unknown (gris) |
Todavía no se ha sondeado, o la respuesta no incluye esa clave de servicio |
Cómo usarlo
1. Actualizar las métricas (automático + manual)
- Las métricas de las tarjetas se consultan automáticamente cada 30 segundos (
GET /infra/health/refresh). Con la caché de 20 segundos del lado del servidor, el coste es bajo. - El botón de actualización superior (⟳) vuelve a leer las métricas y relanza los sondeos en vivo de todos los nodos en una secuencia escalonada.
2. Sondear un solo nodo en vivo
El botón de pulso (⟐) situado a la derecha de la cabecera de una tarjeta sondea de inmediato únicamente ese nodo (POST /infra/health/probe, con {alias} en el cuerpo). En la primera carga de la página, si la tlx api_key está configurada, todas las tarjetas se sondean automáticamente con una cadencia escalonada de 250 ms (para evitar una ráfaga).
Cuando el sondeo tiene éxito, la tarjeta refleja no solo los puntos de servicio, sino también los valores instantáneos de carga / CPU / MEM / DISK que vienen en la respuesta.
Si todos los puntos de servicio están en gris (
unknown), lo habitual es que latlx api_keyno esté configurada. Revise el icono de llave en la cabecera: si aparece 🔑❗, el sondeo no llega a ejecutarse.
3. Reordenar las tarjetas (arrastrar)
Sujete el asa (⠿) a la izquierda de la cabecera de una tarjeta y arrastre para reordenar. El orden se guarda en el localStorage del navegador (infr:order:infra-health) y se conserva entre visitas. Las tarjetas usan una disposición masonry de altura variable y se pagina de 10 en 10.
Fuentes de datos
Métricas: server_status (heredada, solo lectura)
HealthService::metricsByAlias() lee de la conexión legacy. Para evitar consultas lentas se limita a una ventana reciente de seq en lugar de agregar toda la tabla.
-- 1) solo los 3 seq más recientes (distinct = recorrido de índice)
SELECT DISTINCT seq FROM server_status ORDER BY seq DESC LIMIT 3;

-- 2) solo los part de interés para esos seq
SELECT server_alias, part, value, seq, created_at
  FROM server_status
 WHERE seq IN (:s1, :s2, :s3)
   AND part IN ('loadavg','free','top','df-','df-data','df-home')
 ORDER BY seq;   -- ascendente → las filas posteriores son más recientes
Convención de almacenamiento del recolector run_report:
| part | Significado | Formato | Correspondencia en la tarjeta |
|---|---|---|---|
loadavg |
Carga (1 minuto) | número | load (centro del indicador) |
top |
CPU us % | "NN%" |
relleno del anillo de CPU |
free |
Memoria % | "NN%" |
barra MEM |
df-data / df- / df-home |
Disco | JSON {p,u,a} |
barra DISK (p=%, u=usado, a=tamaño) |
- Decisión de conexión: está en línea si
loadavgaparece dentro de los 2 seq más recientes. - Prioridad de disco: el primero válido de
df-data→df-→df-home. - Clave de caché
infr:health:metrics:v1, TTL de 20 s. Cualquier excepción durante la consulta degrada de forma controlada a un array vacío.
Resolución de nodos: infr_collector.config
HealthService::resolveNodes() deriva los nodos del recolector run_report (InfrCollector::where('key','run_report')).
| Prioridad | Origen (node_source) |
Descripción |
|---|---|---|
| 1 | config |
Usa config.nodes[] tal cual si existe (cada nodo = url·alias·label·ip) |
| 2 | instance |
Si está vacío, se deriva en tiempo de ejecución del registro de Instancias (infr_instance, caché de 60 s) |
| — | none |
Si ambos están vacíos, no hay nodos |
El número de entradas de config.alias_map se muestra como la insignia «ALIAS» de la cabecera.
Estado de los servicios: sondeo en vivo de tlx.php (TlxClient)
HealthController::probe() localiza el nodo por su alias (lo que impide hacer de proxy hacia un host arbitrario) y llama al tlx.php de ese nodo mediante TlxClient::probe().
- Modo:
check_all(predeterminado) ocheck_multi, según decidaconfig.mode(antestlx_mode). - Ruta:
config.path(antestlx_path), por omisión/tlx.php. - Tiempo de espera: hasta 4 s para conectar / 6 s en total. Los casos de host inaccesible, tiempo agotado y fallo al analizar el JSON degradan de forma controlada a
{ok:false, reason:...}.
Forma normalizada de la respuesta check_all de tlx.php para la tarjeta:
{
  "ok": true,
  "load": 0.84,
  "cpu_us": 12.0,
  "mem_pct": 63,
  "disks": [ { "mount": "/data", "pct": 81, "used": "1.6T", "size": "2.0T" } ],
  "services": { "nginx": {"count":4,"up":true}, "php": {"count":8,"up":true}, "mysql": {"count":1,"up":true}, "mongo": {"count":0,"up":false} },
  "docker": [ "web", "redis", "worker", "cron" ]
}
La
tlx api_keyse descifra desdeinfr_collector(conCryptde Laravel) y se usa solo en el servidor. Nunca se devuelve al navegador ni se escribe de forma fija en el código. Lo único que sale hacia el nodo remoto es el valorqfirmado.
Resumen de endpoints
| Método · ruta | Nombre | Propósito |
|---|---|---|
GET /infra/health |
infra.health |
Página (con datos de arranque) |
GET /infra/health/refresh |
infra.health.refresh |
Sondeo periódico de la instantánea de métricas (JSON) |
POST /infra/health/probe |
infra.health.probe |
Sondeo en vivo de un solo nodo ({alias}) |
Acceso
- Lectura (ver · sondear): esta pantalla se encuentra bajo el grupo
infr.authy es accesible para cualquier usuario de consola autenticado (nivel ≥ 1 / demo). El nivel mínimo del área de rol Infraestructura es 1. - Sin escrituras: la propia pantalla de Estado no tiene acciones destructivas. Los cambios en nodos, alias o la
tlx api_keyse hacen en Recolectores y están restringidos a administradores (nivel ≥ 5, admin=10). - El sondeo solo apunta a alias de nodos registrados, por lo que no puede usarse para hacer de proxy hacia hosts arbitrarios (a salvo de SSRF).
Resolución de problemas y preguntas frecuentes
No aparece ninguna tarjeta y dice «No hay ningún recolector run_report registrado»
No existe ningún recolector con la clave run_report. Registre uno en Recolectores con access=web y key=run_report.
Dice «No hay nodos registrados»
El recolector run_report existe, pero config.nodes está vacío y el registro infr_instance también. Rellene el array de nodos del recolector o registre servidores en Instancias (los nodos se derivan automáticamente de las instancias cuando config.nodes está vacío).
Las métricas solo muestran — (guiones)
No hay ninguna instantánea reciente en server_status. Confirme que el recolector run_report se está ejecutando realmente en cron y que los alias de los nodos coinciden con server_status.server_alias. La conexión se determina a partir de los 2 seq más recientes.
Todos los puntos de servicio están en gris
- Si el icono de llave de la cabecera es 🔑❗ (sin configurar), configure la
tlx api_keyen Recolectores: los sondeos no se ejecutan mientras no esté definida. - Pulse el botón de sondeo (⟐) de una tarjeta para ver la respuesta. «Sondeo fallido (inaccesible)» significa que debe revisar la
urldel nodo, el cortafuegos y el despliegue detlx.php.
Solo falla el sondeo, pero la carga y la memoria se ven bien
Las métricas (server_status) y el sondeo (tlx.php) son rutas independientes. La ingesta del recolector en la base de datos funciona, pero el endpoint HTTP tlx.php del nodo está bloqueado (cortafuegos o ruta). Revise config.path (por omisión /tlx.php) y la url del nodo.
El porcentaje de disco no es el que espero
El disco mostrado se elige con la prioridad df-data → df- → df-home. Con varios volúmenes, el volumen de datos (df-data) tiene preferencia.
Relacionado
- Series temporales de servidores: tendencias de carga / CPU / memoria (ECharts) y tablas de estadísticas
- Almacenamiento y RAID: salud de la controladora RAID · mapa físico de discos
- Recolectores: configurar los nodos de
run_report· ALIAS ·tlx api_key - Instancias: el origen de la derivación automática de nodos (
infr_instance) - Alertas: SMS/correo ante infracciones de umbral de carga o disco
- Resumen: puntuación de salud combinada de disponibilidad y seguridad