概述 — 这个页面做什么
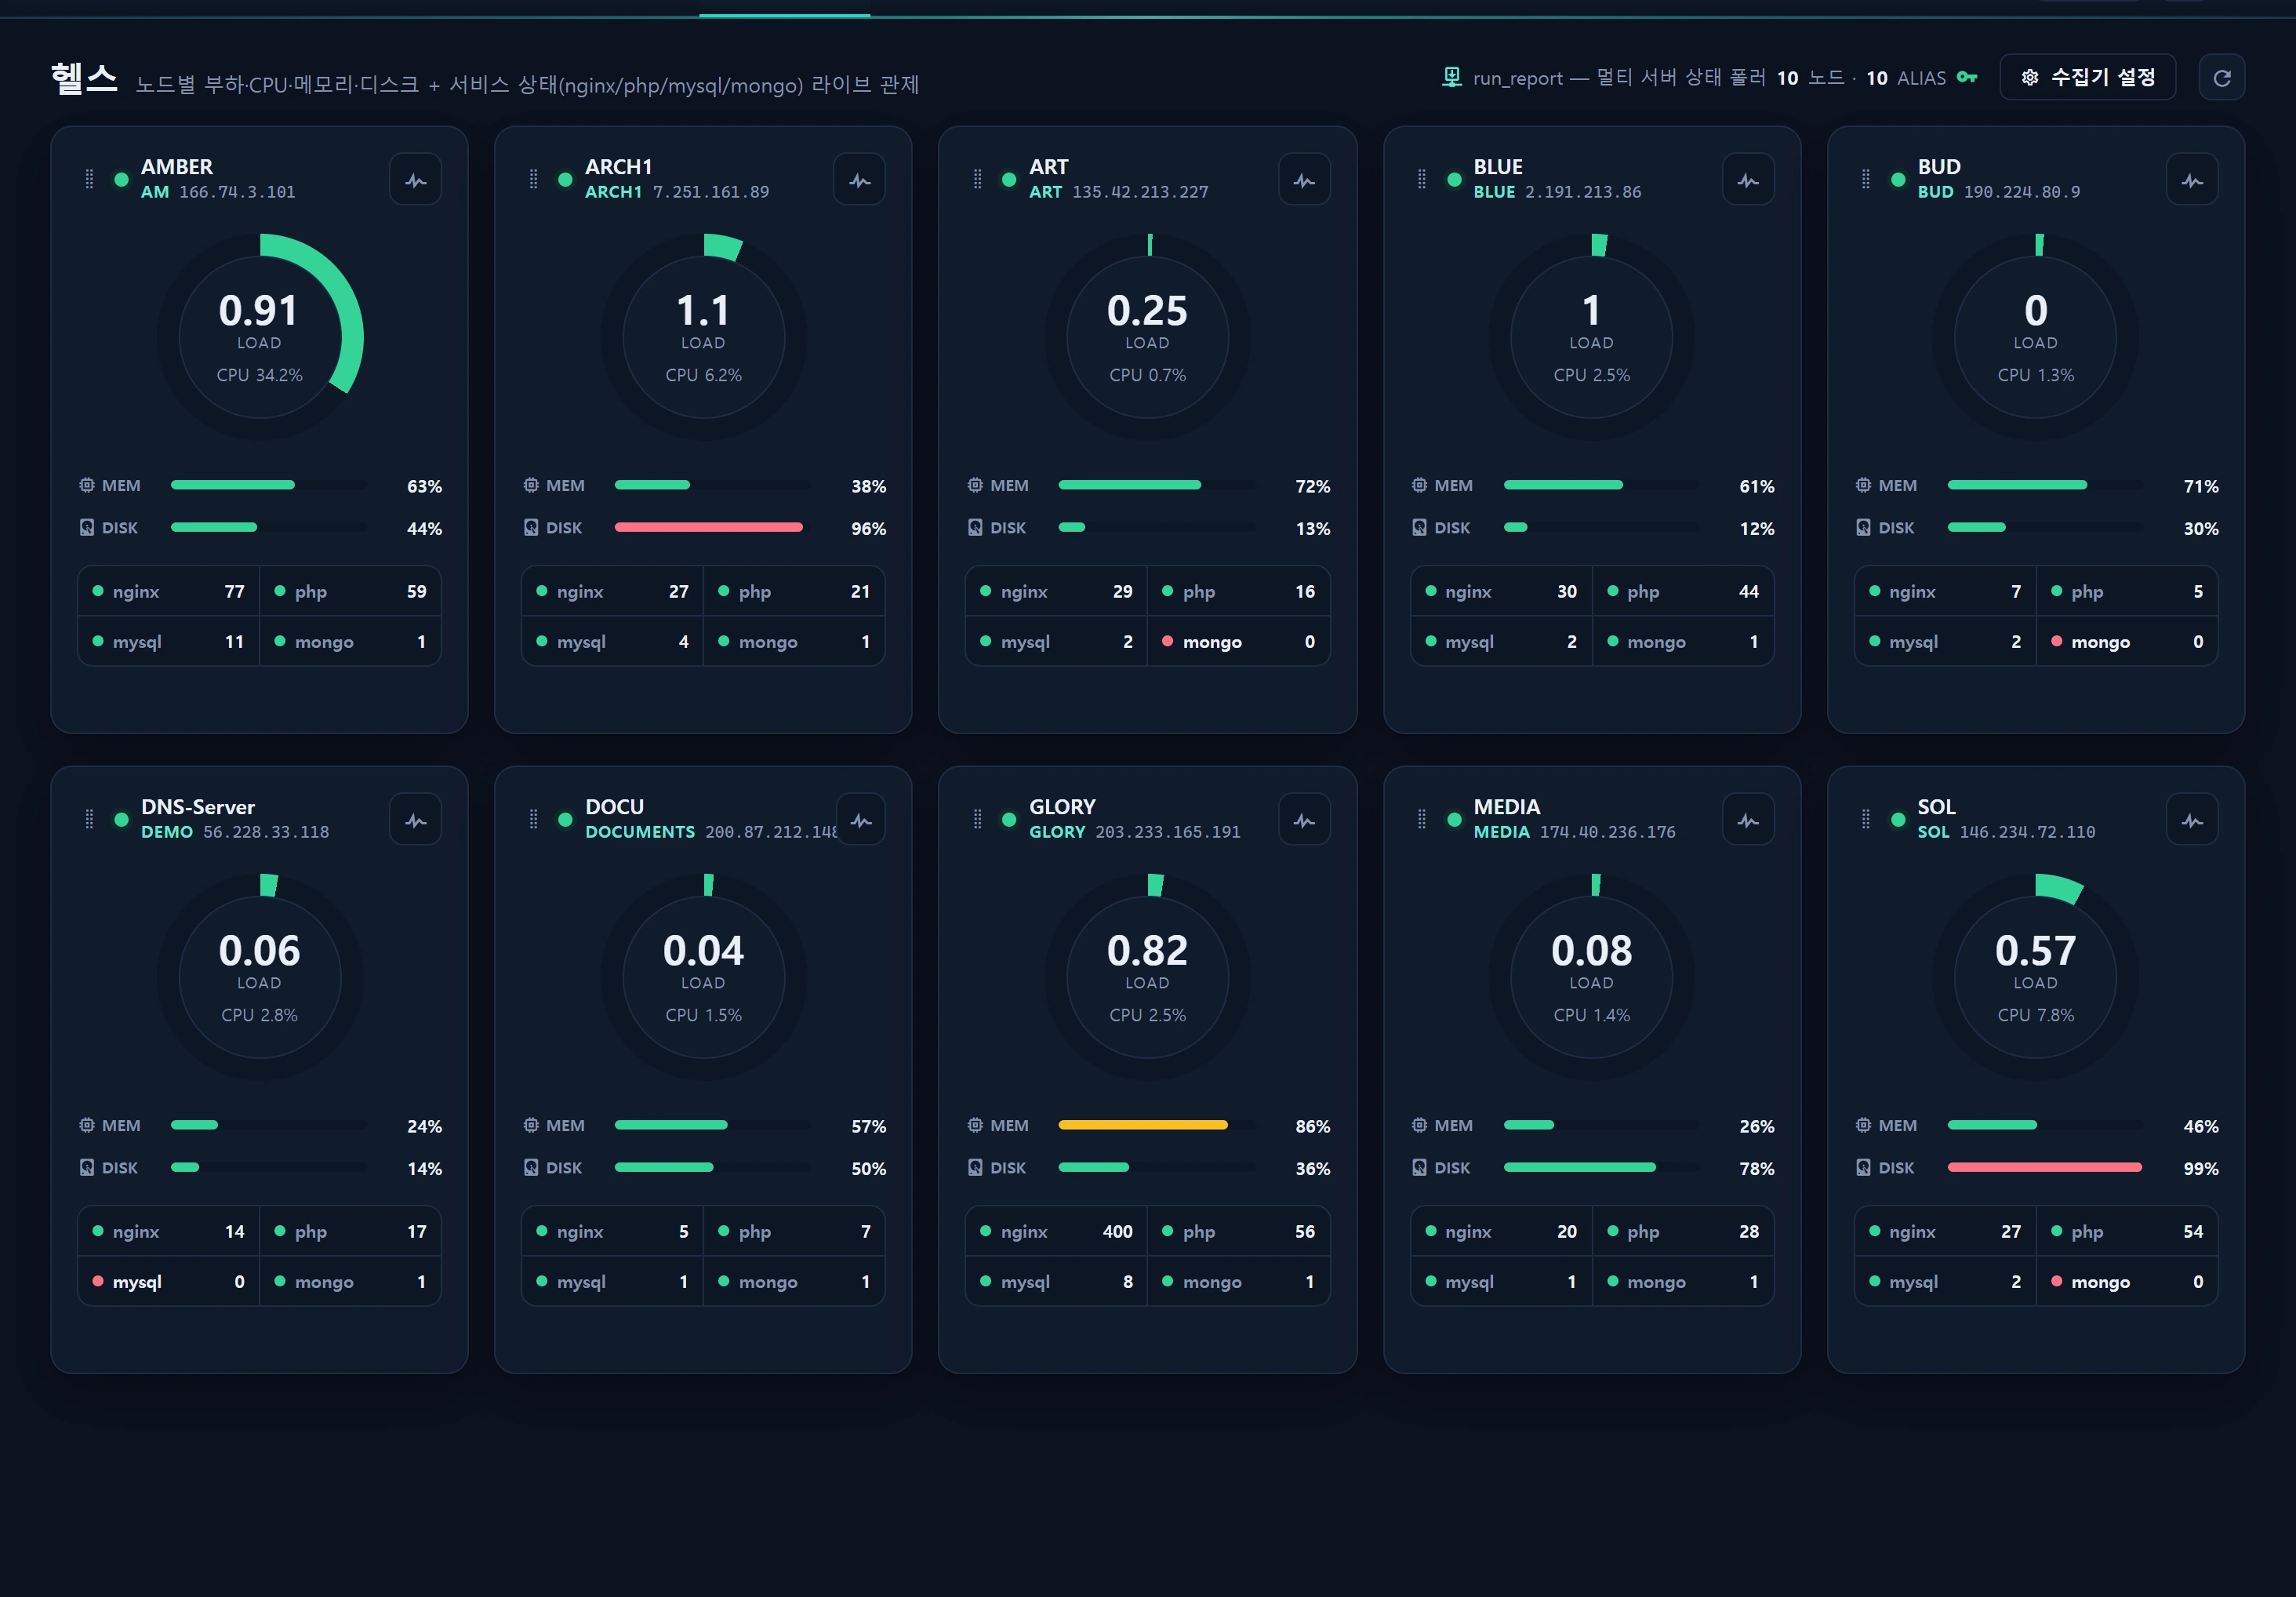
基础设施 ▸ 健康状态(/infra/health)是可用性运维仪表板,以卡片网格一目了然地展示每个运行中节点的健康状况。它重新实现了 stats-design 的 ./server/stat 页面,并把两条不同的数据链路融合到同一张卡片中:
- 指标快照 —
run_report采集器每约 5 分钟写入server_status(遗留表)的最新负载/CPU/内存/磁盘数值。应用从 20 秒缓存中读取(不建立到远端的直接连接)。 - 实时服务探测 — 实时调用部署在各节点上的
tlx.php代理,当场检查nginx / php / mysql / mongo守护进程是否在运行,并列出 Docker 容器(TlxClient)。
节点列表与别名(ALIAS_MAP)会从 管理 ▸ 采集器 中 run_report 采集器的配置(infr_collector.config)自动载入 — 无需逐台服务器配置。
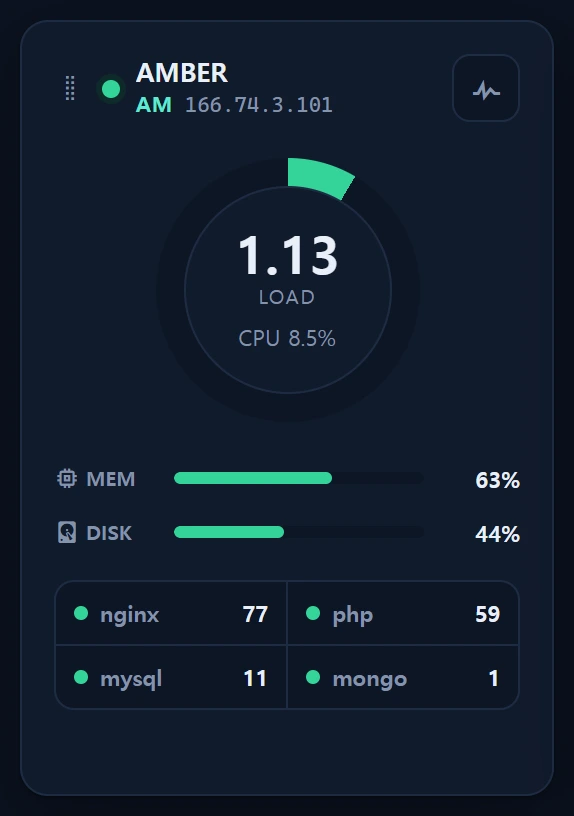
每张卡片在页眉显示简要的节点信息,中间是 CPU 环形仪表(中心为平均负载),其下为 MEM/DISK 条,底部是服务状态圆点。
本页面为只读运维视图。这里不编辑节点、别名或 tlx api_key —— 它们都位于 采集器。
何时使用
- 早间巡检 — 30 秒内扫视所有节点是否在线,以及负载/内存/磁盘是否处于健康区间。
- 事件响应 — 通过实时探测立即确认某台服务器上的
nginx或mysql是否已经停止。 - 容量监视 — 凭颜色发现磁盘使用率逼近阈值(80% / 92%)的节点。
- Docker 主机检查 — 通过探测结果页脚的 Docker 容器数徽标确认容器存活。
若需趋势(时间序列)分析,请前往 服务器时间序列;若需 RAID 控制器健康状况与物理磁盘图,请前往 存储与 RAID。
布局
主视区(顶部栏)
| 元素 | 含义 |
|---|---|
| 采集器徽标 | run_report 采集器标题 + 节点数 + ALIAS 映射数 |
| 钥匙图标 | 是否已设置 tlx api_key。🔑(绿色)=已设置 · 🔑❗(灰色)=未设置,因此无法进行服务探测 |
| 采集器配置按钮 | 跳转到 采集器(/admin/collectors) |
| 刷新按钮 | 重新读取指标并对所有节点重新执行实时探测 |
如果不存在 run_report 采集器,页面将以“尚未注册 run_report 采集器”的提示和一个配置按钮取代卡片网格。
节点卡片
┌──────────────────────────────────────┐
│ ⠿ ●  glory                     ⟳(probe)│  ← 页眉: 拖拽柄 · 在线圆点 · 标签/别名/IP
│      glory · 203.0.113.10              │
│                                        │
│            ╭───────────╮               │
│            │    0.84    │  ← CPU 环 (颜色=CPU%),中心=load
│            │    load    │
│            │  CPU 12%   │
│            ╰───────────╯               │
│  🧠 MEM  ▓▓▓▓▓▓░░░░  63%                 │  ← MEM 条
│  💽 DISK ▓▓▓▓▓▓▓▓░░  81%                 │  ← DISK 条
│  ● nginx ● php ● mysql ● mongo          │  ← 服务圆点 (实时探测)
│  🐳 4                                   │  ← Docker 容器数 (探测成功时)
└──────────────────────────────────────┘
- 在线圆点(页眉左侧)— 若节点在最近 2 个采集周期内上报过
loadavg,即视为在线。否则卡片变暗(is-offline)并显示“离线(近期无上报)”。 - CPU 环形仪表 — 环的填充与颜色表示 CPU us%,中心的大数字是平均负载(1 分钟),下方的小字是 CPU %。
- MEM / DISK 条 — 使用率(%),按阈值着色。
- 服务圆点 — 共四个:
nginx / php / mysql / mongo。颜色取决于探测结果(见下表)。 - Docker 徽标 — 探测成功且存在容器时显示容器数量,探测失败时显示“探测失败(无法访问)”。
阈值(着色规则)
| 指标 | good(绿色) | warn(琥珀色) | crit(红色) |
|---|---|---|---|
| CPU us%(环) | < 60 | ≥ 60 | ≥ 85 |
| MEM %(条) | < 80 | ≥ 80 | ≥ 92 |
| DISK %(条) | < 80 | ≥ 80 | ≥ 92 |
缺失的数值(—)渲染为灰色(na)。
服务圆点色调
| 色调 | 条件 |
|---|---|
up(绿色) |
探测成功 + 该守护进程的进程数 > 0 |
down(红色) |
探测成功但进程数为 0,或探测失败 |
unknown(灰色) |
尚未探测,或响应中缺少该服务键 |
使用方法
1. 刷新指标(自动 + 手动)
- 卡片指标每 30 秒自动轮询一次(
GET /infra/health/refresh)。配合服务端的 20 秒缓存,开销很低。 - 顶部的刷新按钮(⟳)会重新读取指标,并以错峰顺序对所有节点重新执行实时探测。
2. 对单个节点进行实时探测
卡片页眉右侧的脉冲(⟐)按钮只立即探测该节点(POST /infra/health/probe,请求体为 {alias})。页面首次加载时,如果已设置 tlx api_key,所有卡片都会以 250 ms 错峰节奏自动探测(以避免瞬时并发)。
探测成功后,卡片不仅会反映服务圆点,还会反映响应中携带的当场负载/CPU/MEM/DISK 数值。
如果所有服务圆点都是灰色(
unknown),通常是tlx api_key未设置。请查看主视区的钥匙图标 —— 若显示 🔑❗,则探测根本不会执行。
3. 重新排列卡片(拖拽)
按住卡片页眉左侧的拖拽柄(⠿)拖动即可重新排序。顺序保存在浏览器 localStorage(infr:order:infra-health)中,跨次访问依然保留。卡片采用高度可变的瀑布流布局,每页显示 10 张。
数据来源
指标 — server_status(遗留,只读)
HealthService::metricsByAlias() 从 legacy 连接读取。为了避免慢查询,它只收窄到最近的 seq 窗口,而不是聚合整张表。
-- 1) 仅取最近的 3 个 seq(distinct = 索引扫描)
SELECT DISTINCT seq FROM server_status ORDER BY seq DESC LIMIT 3;

-- 2) 仅取这些 seq 中关注的 part
SELECT server_alias, part, value, seq, created_at
  FROM server_status
 WHERE seq IN (:s1, :s2, :s3)
   AND part IN ('loadavg','free','top','df-','df-data','df-home')
 ORDER BY seq;   -- 升序 → 靠后的行更新
run_report 采集器的存储约定:
| part | 含义 | 格式 | 卡片映射 |
|---|---|---|---|
loadavg |
负载(1 分钟) | 数字 | load(仪表中心) |
top |
CPU us% | "NN%" |
CPU 环填充 |
free |
内存 % | "NN%" |
MEM 条 |
df-data / df- / df-home |
磁盘 | JSON {p,u,a} |
DISK 条(p=%、u=已用、a=容量) |
- 在线判定 — 若
loadavg出现在最近 2 个 seq 中即为在线。 - 磁盘优先级 — 依次取
df-data→df-→df-home中第一个有效值。 - 缓存键为
infr:health:metrics:v1,TTL 为 20 秒。查询期间的任何异常都会优雅降级为空数组。
节点解析 — infr_collector.config
HealthService::resolveNodes() 从 run_report 采集器(InfrCollector::where('key','run_report'))推导节点。
| 优先级 | 来源(node_source) |
说明 |
|---|---|---|
| 1 | config |
若存在 config.nodes[] 则原样使用(每个节点 = url·alias·label·ip) |
| 2 | instance |
若为空,则在运行时从 实例 台账(infr_instance,60 秒缓存)推导 |
| — | none |
若两者皆空,则没有节点 |
config.alias_map 的条目数会作为主视区的“ALIAS”徽标显示。
服务状态 — tlx.php 实时探测(TlxClient)
HealthController::probe() 按别名查找节点(防止代理到任意主机),并通过 TlxClient::probe() 调用该节点的 tlx.php。
- 模式 —
check_all(默认)或check_multi,由config.mode(旧称tlx_mode)决定。 - 路径 —
config.path(旧称tlx_path),默认为/tlx.php。 - 超时 — 连接最多 4 秒/总计 6 秒。无法访问、超时以及 JSON 解析失败都会优雅降级为
{ok:false, reason:...}。
面向卡片归一化后的 tlx.php check_all 响应结构:
{
  "ok": true,
  "load": 0.84,
  "cpu_us": 12.0,
  "mem_pct": 63,
  "disks": [ { "mount": "/data", "pct": 81, "used": "1.6T", "size": "2.0T" } ],
  "services": { "nginx": {"count":4,"up":true}, "php": {"count":8,"up":true}, "mysql": {"count":1,"up":true}, "mongo": {"count":0,"up":false} },
  "docker": [ "web", "redis", "worker", "cron" ]
}
tlx api_key由infr_collector解密而来(LaravelCrypt),且仅在服务端使用。它绝不会返回给浏览器,也绝不硬编码。发往远端节点的只有经过签名的q值。
端点一览
| 方法 · 路径 | 名称 | 用途 |
|---|---|---|
GET /infra/health |
infra.health |
页面(含引导数据) |
GET /infra/health/refresh |
infra.health.refresh |
指标快照轮询(JSON) |
POST /infra/health/probe |
infra.health.probe |
单节点实时探测({alias}) |
访问权限
- 读取(查看 · 探测) — 本页面位于
infr.auth组下,任何已认证的控制台用户均可访问(级别 ≥ 1 / 演示)。基础设施角色域的最低级别为 1。 - 无写操作 — 健康状态页面本身没有破坏性操作。修改节点、别名或
tlx api_key在 采集器 中进行,并限定于管理员(级别 ≥ 5,admin=10)。 - 探测只针对已注册的节点别名,因此无法被用来代理到任意主机(可防 SSRF)。
故障排查与常见问题
完全没有卡片,并提示“尚未注册 run_report 采集器”
不存在键为 run_report 的采集器。请在 采集器 中以 access=web 和 key=run_report 注册一个。
提示“尚未注册节点”
run_report 采集器存在,但 config.nodes 为空,且 infr_instance 台账同样为空。请填写采集器的节点数组,或在 实例 中注册服务器(当 config.nodes 为空时会自动从实例推导节点)。
指标只显示 —(短横线)
server_status 中没有近期快照。请确认 run_report 采集器确实在 cron 中运行,且节点别名与 server_status.server_alias 一致。在线状态是依据最近 2 个 seq 判定的。
所有服务圆点都是灰色
- 若主视区的钥匙图标为 🔑❗(未设置),请在 采集器 中设置
tlx api_key—— 未设置时不会执行探测。 - 按下卡片的探测按钮(⟐)查看响应。若显示“探测失败(无法访问)”,则应检查节点
url、防火墙以及tlx.php的部署情况。
只有探测失败,但负载和内存看起来正常
指标(server_status)与探测(tlx.php)是互相独立的链路。采集器的数据库入库正常,但节点的 tlx.php HTTP 端点被阻断(防火墙/路径)。请检查 config.path(默认 /tlx.php)与节点 url。
磁盘百分比与预期不符
显示的磁盘按 df-data → df- → df-home 的优先级选取。存在多个卷时,数据卷(df-data)优先。
相关内容
- 服务器时间序列 — 负载/CPU/内存趋势(ECharts)与统计表
- 存储与 RAID — RAID 控制器健康状况 · 物理磁盘图
- 采集器 — 配置
run_report的节点 · ALIAS ·tlx api_key - 实例 — 节点自动推导的来源(
infr_instance) - 告警 — 负载/磁盘阈值越限时发送短信/邮件
- 概览 — 可用性与安全性的综合健康评分