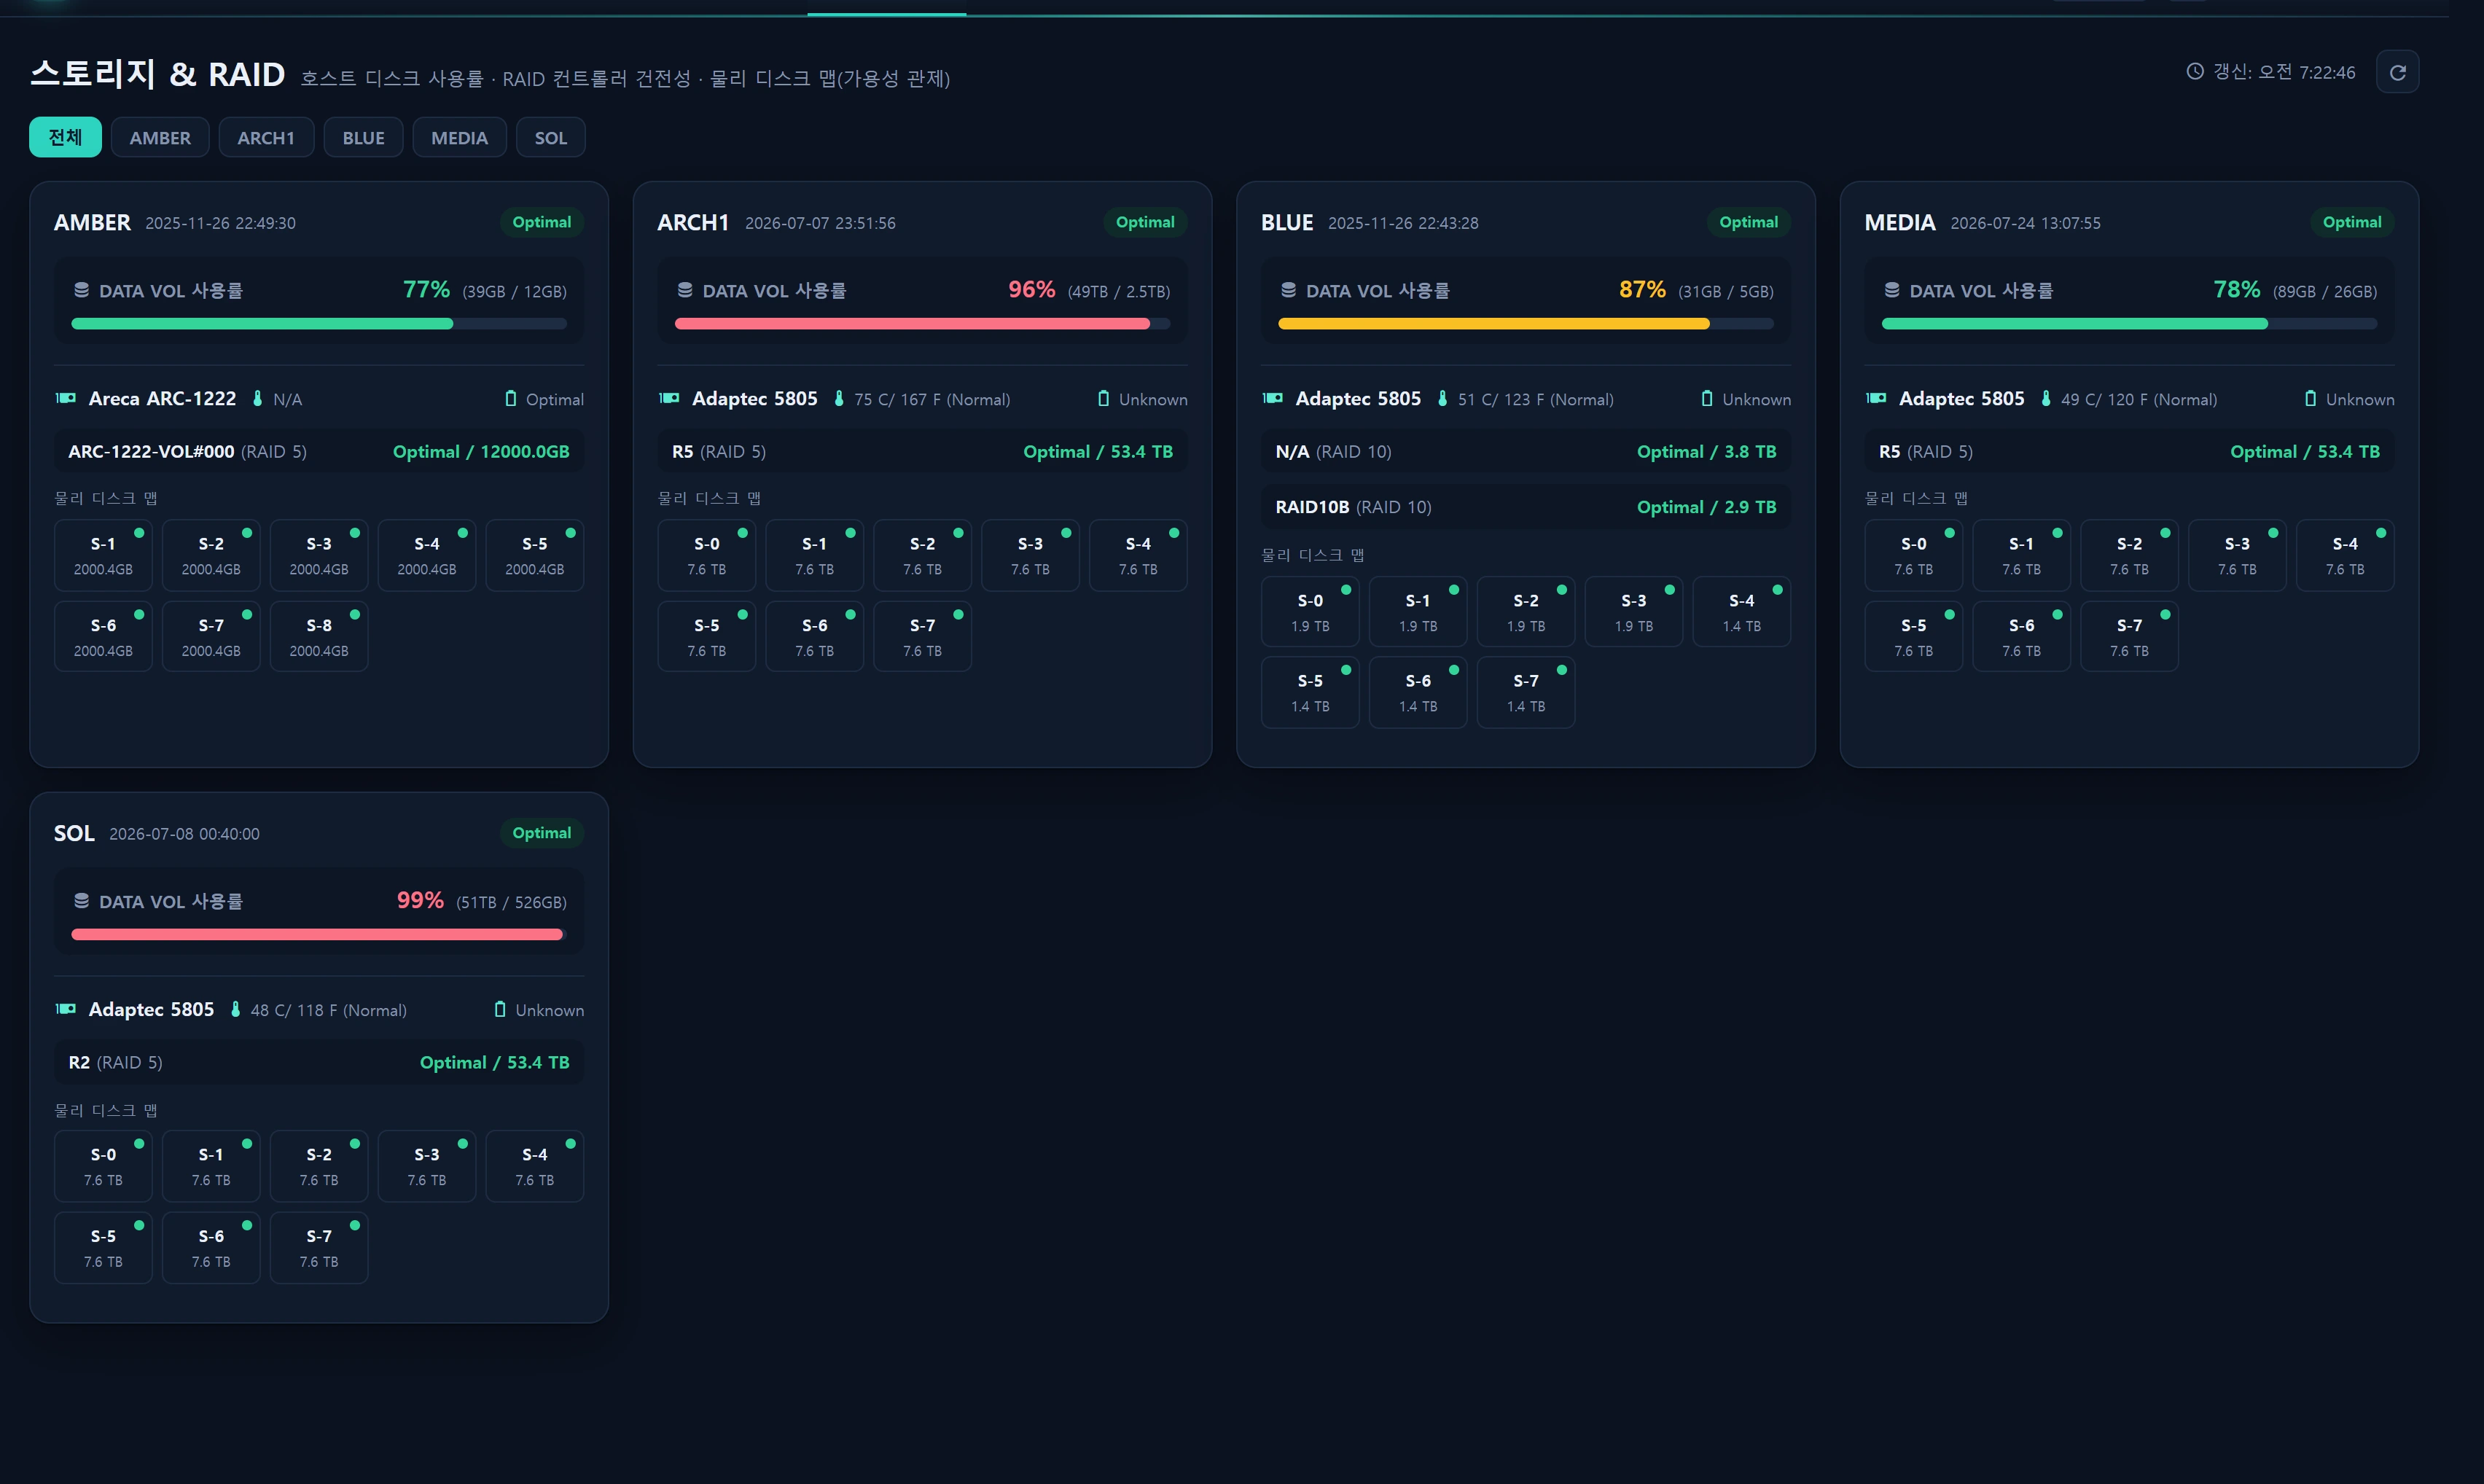
Vue d’ensemble — ce que fait cet écran
Infrastructure ▸ Stockage et RAID (/infra/storage) est un tableau de bord de disponibilité en lecture seule qui rassemble sur un seul écran la santé du stockage de chaque hôte. Il assemble deux types de télémétrie en cartes.
- Santé du contrôleur RAID — issue de la table héritée
storage_status.json_data(la sortie de la collectearcconfd’Adaptec) : état du contrôleur (Optimal/Degraded/Failed), température, état de la batterie, volumes logiques (niveau RAID · état · taille) et une carte des disques physiques (état par emplacement · modèle · numéro de série · taille). - Utilisation du volume de données — issue de l’instantané
df-*de la table héritéeserver_status: pourcentage d’utilisation · utilisé · disponible du volume de données, affichés en haut de la carte.
Son objectif central est l’alerte précoce de défaillance disque. Lorsqu’une grappe RAID retombe en Degraded ou qu’un disque physique passe en Failed/Missing, la couleur (ambre/rouge) le rend immédiatement visible, ce qui vous permet de remplacer et de reconstruire avant qu’un second disque ne lâche et que toute la grappe ne s’effondre.
Cet écran ne couvre que l’état en direct (la santé à l’instant présent). Le registre des actifs de stockage (métadonnées des équipements, planification de capacité, arborescence des zones de fichiers) appartient à Actifs ▸ Stockage et fichiers. Les deux sont volontairement séparés (voir Sources de données).
Quand l’utiliser
- Lors des rondes de routine, pour voir l’état RAID de chaque nœud d’un coup d’œil.
- Lorsqu’un serveur est lent ou que vous recevez des avertissements d’E/S, pour trier rapidement l’espace disque libre et l’état de la grappe.
- Avant et après un remplacement de disque, pour confirmer visuellement la progression ou l’achèvement de la reconstruction via la carte des emplacements.
- Lorsqu’une alerte d’espace disque libre se déclenche dans Infrastructure ▸ Alertes et que vous devez déterminer quel volume est concerné.
Disposition
Bandeau · barre de commande
- Titre/sous-titre + horodatage de dernière actualisation (
Updated: HH:MM:SS) + bouton d’actualisation (interrogation manuelle). - Barre de filtre par hôte —
Allplus un bouton par hôte. Sélectionner un hôte filtre sur celui-ci et revient à la page 1.
Carte de stockage
Une carte est produite par hôte.
| Zone | Contenu |
|---|---|
| En-tête | Nom de l’hôte · heure de dernière mise à jour · badge de synthèse RAID (status_summary) |
| Utilisation | Libellé DATA VOL usage + pourcentage + (used / available) + barre de progression |
| Contrôleur | Icône + modèle · température · état de la batterie |
| Volume logique | name (RAID level) + état / size |
| Carte des disques physiques | Pastilles d’emplacement (S-{slot} + taille), couleur selon l’état, infobulle = model · serial · status |
S’il n’y a pas d’information sur le contrôleur, la carte affiche No controller data ; s’il n’y a aucune carte, elle affiche No storage data.. La liste est paginée par 10 par page.
Règles de couleur des états
Synthèse RAID · état du volume logique (raid_tone) :
| Contient | Couleur | Signification |
|---|---|---|
optimal |
good (vert) | Sain |
degrad |
warn (ambre) | Dégradé — un disque est tombé, une reconstruction est nécessaire |
fail |
crit (rouge) | RAID en échec — données en danger |
| autre | muted (gris) | Inconnu |
État du disque physique (disk_tone) :
| Contient | Couleur | Signification |
|---|---|---|
online / optimal |
good | Sain |
rebuild |
warn | Reconstruction en cours |
fail / missing |
crit | En échec / disparu |
| autre | muted | Inconnu |
Utilisation disque (usage_tone) :
| Utilisation | Couleur |
|---|---|
| ≥ 95 % | crit |
| ≥ 80 % | warn |
| < 80 % | good |
Comment l’utiliser
- Ouvrez Infrastructure ▸ Stockage et RAID depuis le menu.
- Utilisez le filtre par hôte en haut pour vous concentrer sur un serveur, ou affichez
All. - Parcourez d’abord le badge RAID de l’en-tête de chaque carte ; traitez en priorité les cartes ambre et rouges.
- Sur une carte problématique, lisez la carte des disques physiques pour trouver l’emplacement en
Failed/Missing/Rebuild. Survolez une pastille pour obtenir l’infobulle avec le modèle et le numéro de série. - Vérifiez la barre d’utilisation pour voir si le volume de données approche des seuils de 80 %/95 %.
- Si les données semblent périmées, cliquez sur Actualiser en haut à droite.
Cette page n’interroge pas le serveur automatiquement. Les données affichées passent par un cache serveur de 30 secondes, et l’écran ne se met à jour que lorsque vous appuyez sur le bouton d’actualisation (qui réinterroge
/infra/storage/live). Si vous la laissez ouverte pour suivre les tendances, appuyez périodiquement sur actualiser.
Sources de données
Les deux tables proviennent du MySQL hérité (la connexion legacy, en lecture seule). L’application ne les écrit jamais.
| Table | Quoi | Fournisseur |
|---|---|---|
storage_status |
host, status_summary, json_data (controllers/logical_volumes/disks), created_at |
sync_adp.js (arcconf d’Adaptec) |
server_status |
Instantané de la part df-* → utilisation disque |
run_report.js |
Forme de json_data (exemple)
{
  "controllers": [
    {
      "model": "Adaptec ASR-5805",
      "temperature": "41C",
      "battery_status": "Optimal",
      "status": "Optimal",
      "logical_volumes": [
        { "name": "Data", "raid_level": "6", "status": "Optimal", "size": "10.9TB" }
      ],
      "disks": [
        { "slot": 0, "status": "Online", "model": "ST4000NM0033", "serial": "Z1Z00000", "size": "3.6TB" }
      ]
    }
  ]
}
Forme de la valeur df-*
server_status.value est un JSON qui porte p (pourcentage) · u (utilisé) · a (disponible).
{ "p": 72, "u": "7.2T", "a": "2.8T" }
Correspondance hôte ↔ alias
L’utilisation est jointe via une table statique reliant storage_status.host (libellé en majuscules) à server_status.server_alias (en minuscules). Les hôtes absents de cette table retombent sur le nom d’hôte en minuscules.
| host | alias | host | alias | |
|---|---|---|---|---|
| AMBER | am | ART | art | |
| MEDIA | media | BUD | bud | |
| ARCH1 | arch1 | GLORY | glory | |
| SOL | sol | DOCU | documents | |
| BLUE | blue | DNS_SERVER | demo |
Requête à fenêtre de seq — éviter les balayages lents
server_status est une grande série temporelle. Agréger la table entière avec MAX(seq) … GROUP BY server_alias, part déclenche un balayage complet. À la place, le constructeur (StorageStatusService::dfUsageByAlias) ne récupère par l’index que les 3 valeurs de seq les plus récentes, puis ne lit que les lignes df-* de ces seq.
-- 1) Les 3 valeurs de seq les plus récentes (index seq → O(log N))
SELECT DISTINCT seq FROM server_status ORDER BY seq DESC LIMIT 3;

-- 2) Seulement les lignes df-* de ces seq (de la plus ancienne à la plus récente, la dernière l’emporte)
SELECT server_alias, part, value
  FROM server_status
 WHERE seq IN (?, ?, ?) AND part LIKE 'df-%'
 ORDER BY seq;
Pour chaque alias, il privilégie la part df-data ; à défaut, il retient comme valeur représentative le volume dont l’utilisation est la plus élevée (p maximal).
Les lignes RAID les plus récentes sont de même réduites à la plus récente par hôte.
SELECT MAX(id) AS mid FROM storage_status GROUP BY host;   -- la plus récente par hôte
SELECT * FROM storage_status WHERE id IN (?, ...) ORDER BY host;
Les résultats sont mis en cache pendant 30 secondes sous la clé
infr:infra:storage:v1. Cela supprime les allers-retours vers la base héritée et absorbe les consultations simultanées. Si la base héritée est injoignable, le constructeur avale l’exception et renvoie un tableau vide : l’écran se dégrade proprement enNo storage data..
Accès
- Consultation : tout utilisateur authentifié (minimum
user_level1 = demo pour le domaine Infrastructure) peut la consulter. La route se trouve dans le groupeinfr.auth. - Aucune écriture : cet écran est entièrement en lecture seule. Aucune action n’y modifie l’état du RAID ou des disques, ni ne manipule les grappes (le remplacement et la reconstruction sont réalisés par un SE sur l’hôte concerné).
- La création et la modification des actifs de stockage (métadonnées des équipements, zones de fichiers) s’effectuent sur l’écran distinct Actifs ▸ Stockage et fichiers, dont les écritures exigent un
user_levelde 2 ou plus.
Dépannage et FAQ
Q. La carte s’affiche mais l’utilisation (DATA VOL) est vide.
L’alias de l’hôte n’a correspondu à aucune donnée df-* dans la fenêtre de seq récente. Vérifiez que run_report.js tourne sur ce nœud et que la correspondance hôte↔alias est correcte. Cette correspondance est une table statique, distincte de la configuration de run_report dans Administration ▸ Collecteurs.
Q. La carte des disques ou le contrôleur affiche « No controller data ».
Le tableau controllers de storage_status.json_data est vide ou n’a pas pu être analysé. Cet hôte n’a peut-être pas de RAID Adaptec, ou la collecte sync_adp.js (arcconf) échoue. Vérifiez le chemin et les droits d’arcconf.
Q. Tout affiche « No storage data. ».
Échec de connexion à la base héritée, ou storage_status ne contient aucune ligne. Le constructeur renvoie un tableau vide en cas d’exception. Vérifiez la connexion legacy (DB_* dans .env) et la santé du collecteur.
Q. Les valeurs sont les mêmes qu’il y a quelques minutes.
(1) Cette page n’interroge pas automatiquement — appuyez sur actualiser. (2) Le cache serveur vit 30 secondes. (3) Fondamentalement, les collecteurs (sync_adp.js, run_report.js) s’exécutent hors de Laravel selon une planification : la fraîcheur de la source dépend donc de la cadence du cron.
Q. Un badge Degraded est apparu — que faire ?
Repérez l’emplacement en Failed/Missing dans la carte des disques physiques, remplacez ce disque et vérifiez que le contrôleur démarre un Rebuild automatique. Pendant une reconstruction, la grappe est vulnérable à une double panne : contrôlez donc aussi votre dispositif de sauvegarde (Sauvegarde ▸ Tableau de planification).
Voir aussi
- Infrastructure ▸ Santé — état en direct du CPU · de la mémoire · du disque · des services par nœud.
- Infrastructure ▸ Serveurs — séries temporelles de charge par serveur.
- Infrastructure ▸ Alertes — politiques d’alerte sur l’espace disque libre et l’état RAID.
- Actifs ▸ Stockage et fichiers — registre des actifs de stockage et arborescence des zones de fichiers (écriture).
- Administration ▸ Collecteurs — registre des collecteurs
sync_adp.jsetrun_report.js.