개요 — 무엇을 하나
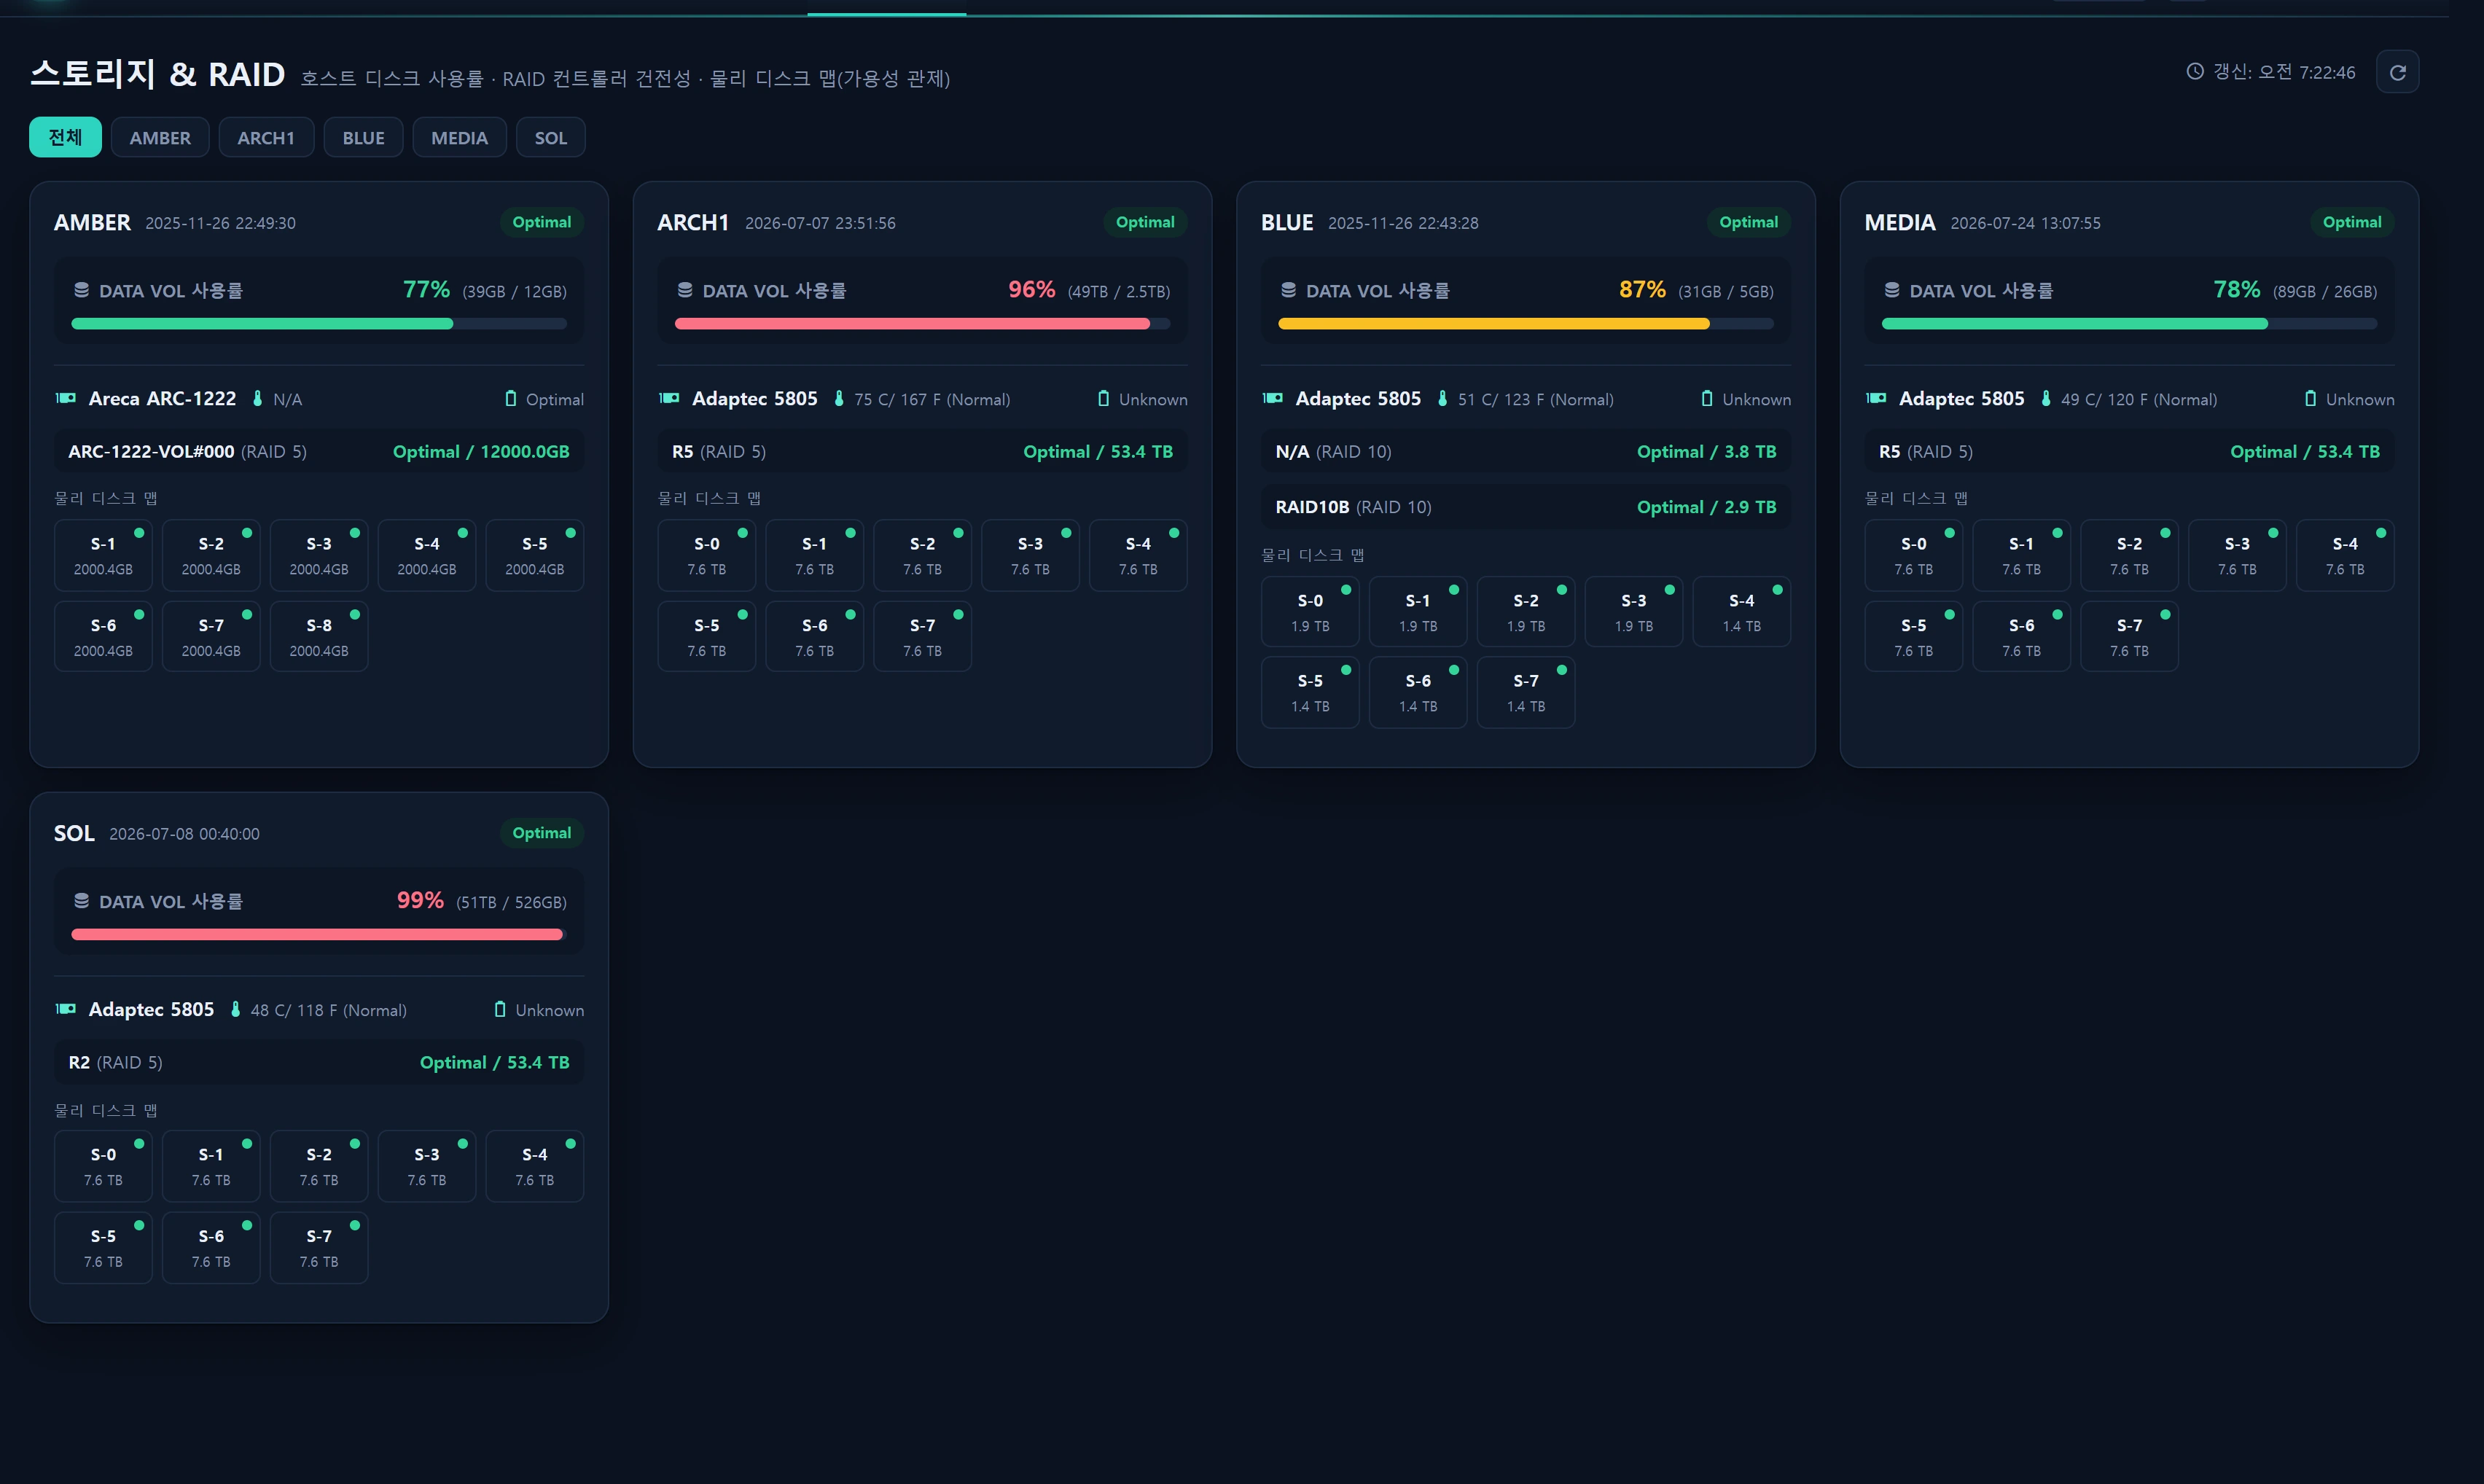
Infrastructure ▸ Storage & RAID(/infra/storage)는 각 호스트의 스토리지 건전성을 한 화면에 모아 보여주는 읽기 전용 가용성 관제 대시보드입니다. 두 종류의 텔레메트리를 카드로 조립합니다.
- RAID 컨트롤러 건전성 — 레거시
storage_status.json_data(Adaptecarcconf수집 결과)에서 컨트롤러 상태(Optimal/Degraded/Failed), 온도, 배터리 상태, 논리 볼륨(RAID 레벨·상태·용량), 물리 디스크 맵(슬롯별 상태·모델·시리얼·용량)을 뽑습니다. - 데이터 볼륨 디스크 사용률 — 레거시
server_status의df-*스냅샷에서 데이터 볼륨 사용률(%)·사용량·여유를 뽑아 카드 상단에 표시합니다.
핵심 목적은 디스크 fail 조기 경보입니다. RAID 어레이가 Degraded로 떨어지거나 물리 디스크가 Failed/Missing으로 빠졌을 때 색상(amber/red)으로 즉시 눈에 띄게 하여, 두 번째 디스크가 죽어 어레이 전체가 무너지기 전에 교체·재구성을 유도합니다.
이 화면은 라이브 status(지금 이 순간의 건전성)만 다룹니다. 스토리지 자산 대장(장비 메타데이터·용량 계획·파일 영역 트리)은 Assets ▸ Storage & Files가 소유합니다. 둘은 의도적으로 분리되어 있습니다(§데이터 소스).
언제 쓰나
- 정기 순회 점검에서 모든 노드의 RAID 상태를 한눈에 확인할 때.
- 서버가 느려지거나 I/O 경고가 뜰 때 디스크 여유 공간·어레이 상태를 빠르게 진단할 때.
- 디스크 교체 작업 전후로 재구성(rebuild) 진행·완료를 슬롯 맵으로 눈으로 확인할 때.
- Infrastructure ▸ Alerts의 디스크 여유 경보가 울렸을 때, 어느 볼륨이 문제인지 드릴다운할 때.
화면 구성
히어로 · 컨트롤 바
- 제목/부제 + 갱신 시각(
갱신: HH:MM:SS) + 새로고침 버튼(수동 폴링). - 호스트 필터 바 —
전체+ 호스트별 버튼. 선택 시 해당 호스트만 남기고 1페이지로 이동합니다.
스토리지 카드
호스트별로 한 장의 카드가 렌더됩니다.
| 영역 | 내용 |
|---|---|
| 헤더 | 호스트명 · 마지막 갱신 시각 · RAID 요약 배지(status_summary) |
| 사용률 | DATA VOL 사용률 라벨 + 퍼센트 + (사용량 / 여유) + 트랙 바 |
| 컨트롤러 | 아이콘 + 모델 · 온도 · 배터리 상태 |
| 논리 볼륨 | 이름 (RAID 레벨) + 상태 / 용량 |
| 물리 디스크 맵 | 슬롯 칩(S-{slot} + 용량), 상태별 색상, 툴팁=모델 · 시리얼 · 상태 |
컨트롤러 정보가 없으면 컨트롤러 정보 없음, 카드가 하나도 없으면 스토리지 데이터가 없습니다.를 표시합니다. 목록은 10개/페이지 페이저로 넘깁니다.
상태 색상 규칙
RAID 요약 · 논리 볼륨 상태(raid_tone):
| 문자열에 포함 | 색상 | 의미 |
|---|---|---|
optimal |
good(녹색) | 정상 |
degrad |
warn(황색) | 성능 저하 — 디스크 1개 실패, 재구성 필요 |
fail |
crit(적색) | RAID 실패 — 데이터 위험 |
| 그 외 | muted(회색) | 알 수 없음 |
물리 디스크 상태(disk_tone):
| 문자열에 포함 | 색상 | 의미 |
|---|---|---|
online / optimal |
good | 정상 |
rebuild |
warn | 재구성 진행 중 |
fail / missing |
crit | 실패·이탈 |
| 그 외 | muted | 알 수 없음 |
디스크 사용률(usage_tone):
| 사용률 | 색상 |
|---|---|
| ≥ 95% | crit |
| ≥ 80% | warn |
| < 80% | good |
사용법
- 메뉴 Infrastructure ▸ Storage & RAID로 진입합니다.
- 상단 호스트 필터로 특정 서버만 볼지,
전체를 볼지 선택합니다. - 카드 헤더 RAID 배지로 어레이 건전성을 먼저 훑습니다. 황색/적색 카드를 우선 확인합니다.
- 문제 카드에서 물리 디스크 맵을 보고 어느 슬롯이
Failed/Missing/Rebuild인지 확인합니다. 칩에 마우스를 올리면 모델·시리얼이 툴팁으로 나옵니다. - 사용률 바로 데이터 볼륨이 80%/95% 임계에 근접했는지 확인합니다.
- 값이 오래됐다 싶으면 우측 상단 새로고침을 누릅니다.
이 페이지는 자동 폴링을 하지 않습니다. 표시 데이터는 서버 측 30초 캐시를 거치며, 화면 갱신은 새로고침 버튼을 눌러야 일어납니다(
/infra/storage/live재조회). 장시간 열어두고 트렌드를 감시할 때는 주기적으로 눌러 주세요.
데이터 소스
두 테이블 모두 레거시 MySQL(legacy 커넥션, 읽기 전용)에서 옵니다. 앱은 절대 쓰지 않습니다.
| 테이블 | 무엇 | 공급자 |
|---|---|---|
storage_status |
host, status_summary, json_data(컨트롤러/논리 볼륨/디스크), created_at |
sync_adp.js(Adaptec arcconf) |
server_status |
df-* 파트 스냅샷 → 디스크 사용률 |
run_report.js |
json_data 형태(예시)
{
  "controllers": [
    {
      "model": "Adaptec ASR-5805",
      "temperature": "41C",
      "battery_status": "Optimal",
      "status": "Optimal",
      "logical_volumes": [
        { "name": "Data", "raid_level": "6", "status": "Optimal", "size": "10.9TB" }
      ],
      "disks": [
        { "slot": 0, "status": "Online", "model": "ST4000NM0033", "serial": "Z1Z00000", "size": "3.6TB" }
      ]
    }
  ]
}
df-* value 형태
server_status.value는 JSON이며 p(퍼센트)·u(사용량)·a(여유)를 담습니다.
{ "p": 72, "u": "7.2T", "a": "2.8T" }
호스트 ↔ alias 매핑
storage_status.host(대문자 라벨)를 server_status.server_alias(소문자)로 잇는 정적 맵으로 사용률을 붙입니다. 맵에 없으면 호스트명을 소문자로 변환합니다.
| host | alias | host | alias | |
|---|---|---|---|---|
| AMBER | am | ART | art | |
| MEDIA | media | BUD | bud | |
| ARCH1 | arch1 | GLORY | glory | |
| SOL | sol | DOCU | documents | |
| BLUE | blue | DNS_SERVER | demo |
seq-window 조회 — slow query 회피
server_status는 대용량 시계열입니다. 전 테이블을 MAX(seq) … GROUP BY server_alias, part로 집계하면 풀스캔이 걸립니다. 대신 최근 seq 3개만 인덱스로 뽑고, 그 seq에 속한 df-* 행만 읽습니다(빌더 StorageStatusService::dfUsageByAlias).
-- 1) 최근 seq 3개 (seq 인덱스 → O(log N))
SELECT DISTINCT seq FROM server_status ORDER BY seq DESC LIMIT 3;

-- 2) 그 seq 안의 df-* 행만 (오래된→최신 정렬, 최신이 덮어씀)
SELECT server_alias, part, value
  FROM server_status
 WHERE seq IN (?, ?, ?) AND part LIKE 'df-%'
 ORDER BY seq;
alias별로 df-data 파트를 우선 선택하고, 없으면 사용률이 가장 높은 볼륨(p 최대)을 대표값으로 씁니다.
RAID 최신 행도 호스트별 최신만 좁혀 읽습니다.
SELECT MAX(id) AS mid FROM storage_status GROUP BY host;   -- host 별 최신
SELECT * FROM storage_status WHERE id IN (?, ...) ORDER BY host;
결과는 캐시 키
infr:infra:storage:v1에 30초 캐시됩니다. 레거시 DB 왕복을 억제하고 여러 사용자의 동시 조회를 흡수합니다. 레거시 DB가 불통이면 빌더가 예외를 삼키고 빈 배열을 반환해, 화면은스토리지 데이터가 없습니다.로 우아하게 비어 있습니다.
권한
- 조회: 인증된 사용자(Infrastructure 영역 최소
user_level1 = demo)면 볼 수 있습니다. 라우트는infr.auth그룹에 속합니다. - 쓰기 없음: 이 화면은 완전 읽기 전용입니다. RAID/디스크 상태를 변경하거나 어레이를 조작하는 액션이 없습니다(교체·재구성은 대상 호스트에서 SE가 수행).
- 스토리지 자산 등록/편집(장비 메타·파일 영역)은 별도 화면인 Assets ▸ Storage & Files에서 이루어지며 그쪽 쓰기는
user_level2 이상입니다.
문제해결 · FAQ
Q. 카드는 뜨는데 사용률(DATA VOL)이 비어 있습니다.
해당 호스트의 alias가 최근 seq 창의 df-* 데이터와 매칭되지 않은 경우입니다. run_report.js 수집기가 그 노드에서 돌고 있는지, host↔alias 매핑이 맞는지 확인하세요. 매핑은 Admin ▸ Collectors의 run_report 설정과 별개의 정적 맵입니다.
Q. 물리 디스크 맵/컨트롤러가 "컨트롤러 정보 없음"으로 나옵니다.
storage_status.json_data에 controllers가 비어 있거나 파싱 실패입니다. 그 호스트에 Adaptec RAID가 없거나 sync_adp.js(arcconf) 수집이 안 되는 상태일 수 있습니다. arcconf 경로·권한을 점검하세요.
Q. 전체가 "스토리지 데이터가 없습니다."
레거시 DB 연결 실패 또는 storage_status에 행이 없을 때입니다. 빌더는 예외 시 빈 배열을 반환합니다. legacy 커넥션(.env DB_*)과 수집기 상태를 확인하세요.
Q. 값이 몇 분 전 그대로입니다.
(1) 이 페이지는 자동 폴링을 하지 않습니다 — 새로고침을 누르세요. (2) 서버 캐시가 30초 살아 있습니다. (3) 근본적으로 수집기(sync_adp.js, run_report.js)는 Laravel 밖에서 주기 실행되므로, 원천 데이터 신선도는 크론 주기에 달려 있습니다.
Q. Degraded 배지가 떴는데 어떻게 하나요.
물리 디스크 맵에서 Failed/Missing 슬롯을 찾아 그 디스크를 교체하고, 컨트롤러가 자동 재구성(Rebuild)을 시작하는지 확인합니다. 재구성 중에는 어레이가 이중 장애에 취약하니 백업 상태를 함께 점검하세요(Backup ▸ Board).
관련 항목
- Infrastructure ▸ Health — 노드별 CPU·메모리·디스크·서비스 라이브 관제.
- Infrastructure ▸ Servers — 서버별 부하 시계열.
- Infrastructure ▸ Alerts — 디스크 여유·RAID 상태 경보 정책.
- Assets ▸ Storage & Files — 스토리지 자산 대장·파일 영역 트리(쓰기).
- Administration ▸ Collectors —
sync_adp.js·run_report.js수집기 레지스트리.