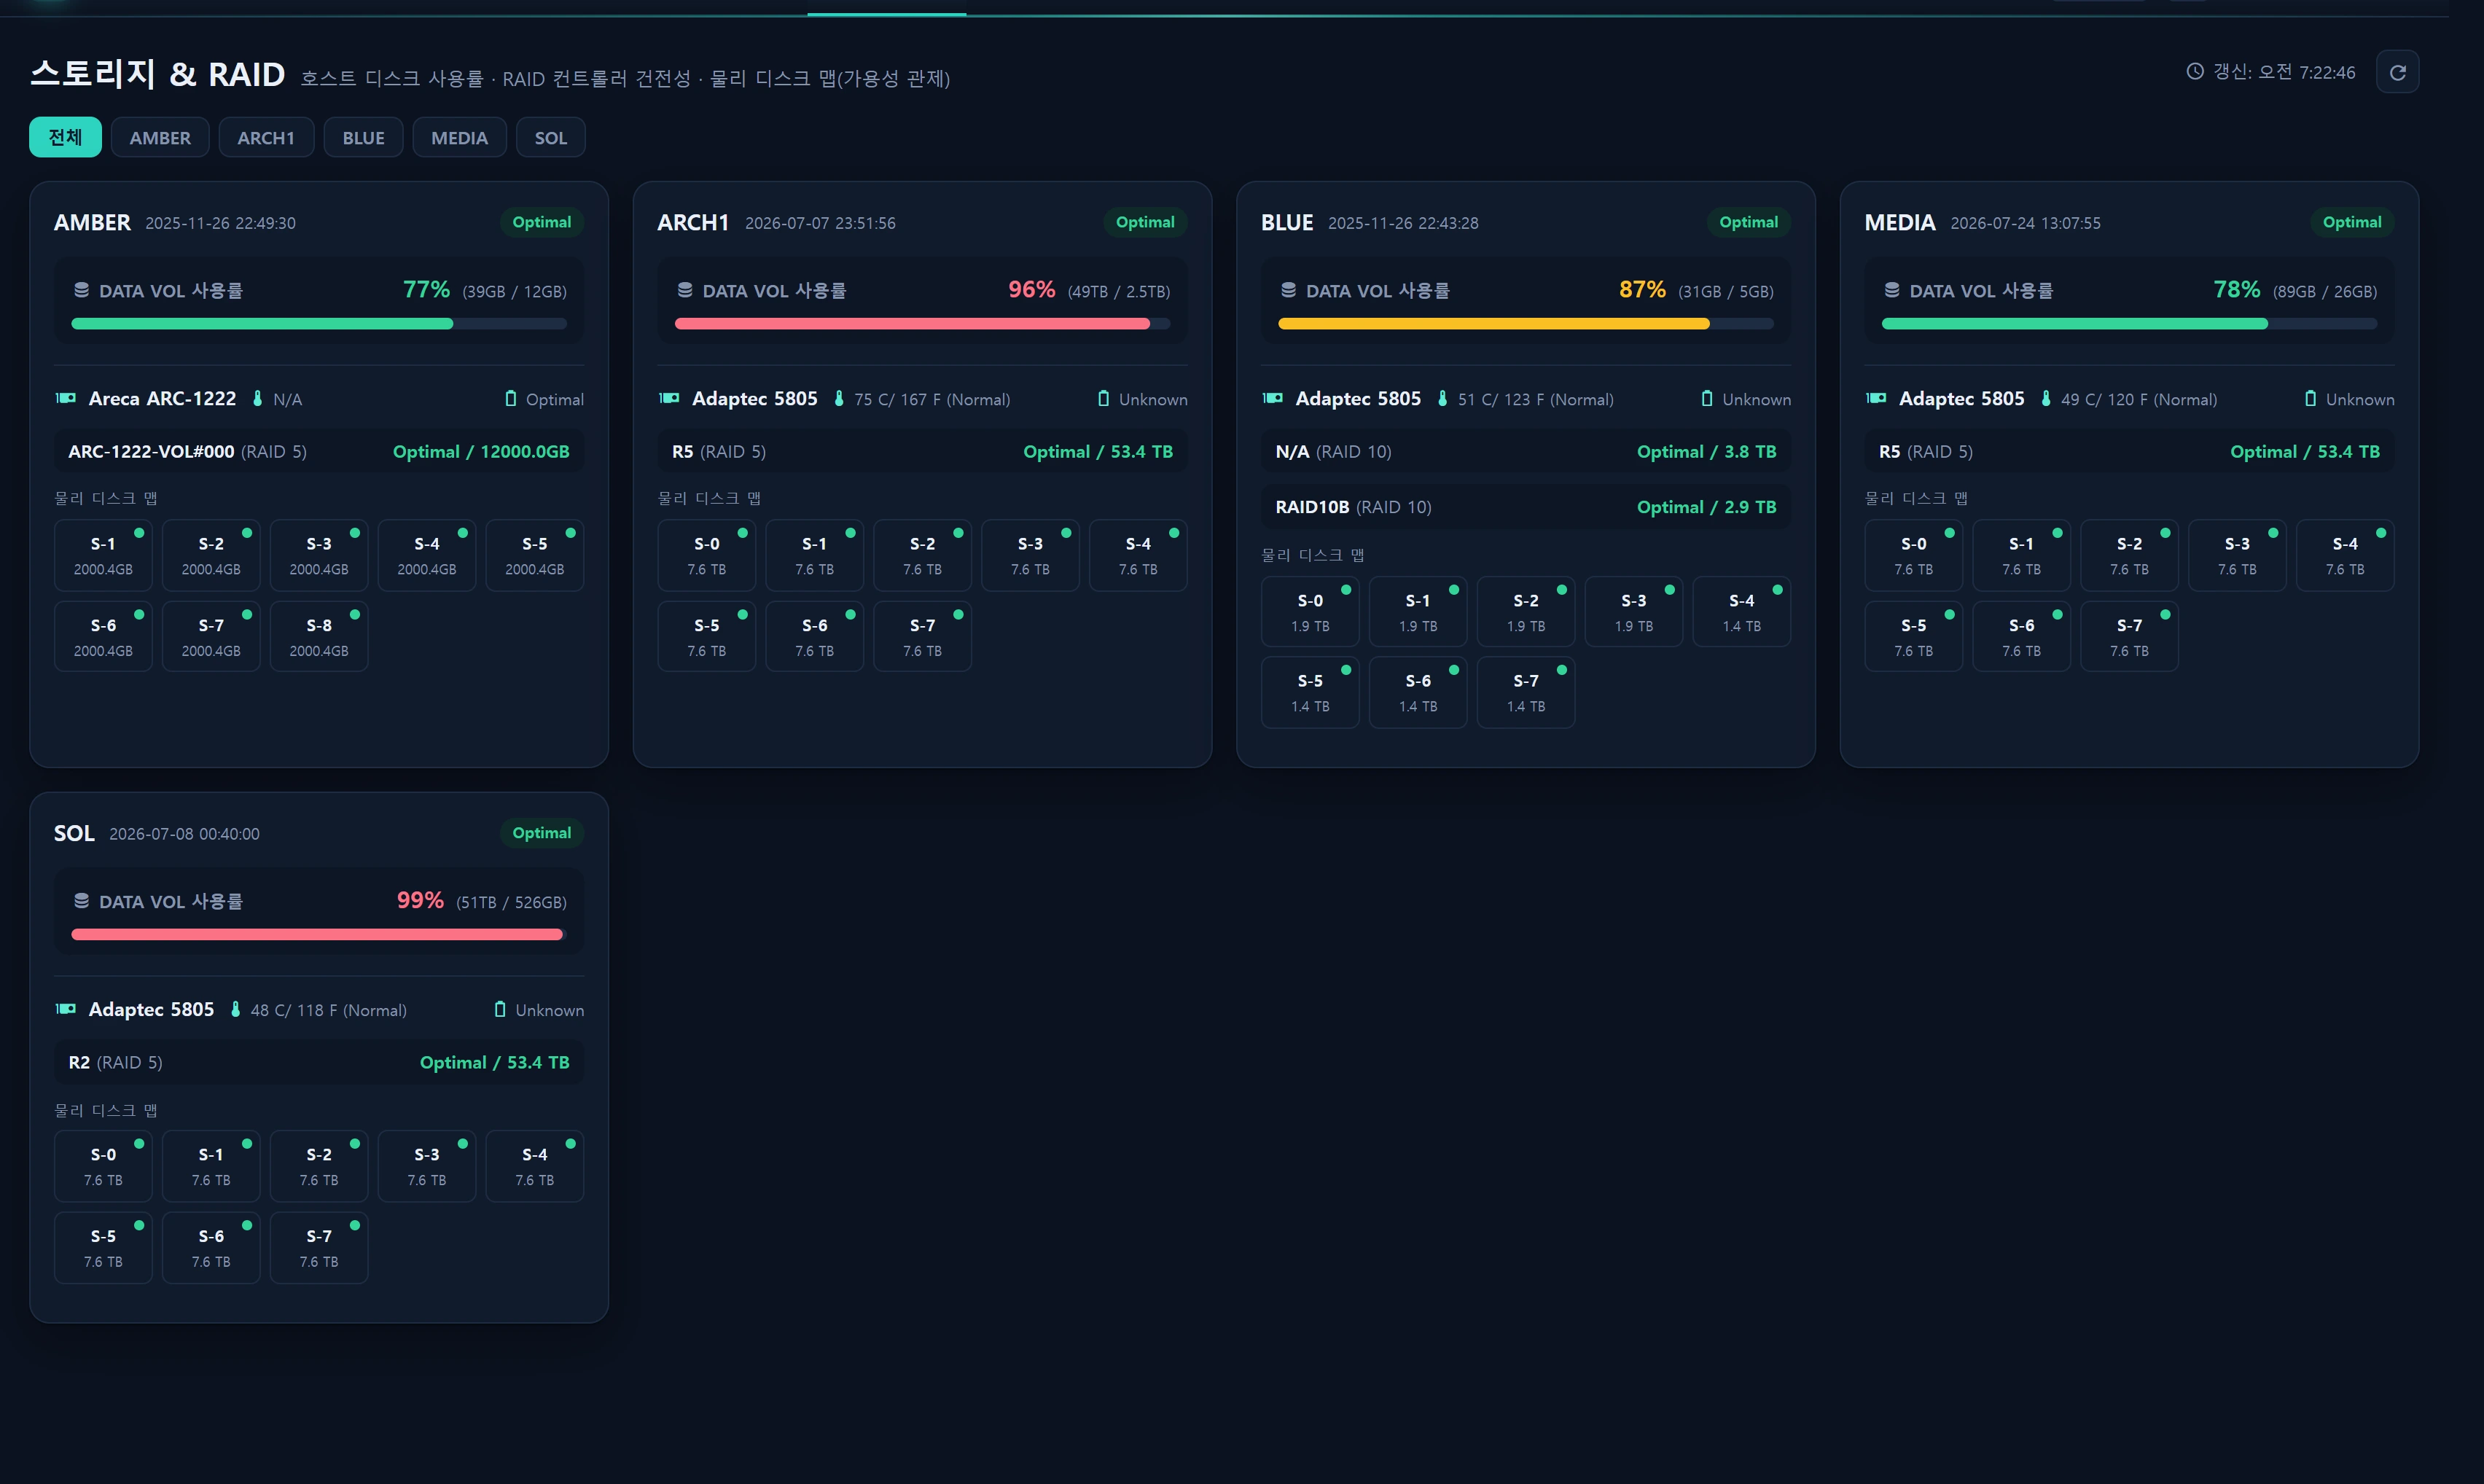
Обзор — что делает этот экран
Инфраструктура ▸ Хранилище и RAID (/infra/storage) — это панель доступности только для чтения, собирающая состояние хранилища каждого узла на одном экране. Она складывает в карточки два вида телеметрии.
- Состояние RAID-контроллера — из устаревшей таблицы
storage_status.json_data(вывод сбора Adaptecarcconf): статус контроллера (Optimal/Degraded/Failed), температура, состояние батареи, логические тома (уровень RAID · статус · размер) и карта физических дисков (статус по слотам · модель · серийный номер · размер). - Использование дискового пространства тома данных — из снимка
df-*в устаревшей таблицеserver_status: процент использования · занято · доступно для тома данных, показанные в верхней части карточки.
Основная задача экрана — раннее предупреждение об отказе диска. Когда RAID-массив опускается до Degraded, а физический диск переходит в Failed/Missing, цвет (янтарный/красный) делает это заметным немедленно, и вы успеваете заменить диск и выполнить перестроение до того, как откажет второй диск и рассыплется весь массив.
Этот экран охватывает только живое состояние (здоровье прямо сейчас). Реестр активов хранилища (метаданные устройств, планирование ёмкости, дерево файловых областей) принадлежит разделу Активы ▸ Хранилище и файлы. Они разделены намеренно (см. «Источники данных»).
Когда использовать
- Во время регулярных обходов — чтобы одним взглядом увидеть состояние RAID на всех узлах.
- Когда сервер тормозит или приходят предупреждения ввода-вывода — чтобы быстро оценить свободное место на дисках и состояние массива.
- До и после замены диска — чтобы визуально подтвердить ход или завершение перестроения по карте слотов.
- Когда в разделе Инфраструктура ▸ Оповещения срабатывает оповещение о свободном месте на диске и нужно выяснить, какой том затронут.
Компоновка
Заглавный блок · панель управления
- Заголовок/подзаголовок + отметка времени последнего обновления (
Updated: HH:MM:SS) + кнопка обновления (ручной опрос). - Строка фильтра по узлам —
Allплюс по одной кнопке на каждый узел. Выбор узла фильтрует список по нему и возвращает на страницу 1.
Карточка хранилища
На каждый узел отрисовывается одна карточка.
| Область | Содержимое |
|---|---|
| Заголовок | Имя узла · время последнего обновления · сводный значок RAID (status_summary) |
| Использование | Подпись DATA VOL usage + процент + (used / available) + полоса заполнения |
| Контроллер | Значок + модель · температура · состояние батареи |
| Логический том | name (RAID level) + статус / size |
| Карта физических дисков | Чипы слотов (S-{slot} + размер), цвет по статусу, всплывающая подсказка = model · serial · status |
Если сведений о контроллере нет, карточка показывает No controller data; если карточек нет вовсе, выводится No storage data.. Список разбивается по 10 записей на страницу.
Правила цвета статусов
Сводка RAID · статус логического тома (raid_tone):
| Содержит | Цвет | Значение |
|---|---|---|
optimal |
good (зелёный) | Исправно |
degrad |
warn (янтарный) | Деградация — один диск отказал, нужно перестроение |
fail |
crit (красный) | Отказ RAID — данные под угрозой |
| прочее | muted (серый) | Неизвестно |
Статус физического диска (disk_tone):
| Содержит | Цвет | Значение |
|---|---|---|
online / optimal |
good | Исправно |
rebuild |
warn | Идёт перестроение |
fail / missing |
crit | Отказ / пропал |
| прочее | muted | Неизвестно |
Использование диска (usage_tone):
| Использование | Цвет |
|---|---|
| ≥ 95 % | crit |
| ≥ 80 % | warn |
| < 80 % | good |
Как пользоваться
- Откройте Инфраструктура ▸ Хранилище и RAID из меню.
- С помощью фильтра по узлам вверху сосредоточьтесь на одном сервере или выберите
All. - Сначала просмотрите значок RAID в заголовке каждой карточки; в первую очередь занимайтесь янтарными и красными карточками.
- На проблемной карточке изучите карту физических дисков и найдите слот со статусом
Failed/Missing/Rebuild. Наведите курсор на чип, чтобы увидеть подсказку с моделью и серийным номером. - Проверьте полосу использования, чтобы понять, не приближается ли том данных к порогам 80 %/95 %.
- Если данные выглядят устаревшими, нажмите Обновить в правом верхнем углу.
Эта страница не опрашивает сервер автоматически. Отображаемые данные проходят через 30-секундный кэш на сервере, и экран обновляется только при нажатии кнопки обновления (она заново запрашивает
/infra/storage/live). Если вы оставляете страницу открытой, чтобы следить за динамикой, периодически нажимайте обновление.
Источники данных
Обе таблицы берутся из устаревшей MySQL (соединение legacy, только чтение). Приложение никогда в них не пишет.
| Таблица | Что | Поставщик |
|---|---|---|
storage_status |
host, status_summary, json_data (controllers/logical_volumes/disks), created_at |
sync_adp.js (Adaptec arcconf) |
server_status |
Снимок part df-* → использование диска |
run_report.js |
Структура json_data (пример)
{
  "controllers": [
    {
      "model": "Adaptec ASR-5805",
      "temperature": "41C",
      "battery_status": "Optimal",
      "status": "Optimal",
      "logical_volumes": [
        { "name": "Data", "raid_level": "6", "status": "Optimal", "size": "10.9TB" }
      ],
      "disks": [
        { "slot": 0, "status": "Online", "model": "ST4000NM0033", "serial": "Z1Z00000", "size": "3.6TB" }
      ]
    }
  ]
}
Структура значения df-*
server_status.value — это JSON, несущий p (процент) · u (занято) · a (доступно).
{ "p": 72, "u": "7.2T", "a": "2.8T" }
Сопоставление узла ↔ алиаса
Использование связывается через статическую карту соответствий из storage_status.host (метка в верхнем регистре) в server_status.server_alias (в нижнем регистре). Для узлов, отсутствующих в карте, используется имя узла, приведённое к нижнему регистру.
| host | alias | host | alias | |
|---|---|---|---|---|
| AMBER | am | ART | art | |
| MEDIA | media | BUD | bud | |
| ARCH1 | arch1 | GLORY | glory | |
| SOL | sol | DOCU | documents | |
| BLUE | blue | DNS_SERVER | demo |
Запрос по окну seq — как избежать медленных сканирований
server_status — это большой временной ряд. Агрегирование всей таблицы через MAX(seq) … GROUP BY server_alias, part приводит к полному сканированию. Вместо этого построитель (StorageStatusService::dfUsageByAlias) по индексу извлекает только 3 самых свежих значения seq, а затем читает лишь строки df-* внутри этих seq.
-- 1) Три самых свежих значения seq (индекс seq → O(log N))
SELECT DISTINCT seq FROM server_status ORDER BY seq DESC LIMIT 3;

-- 2) Только строки df-* внутри этих seq (от старых к новым, побеждает самая новая)
SELECT server_alias, part, value
  FROM server_status
 WHERE seq IN (?, ?, ?) AND part LIKE 'df-%'
 ORDER BY seq;
Для каждого алиаса предпочтение отдаётся part df-data; если её нет, представительным значением берётся том с наибольшим использованием (максимальное p).
Самые свежие строки RAID точно так же сужаются до новейшей по каждому узлу.
SELECT MAX(id) AS mid FROM storage_status GROUP BY host;   -- новейшая по каждому узлу
SELECT * FROM storage_status WHERE id IN (?, ...) ORDER BY host;
Результаты кэшируются на 30 секунд по ключу
infr:infra:storage:v1. Это снимает обращения к устаревшей БД и поглощает одновременные просмотры. Если устаревшая БД недоступна, построитель проглатывает исключение и возвращает пустой массив, поэтому экран мягко деградирует доNo storage data..
Доступ
- Просмотр: экран доступен любому аутентифицированному пользователю (минимальный
user_level1 = demo для области «Инфраструктура»). Маршрут находится в группеinfr.auth. - Без записи: этот экран полностью предназначен только для чтения. Здесь нет действий, изменяющих состояние RAID или дисков либо управляющих массивами (замену и перестроение выполняет SE на целевом узле).
- Создание и правка активов хранилища (метаданные устройств, файловые области) выполняются на отдельном экране Активы ▸ Хранилище и файлы, запись на котором требует
user_level2 или выше.
Диагностика и частые вопросы
В. Карточка отображается, но использование (DATA VOL) пустое.
alias узла не совпал ни с одними данными df-* в недавнем окне seq. Убедитесь, что на этом узле работает run_report.js и что сопоставление узел↔алиас верно. Это сопоставление задано статической картой и не связано с конфигурацией run_report в разделе Администрирование ▸ Коллекторы.
В. Карта дисков или контроллер показывает «No controller data».
Массив controllers в storage_status.json_data пуст либо не разобран. Возможно, на этом узле нет RAID Adaptec, либо сбор sync_adp.js (arcconf) завершается ошибкой. Проверьте путь к arcconf и права доступа.
В. Всё показывает «No storage data.».
Сбой соединения с устаревшей БД либо в storage_status нет строк. При исключении построитель возвращает пустой массив. Проверьте соединение legacy (DB_* в .env) и работоспособность коллектора.
В. Значения те же, что и несколько минут назад.
(1) Эта страница не опрашивает сервер сама — нажмите обновление. (2) Серверный кэш живёт 30 секунд. (3) По сути коллекторы (sync_adp.js, run_report.js) работают по расписанию вне Laravel, поэтому свежесть источника зависит от периодичности cron.
В. Появился значок Degraded — что делать?
Найдите на карте физических дисков слот со статусом Failed/Missing, замените этот диск и убедитесь, что контроллер начал автоматическое Rebuild. Во время перестроения массив уязвим к двойному отказу, поэтому проверьте также состояние резервных копий (Резервное копирование ▸ Доска расписания).
Связанные материалы
- Инфраструктура ▸ Состояние — живое состояние ЦП · памяти · диска · сервисов по каждому узлу.
- Инфраструктура ▸ Серверы — временные ряды нагрузки по каждому серверу.
- Инфраструктура ▸ Оповещения — политики оповещений о свободном месте на диске и состоянии RAID.
- Активы ▸ Хранилище и файлы — реестр активов хранилища и дерево файловых областей (с записью).
- Администрирование ▸ Коллекторы — реестр коллекторов
sync_adp.jsиrun_report.js.