Vue d’ensemble — à quoi ça sert
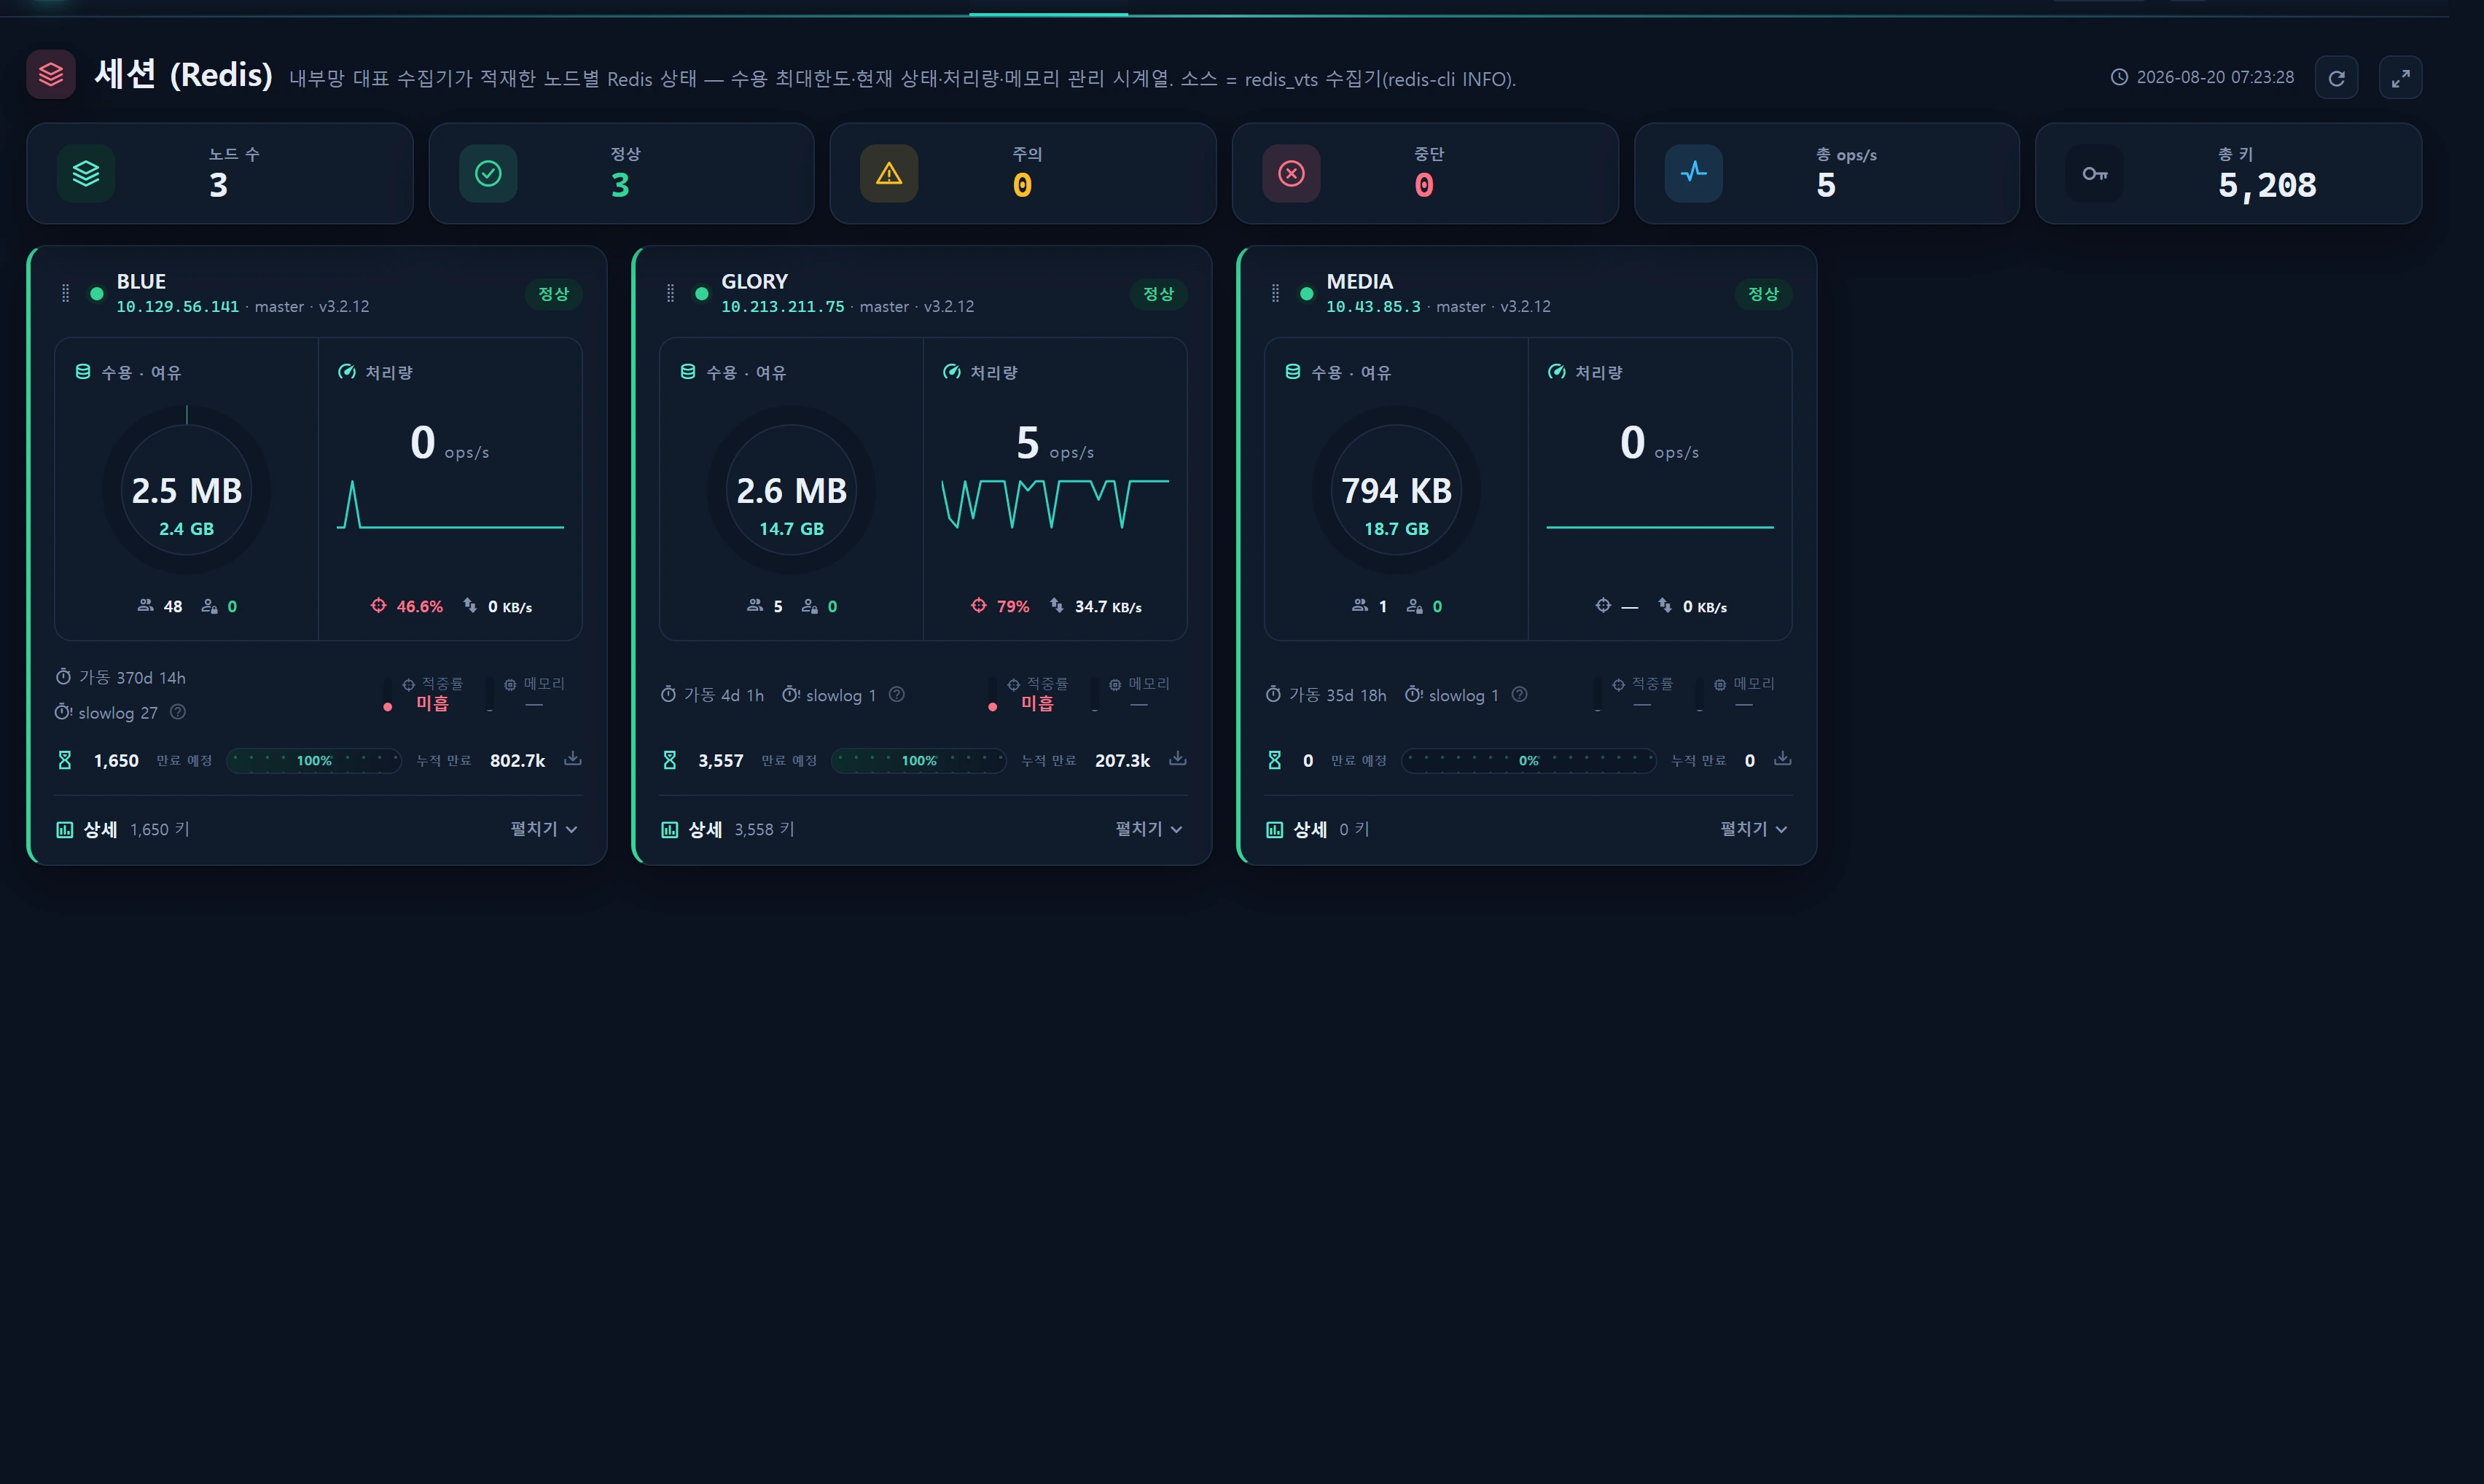
Cet article explique comment lire les métriques affichées sur l’écran Service ▸ Sessions (Redis) (/service/session) et comment agir en conséquence. Cet écran est une console de supervision en direct ; la présente page expose les concepts d’exploitation Redis qui la sous-tendent — slowlog, taux de succès du keyspace, fragmentation mémoire, et expiration contre éviction.
InfraGuard ne se connecte jamais directement à Redis. Un collecteur représentant du réseau interne (scripts/infr_redis_vts_collector.cjs, exécuté sous pm2 en cron à la minute) prend un instantané redis-cli INFO de chaque nœud et l’écrit dans la table MySQL centrale infr_redis_metric ; l’application se contente de lire cette table. Toutes les valeurs présentées ici proviennent donc de champs INFO standard.
Le lexique exact et les conseils d’amélioration de chaque métrique sont centralisés dans les popovers pédagogiques (au survol) de l’écran Sessions (
edu.*dansresources/lang/{ko,en}/redis.php). Cet article résume et relie ces concepts au lieu de les redéfinir — survolez les popovers en direct pour le détail complet.
Quand l’utiliser
- Une carte de session est passée en Dégradé / Hors service et vous voulez comprendre le code de motif (
mem_saturation,fragmentation,blocked_clients,replica_link_down,rdb_save_failed,stale). - Le taux de succès semble faible alors que le nœud paraît sain (déterminer si c’est normal pour un magasin de sessions).
- Le ratio de fragmentation est monté au-dessus de 1,5 ou descendu sous 1,0 et vous cherchez la cause et le remède.
- L’éviction s’est mise à dépasser 0 et vous craignez une perte de sessions.
- Le slowlog ne cesse de croître et vous devez identifier le motif de commande à corriger.
Disposition
Une carte de session représente un nœud (node_alias = infr_instance.alias, 1:1) et reprend la narration de Service ▸ Base de données.
| Zone | Ce qu’elle montre | Champs INFO d’origine |
|---|---|---|
| ① Capacité · Libre | Anneau de capacité mémoire (utilisée / plafond) · clients (connectés/max) · bloqués | used_memory, maxmemory, total_system_memory, connected_clients, maxclients, blocked_clients |
| ② Débit | Sparkline ops/s · taux de succès de la fenêtre récente · E/S réseau | instantaneous_ops_per_sec, keyspace_hits/misses, instantaneous_input/output_kbps |
| Efficacité en pied de carte | Note du taux de succès · note mémoire (fragmentation) | hit_rate, mem_fragmentation_ratio |
| Flux de durée de vie des sessions | À expirer (avec TTL) → flux → total expirées | keyspace_expires, expired_keys |
| Détail (repliable) | Série temporelle de gestion mémoire + superposition du plafond de capacité + épingles d’épisodes d’éviction · analyse keyspace/sessions | série used_memory, evicted_keys, INFO keyspace |
KPI du haut : nombre de nœuds · Actifs/Dégradés/Hors service · total ops/s · total de clés · somme des clients.
Comment la capacité (le plafond) est déterminée
La référence des 100 % (le budget) de la jauge annulaire et du graphique mémoire est choisie dans cet ordre :
- Si
maxmemoryest défini, c’est le plafond dur (Redis l’impose). Libre estimé =maxmemory − used. - S’il n’est pas défini (illimité), budget =
total RAM − DB buffer pool − OS/other reserve (%). La réserve est de 20 % par défaut (Politique d’exploitationredis_reserve_pct) ; le buffer pool de la base de données est soustrait d’après le collecteuraccess=databasedu même nœud.
Un nœud en
maxmemory 0(illimité) affiche la note « maxmemory non défini — affiché par rapport à la RAM du système/serveur ». Sur une instance dédiée aux sessions, définissez unmaxmemoryexplicite (une fraction de la RAM du système) pour que la politique d’éviction se comporte de façon prévisible.
Comment l’utiliser
1) slowlog — pourquoi il grossit (7 causes résumées)
Redis est monothread : une seule commande lente bloque donc tout le serveur. slowlog_len est le compteur cumulé des commandes dépassant slowlog-log-slower-than (10 ms par défaut). Les plus fréquentes d’abord :
- Commandes O(N) —
KEYS *,SMEMBERS,HGETALL,LRANGE 0 -1parcourent des collections entières. La première cause. - Opérations sur grosses clés — chaînes de plusieurs Mo, ou coût de sérialisation + transfert de gros Hash/Set/ZSet.
- Pression mémoire / swap — l’allocation se bloque à mesure que l’utilisation approche du plafond.
- Latence de fork de persistance —
bgsaveRDB / réécriture AOF,latest_fork_usec. - Scripts Lua/fonctions lourds — un
EVALlourd bloque pendant toute son exécution. - Gros pipelines / MULTI — des milliers de commandes d’un coup mettent le reste en file d’attente.
- DEL de grosses clés — utilisez
UNLINKasynchrone plutôt queDEL.
Vérifiez quelles commandes se sont réellement déclenchées, directement sur le nœud :
# 10 dernières commandes lentes (redis-cli)
redis-cli SLOWLOG GET 10
# Seuil + nombre conservé (microsecondes · p. ex. 10 ms)
redis-cli CONFIG SET slowlog-log-slower-than 10000
redis-cli CONFIG SET slowlog-max-len 128
redis-cli SLOWLOG RESET
N’exécutez jamais
KEYS *en production — pendant qu’il parcourt tout le keyspace, toutes les autres commandes attendent. Remplacez-le par les itérateurs à curseurSCAN/HSCAN/SSCAN/ZSCAN.
2) Taux de succès du keyspace — un taux faible n’est pas un défaut
Taux de succès de la fenêtre récente = Δkeyspace_hits / (Δhits + Δmisses). Quand l’échantillon est trop mince (dénominateur delta < 20), on retombe sur le hit_rate cumulé depuis le démarrage. Niveaux : Excellent ≥99% · Bon ≥95% · Correct ≥80%.
Le taux de succès n’est PAS un axe d’état qui fait passer un nœud au rouge. Un magasin de sessions a par nature peu de succès — chaque nouvelle connexion, chaque expiration et chaque déconnexion est un échec, si bien que 40 à 60 % est normal (ainsi,
blueà 44,75 % est un nœud de sessions parfaitement sain). C’est pourquoi, bien qu’un seuilredis_hit_rate_minexiste (50 par défaut), il n’est pas utilisé pour l’état — il n’est affiché qu’à titre d’interprétation. Les vrais problèmes de cache sont détectés, indépendamment de la charge de travail, par la saturation mémoire, l’éviction et la fragmentation ci-dessous.
Pour réellement augmenter le taux de succès : gardez l’ensemble de travail résident (marge RAM/maxmemory), dimensionnez correctement les TTL, atténuez la ruée sur le cache (TTL avec gigue) et préchauffez les préfixes à forts échecs. Voir le popover de succès en direct pour le détail.
3) Fragmentation mémoire — plage saine de 1,0 à 1,5
mem_fragmentation_ratio = used_memory_rss / used_memory — la mémoire physique que le système a donnée à Redis rapportée à celle que Redis utilise réellement.
| Ratio | Signification | Action |
|---|---|---|
| 1.0 – 1.5 | Plage saine | Normal |
| > 1.5 | Fragmentée (RAM gaspillée) | activedefrag yes (nécessite jemalloc), réduire les créations/suppressions fréquentes de grosses valeurs |
| < 1.0 | Swap en cours (danger) | Immédiatement ajouter de la RAM ou baisser maxmemory pour arrêter le swap — signal de ralentissement brutal |
Niveaux : Excellent 0,95–1,4 · Bon ~1,6 · Correct ~2,5. Le seuil d’état redis_frag_ratio vaut 1,6 par défaut.
Sur une petite instance où
used_memoryest inférieur à 64MB, la surcharge fixe domine le ratio et le chiffre de fragmentation devient un faux positif. Dans ce cas, InfraGuard exclut la fragmentation du score (frag_score = null) — la valeur reste affichée, mais ne fait pas passer le nœud au rouge.
4) Expiration contre éviction — le cœur de la durée de vie des sessions
| Terme | Signification | Signal |
|---|---|---|
| Expirées (expired_keys) | TTL écoulé, suppression naturelle = durée de vie normale des sessions | Renouvellement · normalement sain |
| Évincées (evicted_keys) | Suppression forcée à maxmemory selon la politique |
Pression mémoire · risque de perte de sessions |
Dans un magasin de sessions, l’expiration est normale, mais une éviction durablement supérieure à 0 signifie que des sessions vivantes sont supprimées. Réagissez ainsi :
- Taux d’éviction > 0 → ajouter de la RAM / augmenter
maxmemory. - Vérifiez la politique :
allkeys-lruévince aussi les sessions ;volatile-*n’évince que les clés porteuses d’un TTL. - Si
rejected_connectionsaugmente en parallèle, vous avez atteintmaxclientset la limite mémoire en même temps.
# Consulter / modifier la politique d’éviction
redis-cli CONFIG GET maxmemory-policy
redis-cli CONFIG SET maxmemory-policy volatile-lru
# Défragmentation en ligne (pour une fragmentation > 1.5 · nécessite jemalloc)
redis-cli CONFIG SET activedefrag yes
Le graphique de gestion mémoire du détail superpose une ligne de plafond de capacité à 100 % sur used_pct et marque les épisodes d’éviction par des épingles crit — vous pouvez ainsi retracer visuellement le moment où le nœud a touché le plafond et supprimé des sessions.
5) Lire les bases logiques (keyspace)
INFO keyspace indique le nombre de clés des espaces de clés numérotés et indépendants (bases logiques, 16 par défaut, index 0–15).
# INFO keyspace example
db0:keys=48213,expires=48213,avg_ttl=1680000
db1:keys=126,expires=0,avg_ttl=0
La base comptant le plus de clés est le magasin de sessions principal, et si, pour cette base, keys = expires (toutes avec TTL), il s’agit d’un magasin de sessions pur (les clés s’éteignent naturellement). Ci-dessus, db0 se lit comme des sessions (toutes avec TTL) et db1 comme un autre usage (cache/verrous).
Sources de données
| Élément | Valeur |
|---|---|
| Table source | infr_redis_metric (MySQL central · modèle de lecture en lecture seule, $timestamps=false) |
| Collecteur alimentant | scripts/infr_redis_vts_collector.cjs (pm2, à la minute) — redis-cli INFO |
| Provisionnement | Le collecteur la crée lui-même via CREATE TABLE IF NOT EXISTS (aucune migration) |
| Clé de jointure | instance_id (clé étrangère entière en premier) → repli sur node_alias ↔ infr_instance.alias |
| Constructeur | App\Services\Redis\RedisMetricService (une seule requête par lot · cache de 20 s) |
| Fenêtre récente | 30 min (WINDOW_MIN) · jusqu’à 60 points de graphique · sondage de 30 s (/service/session/live) |
| SOT des seuils | App\Support\OpsPolicy::redisThresholds() |
Seuils d’état (Politique d’exploitation infr_setting group=ops) :
| Clé | Défaut | Verdict |
|---|---|---|
redis_mem_pct |
85 | capacité(%) ≥ → Dégradé (mem_saturation) |
redis_frag_ratio |
1.6 | fragmentation ≥ → Dégradé (fragmentation, seulement si used ≥ 64MB) |
redis_blocked |
1 | clients bloqués ≥ → Dégradé (blocked_clients) |
redis_stale_min |
5 | dernier échantillon plus ancien que N min → Hors service (stale) |
redis_hit_rate_min |
50 | affichage/interprétation seulement (non utilisé pour l’état) |
redis_reserve_pct |
20 | réserve système/autres (%) pour le calcul du libre estimé |
master_link_status=down(lien de réplique rompu) etrdb_last_bgsave_status=err(échec de sauvegarde RDB) sont également détectés comme motifs de Dégradé. Le détail du keyspace par base,total_system_memoryet les totaux de clés sont des colonnes d’extension du collecteur — avec un collecteur ancien, ces sections se masquent proprement (« affiché après redéploiement du collecteur »).
Accès
- Lecture (consulter l’écran Sessions) : domaine de rôle Service
min_req 1— tout utilisateur connecté (demo=1 et au-delà). L’écran est en lecture seule, il n’y a donc aucune barrière en écriture (ni connexion directe à Redis, ni commande d’écriture). - Modifier les seuils : ajustez les valeurs
redis_*dans Politique d’exploitation — administrateurlevel≥5(admin=10, contrôlé parinfr.level). - Enregistrer le collecteur : l’ajout de nœuds redis_host au collecteur redis_vts se fait dans Collecteurs avec
level≥5.
Dépannage et FAQ
Q. L’écran n’affiche que « Aucun nœud Redis collecté pour l’instant ».
R. infr_redis_metric est vide. Enregistrez des nœuds redis_host sur le collecteur redis_vts dans Administration ▸ Collecteurs, et déployez scripts/infr_redis_vts_collector.cjs sous pm2 sur l’hôte représentant. Le collecteur crée la table via CREATE TABLE IF NOT EXISTS et ingère chaque minute.
Q. Un nœud reste Hors service avec le motif stale.
R. Le dernier échantillon date de plus de 5 min (redis_stale_min) — le collecteur pm2 est mort (pm2 ls), ou l’accès réseau/redis-cli au nœud est bloqué. Vérifiez les journaux du collecteur.
Q. Les sections d’analyse keyspace/sessions et de plafond mémoire sont absentes.
R. Les colonnes total_system_memory, keyspace par base et les totaux de clés sont des extensions du collecteur. Avec un collecteur ancien, elles sont nulles et les sections se masquent — redéployez le collecteur le plus récent pour les faire apparaître.
Q. Le taux de succès est de 45 % — pourquoi n’est-ce pas Dégradé ? R. C’est voulu. Un magasin de sessions a normalement un faible taux de succès, aussi le taux de succès ne fait-il jamais passer un nœud en Dégradé. Les vrais problèmes (saturation mémoire, éviction, fragmentation) sont détectés sur des axes distincts.
Q. La fragmentation affiche 3,0 mais l’instance est minuscule.
R. Lorsque used_memory est inférieur à 64MB, la surcharge fixe fausse le ratio. InfraGuard exclut alors la fragmentation du score — considérez la valeur comme indicative. Sauf s’il s’agit d’un vrai swap (<1,0), il n’y a guère de quoi s’inquiéter.
Voir aussi
- Écran Sessions (Redis) — la console en direct qui applique ces concepts
- Supervision de la charge de la base de données — le moniteur de base de données qui suit la même narration (connexions, QPS, requêtes lentes)
- Concepts de réglage de base de données (formation) — verrous, cache et index côté base de données
- Politique d’exploitation — modifier les seuils
redis_*et le pourcentage de réserve - Collecteurs — le collecteur redis_vts et l’enregistrement des nœuds
- Vue d’ensemble des services — placer les cartes de session sur le tableau