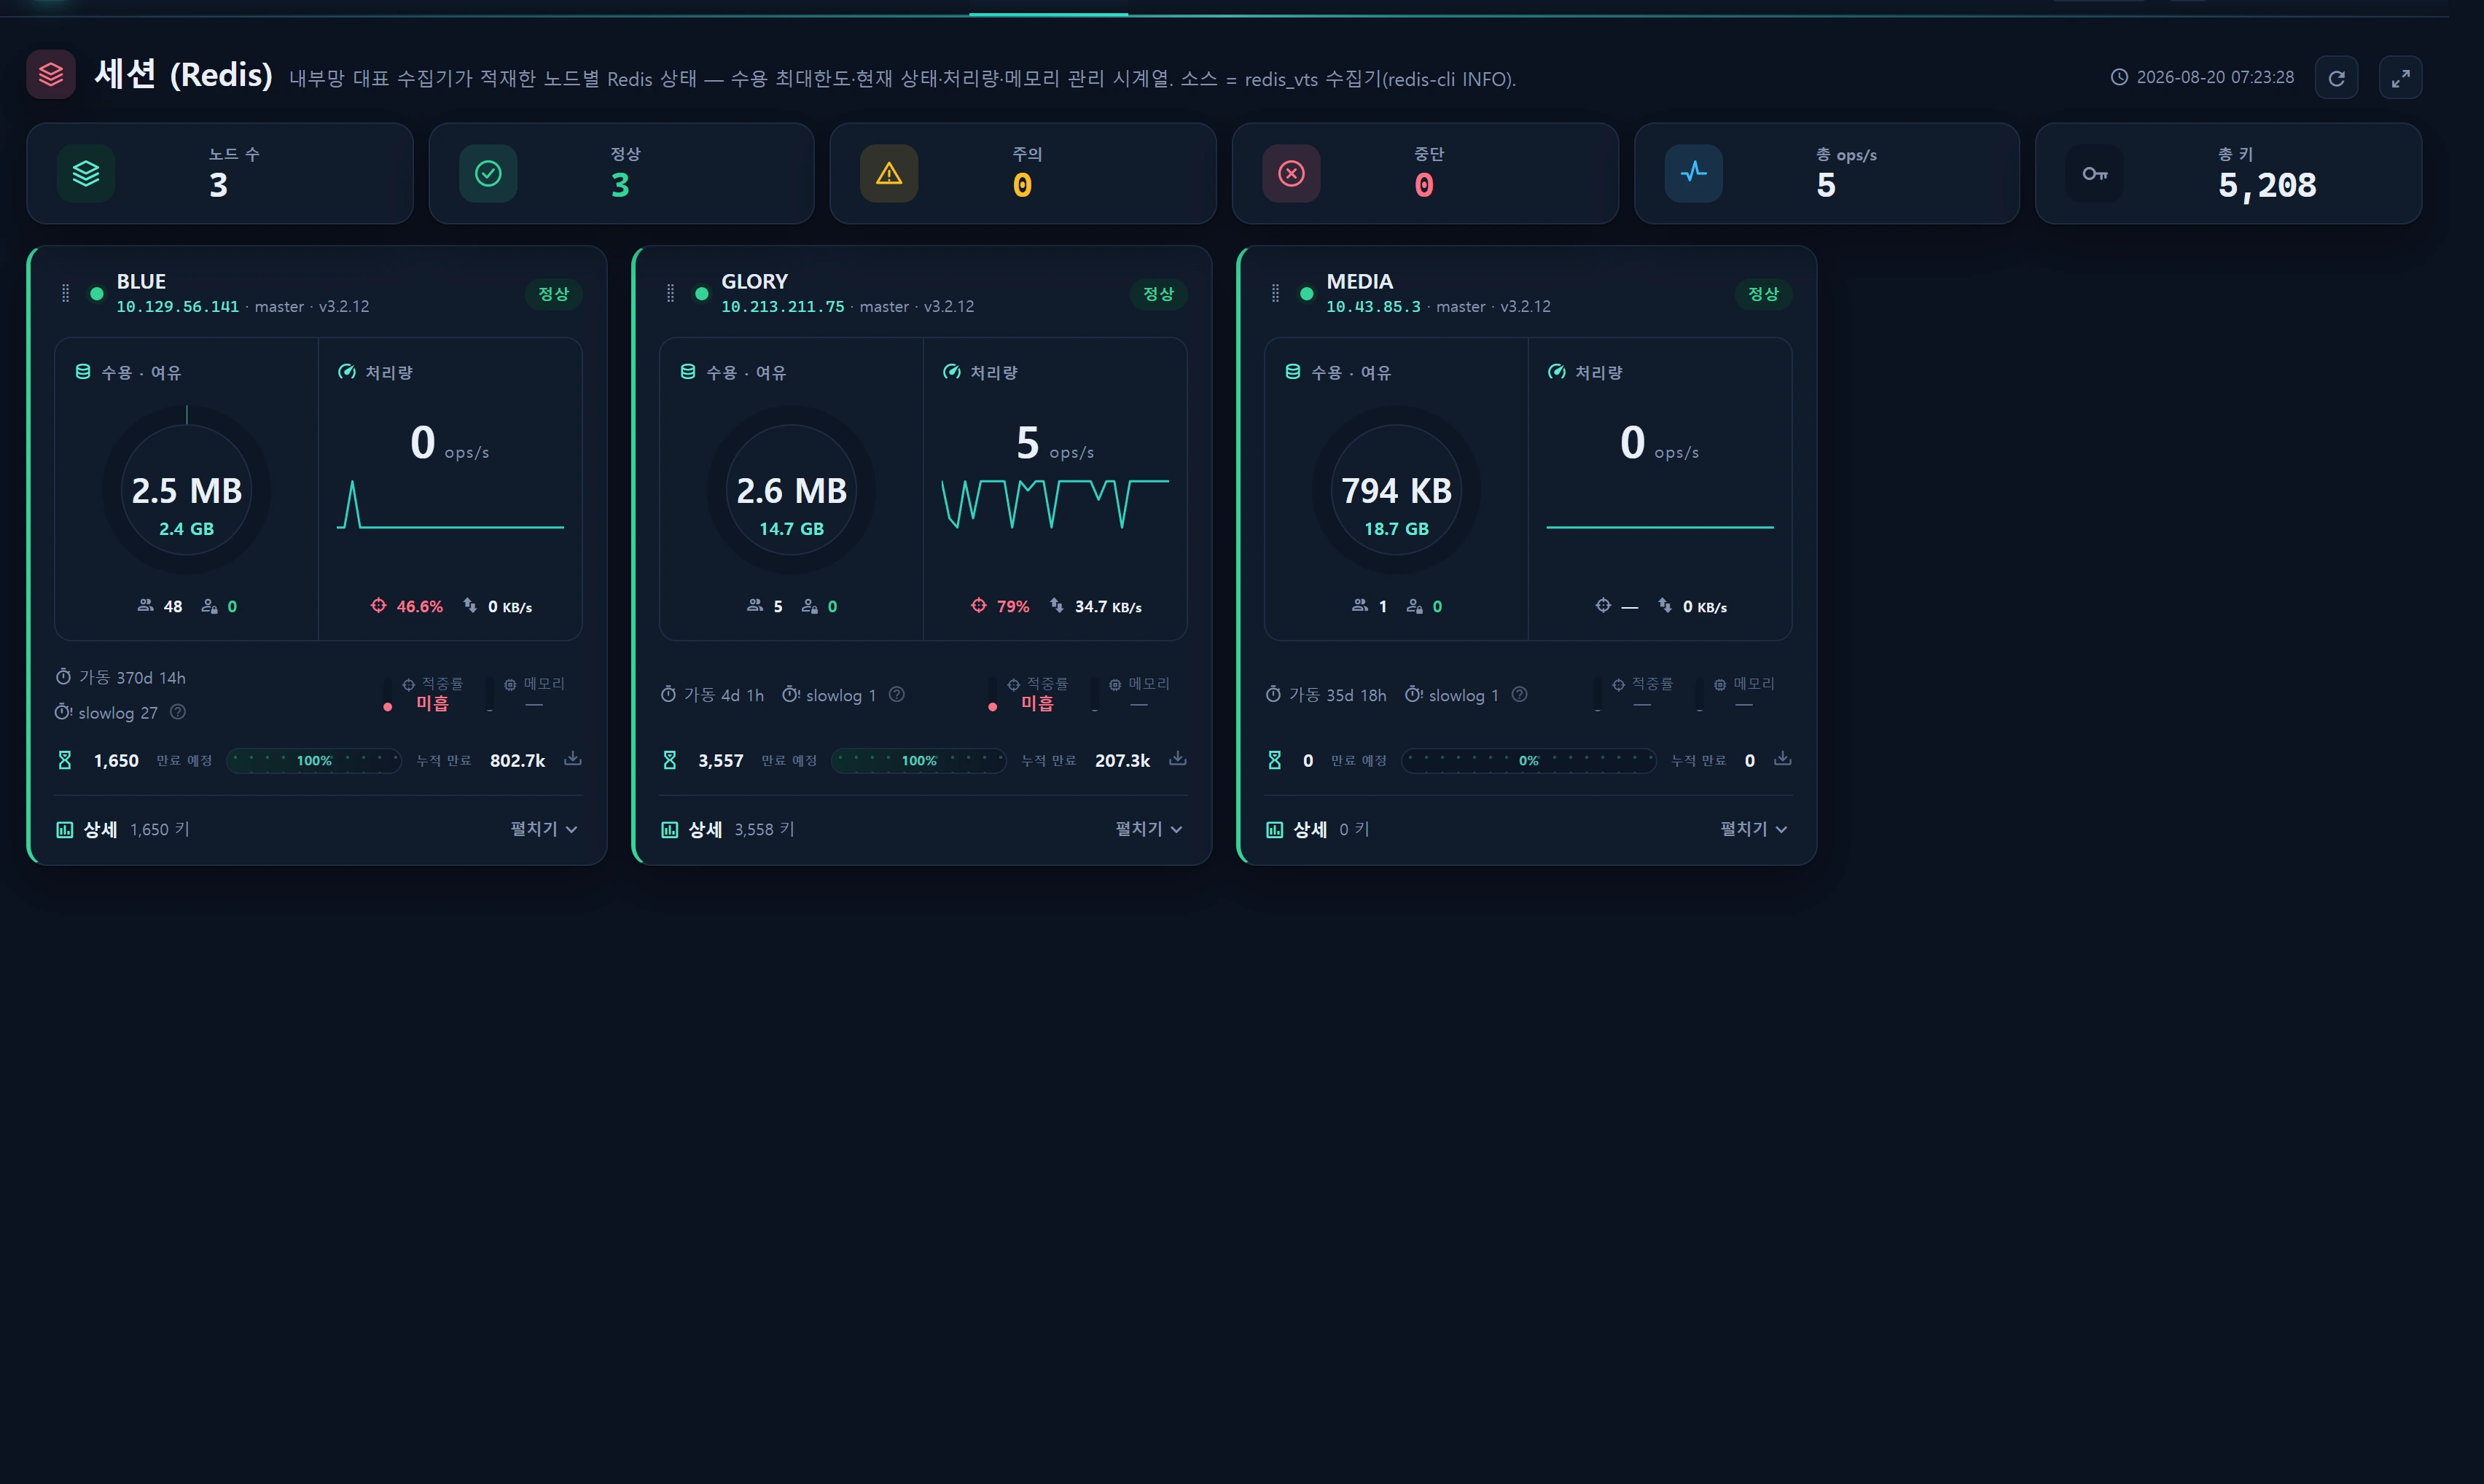
Resumen: qué hace
Este artículo enseña cómo leer y actuar sobre las métricas que se ven en la pantalla Servicio ▸ Sesiones (Redis) (/service/session). Esa pantalla es una consola de monitorización en vivo; esta página explica los conceptos de operación de Redis que hay detrás: slowlog, tasa de aciertos del keyspace, fragmentación de memoria y caducidad frente a expulsión.
InfraGuard nunca se conecta directamente a Redis. Un recolector representante de la red interna (scripts/infr_redis_vts_collector.cjs, ejecutado bajo pm2 como cron por minuto) toma una instantánea de redis-cli INFO de cada nodo y la escribe en la tabla central de MySQL infr_redis_metric; la aplicación solo lee esa tabla. Por tanto, todos los valores que se muestran aquí proceden de campos estándar de INFO.
El léxico exacto y los consejos de mejora de cada métrica residen, con fuente única, en los popovers formativos (al pasar el cursor) de la pantalla de Sesiones (
edu.*enresources/lang/{ko,en}/redis.php). Este artículo resume y conecta esos conceptos en lugar de redefinirlos: pase el cursor por los popovers en vivo para ver todo el detalle.
Cuándo usarlo
- Una tarjeta de sesión pasó a Degradado / Caído y usted quiere entender el código de motivo (
mem_saturation,fragmentation,blocked_clients,replica_link_down,rdb_save_failed,stale). - La tasa de aciertos parece baja pero el nodo parece correcto (para decidir si eso es normal en un almacén de sesiones).
- El ratio de fragmentación subió por encima de 1,5 o cayó por debajo de 1,0 y usted quiere causa y remedio.
- La expulsión empezó a subir por encima de 0 y teme perder sesiones.
- El slowlog no deja de crecer y hay que averiguar qué patrón de comandos corregir.
Disposición
Una tarjeta de sesión representa un nodo (node_alias = infr_instance.alias, 1:1) y hereda la narrativa de Servicio ▸ Base de datos.
| Zona | Qué muestra | Campos INFO de origen |
|---|---|---|
| ① Capacidad · Libre | Anillo de capacidad de memoria (usada / tope) · clientes (conectados/máx.) · bloqueados | used_memory, maxmemory, total_system_memory, connected_clients, maxclients, blocked_clients |
| ② Rendimiento | Minigráfico de ops/s · tasa de aciertos de la ventana reciente · E/S de red | instantaneous_ops_per_sec, keyspace_hits/misses, instantaneous_input/output_kbps |
| Eficiencia del pie | Calificación de la tasa de aciertos · calificación de memoria (fragmentación) | hit_rate, mem_fragmentation_ratio |
| Flujo de vida de la sesión | Por caducar (con TTL) → flujo → total caducadas | keyspace_expires, expired_keys |
| Detalle (plegable) | Serie temporal de gestión de memoria + superposición del techo de capacidad + marcas de episodios de expulsión · análisis de keyspace/sesiones | serie de used_memory, evicted_keys, INFO keyspace |
KPI superiores: número de nodos · Activos/Degradados/Caídos · ops/s totales · claves totales · suma de clientes.
Cómo se determina la capacidad (el techo)
La referencia del 100 % (presupuesto) para el anillo indicador y el gráfico de memoria se elige en este orden:
- Si
maxmemoryestá definido, ese es el techo duro (Redis lo impone). Libre estimada =maxmemory − used. - Si no está definido (ilimitado), presupuesto =
total RAM − DB buffer pool − OS/other reserve (%). La reserva es del 20 % por defecto (Política de operacionesredis_reserve_pct); el buffer pool de la base de datos se resta a partir del recolectoraccess=databasedel mismo nodo.
Un nodo con
maxmemory 0(ilimitado) muestra la nota «maxmemory sin definir: se muestra en relación con la RAM del SO/servidor». En una instancia dedicada a sesiones, defina unmaxmemoryexplícito (una fracción de la RAM del SO) para que la política de expulsión se comporte de forma predecible.
Cómo usarlo
1) slowlog: por qué crece (7 causas resumidas)
Redis es monohilo, así que un solo comando lento bloquea todo el servidor. slowlog_len es el recuento acumulado de comandos que superan slowlog-log-slower-than (10 ms por defecto). Las más frecuentes primero:
- Comandos O(N):
KEYS *,SMEMBERS,HGETALL,LRANGE 0 -1recorren colecciones enteras. La causa principal. - Operaciones sobre claves grandes: cadenas de varios MB o coste de serialización + transferencia de Hash/Set/ZSet grandes.
- Presión de memoria / swap: la asignación se atasca a medida que lo usado se acerca al tope.
- Latencia de fork por persistencia:
bgsavede RDB / reescritura de AOF,latest_fork_usec. - Scripts Lua/funciones pesados: un
EVALpesado bloquea mientras se ejecuta. - Pipelines grandes / MULTI: miles de comandos de golpe dejan el resto en cola.
- DEL de claves grandes: use
UNLINKasíncrono en lugar deDEL.
Confirme qué comandos se dispararon realmente, directamente en el nodo:
# Últimos 10 comandos lentos (redis-cli)
redis-cli SLOWLOG GET 10
# Umbral + número retenido (microsegundos · p. ej. 10 ms)
redis-cli CONFIG SET slowlog-log-slower-than 10000
redis-cli CONFIG SET slowlog-max-len 128
redis-cli SLOWLOG RESET
Nunca ejecute
KEYS *en producción: mientras recorre todo el keyspace, cualquier otro comando espera. Sustitúyalo por los iteradores con cursorSCAN/HSCAN/SSCAN/ZSCAN.
2) Tasa de aciertos del keyspace: que sea baja no es un defecto
Tasa de aciertos de la ventana reciente = Δkeyspace_hits / (Δhits + Δmisses). Cuando la muestra es escasa (denominador delta < 20) se recurre al hit_rate acumulado desde el arranque. Calificaciones: Excelente ≥99% · Bueno ≥95% · Aceptable ≥80%.
La tasa de aciertos NO es un eje de estado que ponga un nodo en rojo. Un almacén de sesiones tiene por naturaleza pocos aciertos: cada nuevo inicio de sesión, cada caducidad y cada cierre de sesión es un fallo, de modo que entre el 40 y el 60 % es normal (por ejemplo,
bluecon un 44,75 % es un nodo de sesiones perfectamente sano). Por eso, aunque existe un umbralredis_hit_rate_min(50 por defecto), no se utiliza para el estado: solo se muestra a efectos de interpretación. Los problemas reales de caché se detectan, con independencia de la carga de trabajo, mediante la saturación de memoria, la expulsión y la fragmentación que se describen más abajo.
Para subir de verdad la tasa de aciertos: mantenga el conjunto de trabajo residente (margen de RAM/maxmemory), dimensione bien los TTL, mitigue la estampida de caché (TTL con jitter) y precaliente los prefijos con muchos fallos. Consulte el popover de aciertos en vivo para más detalle.
3) Fragmentación de memoria: franja sana de 1,0 a 1,5
mem_fragmentation_ratio = used_memory_rss / used_memory: la memoria física que el SO dio a Redis frente a la que Redis usa realmente.
| Ratio | Significado | Acción |
|---|---|---|
| 1.0 – 1.5 | Franja sana | Normal |
| > 1.5 | Fragmentada (RAM desperdiciada) | activedefrag yes (necesita jemalloc), reducir la creación/borrado frecuente de valores grandes |
| < 1.0 | Haciendo swap (peligro) | Inmediatamente añadir RAM o bajar maxmemory para detener el swap: señal de ralentización brusca |
Calificaciones: Excelente 0,95–1,4 · Bueno ~1,6 · Aceptable ~2,5. El umbral de estado redis_frag_ratio es 1,6 por defecto.
En una instancia pequeña donde
used_memoryestá por debajo de 64MB, la sobrecarga fija domina el ratio y la cifra de fragmentación se convierte en un falso positivo. En ese caso InfraGuard excluye la fragmentación de la puntuación (frag_score = null): sigue mostrando el valor, pero no pone el nodo en rojo.
4) Caducidad frente a expulsión: el corazón de la vida de la sesión
| Término | Significado | Señal |
|---|---|---|
| Caducadas (expired_keys) | TTL transcurrido, eliminación natural = vida normal de la sesión | Rotación · normalmente normal |
| Expulsadas (evicted_keys) | Eliminación forzada al llegar a maxmemory según la política |
Presión de memoria · riesgo de pérdida de sesiones |
En un almacén de sesiones, la caducidad es normal, pero una expulsión sostenida por encima de 0 significa que se están descartando sesiones vivas. Responda así:
- Tasa de expulsión > 0 → añadir RAM / subir
maxmemory. - Revise la política:
allkeys-lrutambién expulsa sesiones;volatile-*solo expulsa claves con TTL. - Si
rejected_connectionssube a la vez, ha alcanzadomaxclientsy el límite de memoria al mismo tiempo.
# Consultar / cambiar la política de expulsión
redis-cli CONFIG GET maxmemory-policy
redis-cli CONFIG SET maxmemory-policy volatile-lru
# Desfragmentación en línea (para fragmentación > 1.5 · necesita jemalloc)
redis-cli CONFIG SET activedefrag yes
El gráfico de gestión de memoria del detalle superpone una línea del techo de capacidad al 100 % sobre used_pct y marca los episodios de expulsión con chinchetas crit, de modo que puede rastrear visualmente cuándo el nodo tocó el techo y descartó sesiones.
5) Leer las bases de datos lógicas (keyspace)
INFO keyspace informa del número de claves de espacios de claves numerados e independientes (bases de datos lógicas, 16 por defecto, índices 0–15).
# INFO keyspace example
db0:keys=48213,expires=48213,avg_ttl=1680000
db1:keys=126,expires=0,avg_ttl=0
La base de datos con más claves es el almacén de sesiones principal y, si en esa base de datos keys = expires (todas con TTL), se trata de un almacén de sesiones puro (las claves caducan de forma natural). Arriba, db0 se lee como sesiones (todas con TTL) y db1 como otro uso (caché/bloqueos).
Fuentes de datos
| Elemento | Valor |
|---|---|
| Tabla de origen | infr_redis_metric (MySQL central · modelo de solo lectura, $timestamps=false) |
| Recolector que la alimenta | scripts/infr_redis_vts_collector.cjs (pm2, cada minuto): redis-cli INFO |
| Aprovisionamiento | El recolector la crea por sí mismo con CREATE TABLE IF NOT EXISTS (sin migración) |
| Clave de unión | instance_id (primero la FK entera) → alternativa node_alias ↔ infr_instance.alias |
| Constructor | App\Services\Redis\RedisMetricService (una sola consulta por lotes · caché de 20 s) |
| Ventana reciente | 30 min (WINDOW_MIN) · hasta 60 puntos de gráfico · sondeo cada 30 s (/service/session/live) |
| SOT de umbrales | App\Support\OpsPolicy::redisThresholds() |
Umbrales de estado (Política de operaciones infr_setting group=ops):
| Clave | Predeterminado | Veredicto |
|---|---|---|
redis_mem_pct |
85 | capacidad(%) ≥ → Degradado (mem_saturation) |
redis_frag_ratio |
1.6 | fragmentación ≥ → Degradado (fragmentation, solo cuando used ≥ 64MB) |
redis_blocked |
1 | clientes bloqueados ≥ → Degradado (blocked_clients) |
redis_stale_min |
5 | última muestra con más de N min → Caído (stale) |
redis_hit_rate_min |
50 | solo visualización/interpretación (no se usa para el estado) |
redis_reserve_pct |
20 | reserva del SO/otros (%) para el cálculo de la memoria libre estimada |
master_link_status=down(enlace de réplica caído) yrdb_last_bgsave_status=err(fallo al guardar el RDB) también se detectan como motivos de Degradado. El detalle de keyspace por base de datos,total_system_memoryy los totales de claves son columnas de extensión del recolector: con un recolector antiguo esas secciones se ocultan sin más («se muestra tras redesplegar el recolector»).
Acceso
- Lectura (ver la pantalla de Sesiones): área de rol Servicio
min_req 1: cualquier usuario autenticado (demo=1 en adelante). La pantalla es de solo lectura, así que no hay barrera de escritura (no hay conexión directa a Redis ni comandos de escritura). - Editar umbrales: ajuste los valores
redis_*en Política de operaciones: administradorlevel≥5(admin=10, controlado porinfr.level). - Registrar el recolector: añadir nodos redis_host al recolector redis_vts se hace en Recolectores con
level≥5.
Resolución de problemas y preguntas frecuentes
P. Solo muestra «Todavía no se ha recolectado ningún nodo de Redis».
R. infr_redis_metric está vacía. Registre nodos redis_host en el recolector redis_vts en Administración ▸ Recolectores y despliegue scripts/infr_redis_vts_collector.cjs bajo pm2 en el host representante. El recolector crea la tabla con CREATE TABLE IF NOT EXISTS e ingiere cada minuto.
P. Un nodo sigue Caído con el motivo stale.
R. La última muestra tiene más de 5 min (redis_stale_min): el recolector de pm2 ha muerto (pm2 ls), o el acceso de red/redis-cli al nodo está bloqueado. Revise los registros del recolector.
P. Faltan las secciones de análisis de keyspace/sesiones y de techo de memoria.
R. Las columnas total_system_memory, keyspace por base de datos y los totales de claves son extensiones del recolector. Con un recolector antiguo son nulas, así que las secciones se ocultan: redespliegue el recolector más reciente para que aparezcan.
P. La tasa de aciertos es del 45 %, ¿por qué no está Degradado? R. Es intencionado. Un almacén de sesiones tiene normalmente pocos aciertos, así que la tasa de aciertos nunca marca un nodo como Degradado. Los problemas reales (saturación de memoria, expulsión, fragmentación) se detectan en ejes distintos.
P. La fragmentación muestra 3,0 pero la instancia es diminuta.
R. Cuando used_memory está por debajo de 64MB, la sobrecarga fija distorsiona el ratio. InfraGuard excluye en ese caso la fragmentación de la puntuación: trate el valor como informativo. Salvo que sea swap real (<1,0), hay poco de lo que preocuparse.
Relacionado
- Pantalla de Sesiones (Redis): la consola en vivo que aplica estos conceptos
- Monitorización de carga de la base de datos: el monitor de base de datos que sigue la misma narrativa (conexiones, QPS, consultas lentas)
- Conceptos de ajuste de base de datos (formación): bloqueos, caché e índices en el lado de la base de datos
- Política de operaciones: editar los umbrales
redis_*y el porcentaje de reserva - Recolectores: el recolector redis_vts y el registro de nodos
- Resumen de servicios: componer las tarjetas de sesión en el panel