Vue d’ensemble — ce que fait cet écran
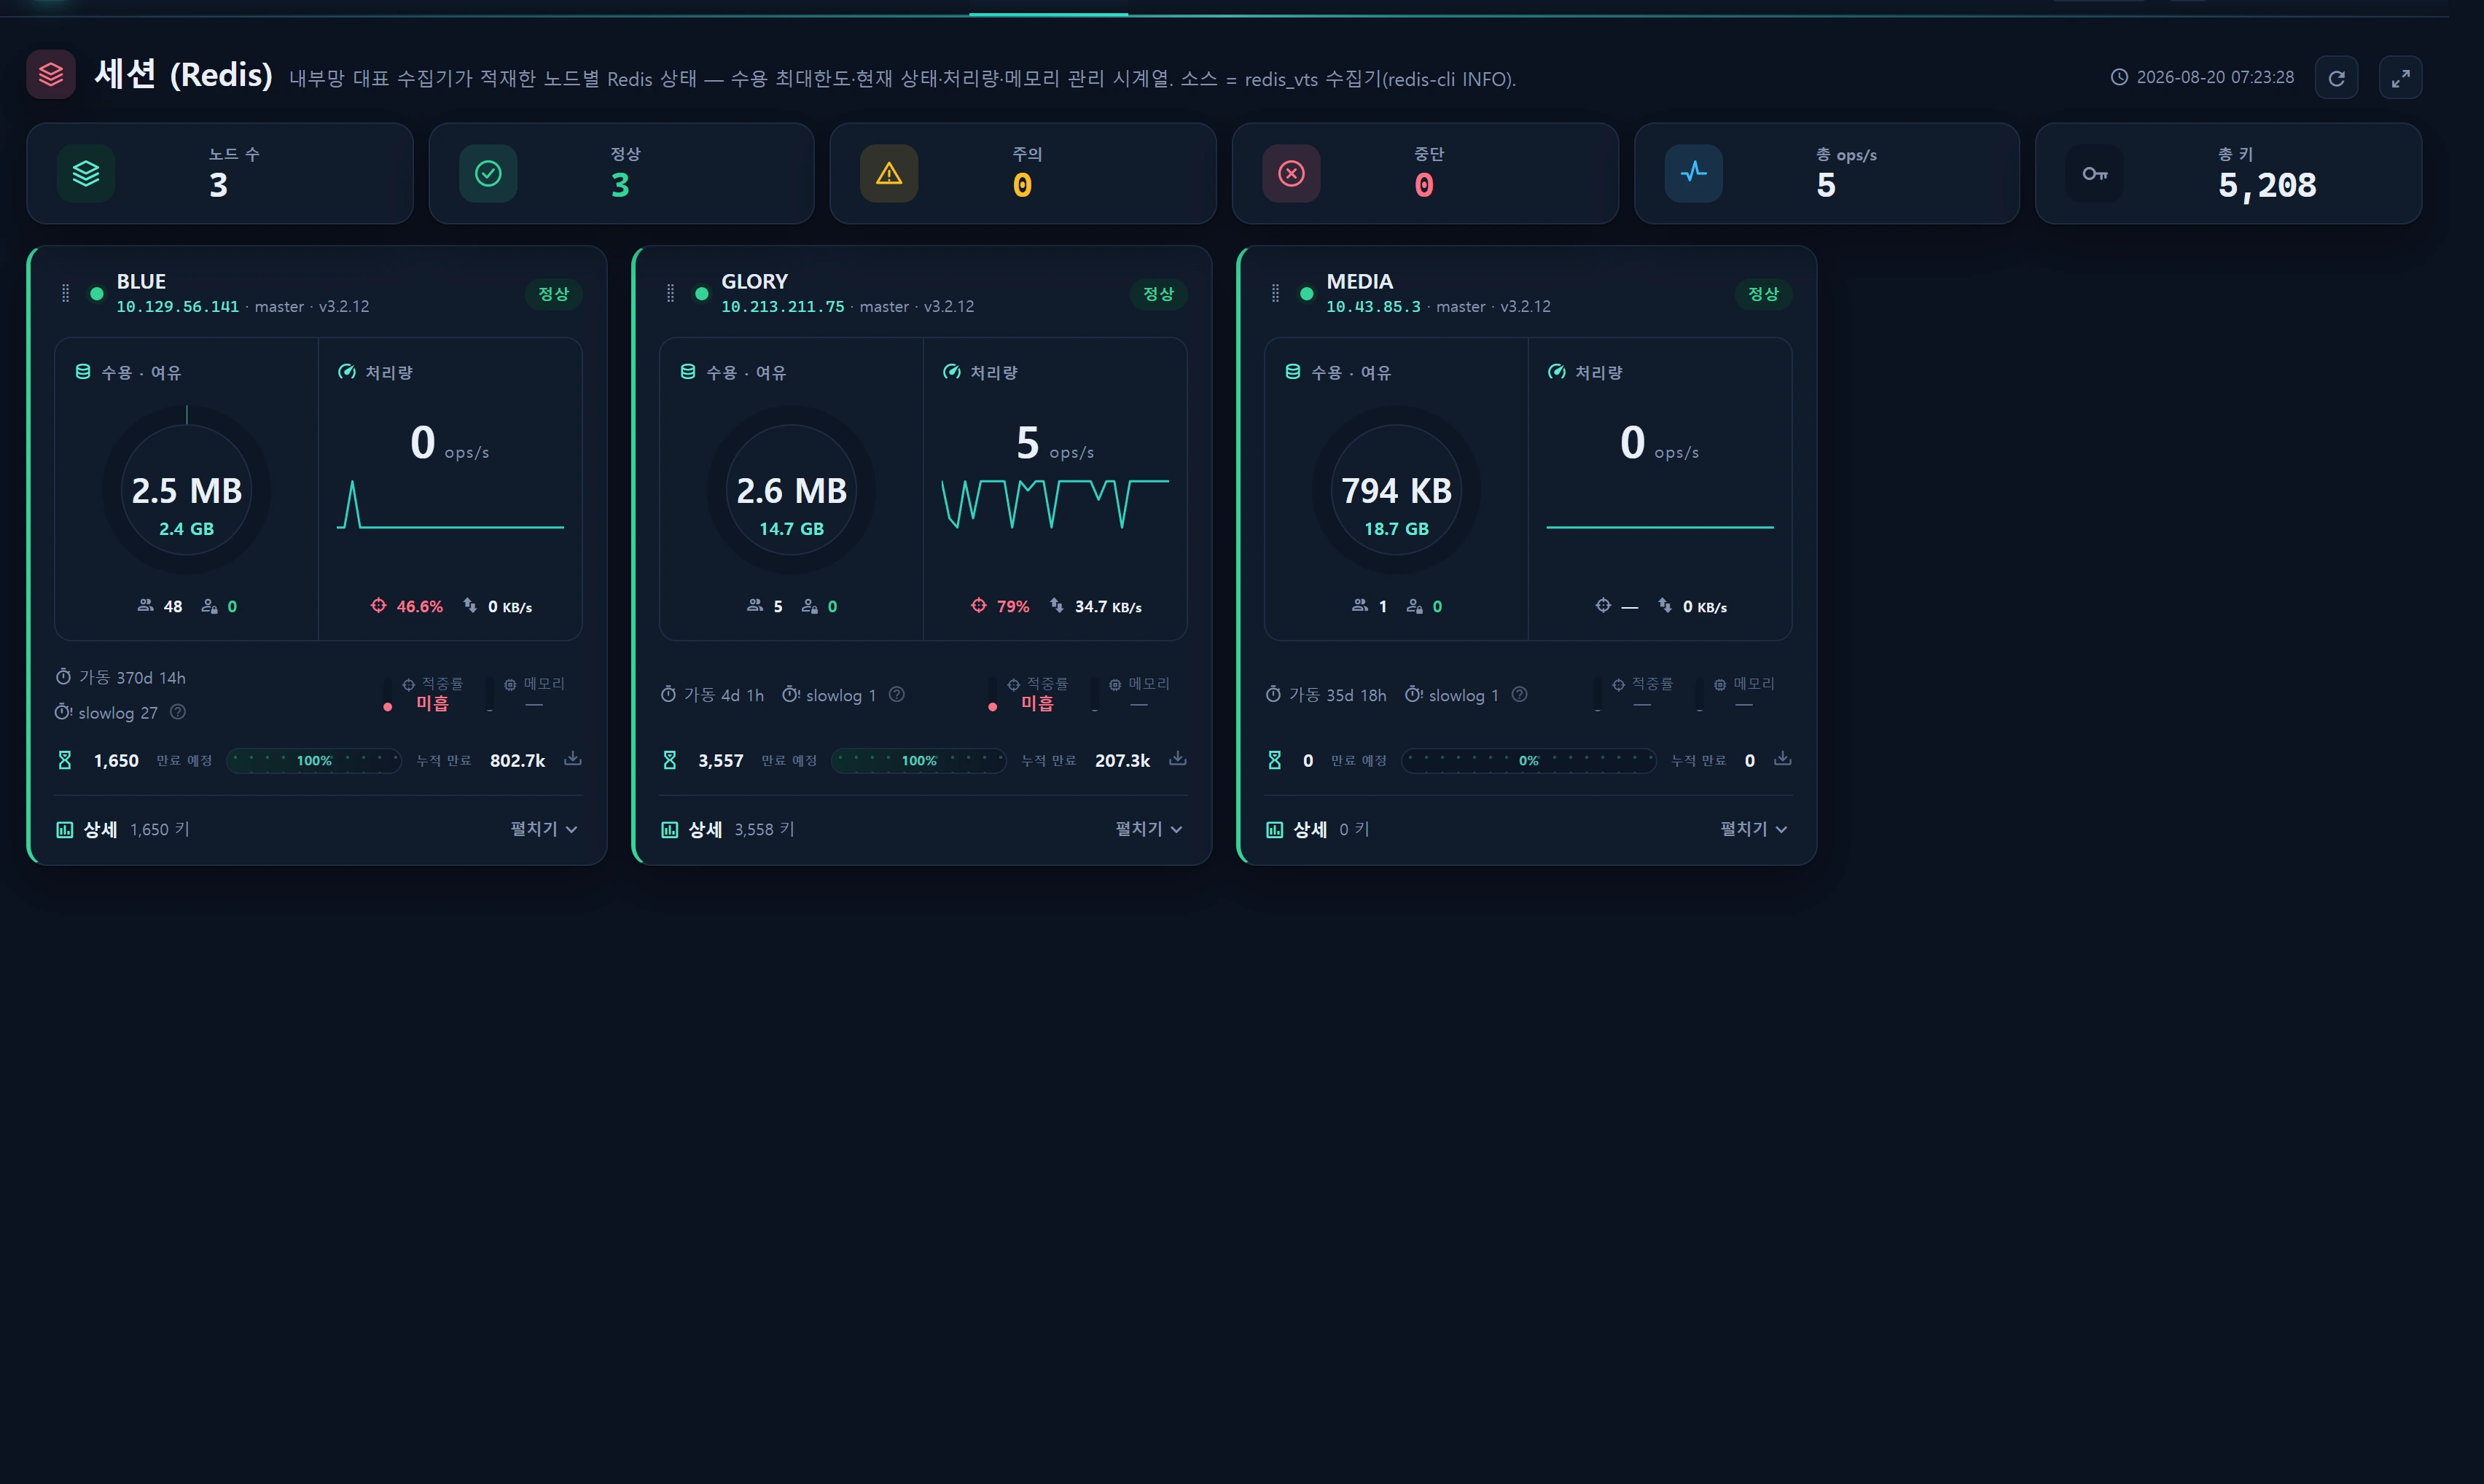
Service ▸ Sessions (Redis) surveille sur un seul écran la santé du magasin de sessions et de cache de vos nœuds Redis enregistrés. Il transpose sur Redis le récit de Service ▸ Base de données, en lisant selon deux axes :
- Plafond de capacité et état actuel — une jauge annulaire de saturation mémoire (
used_memory÷ plafond de capacité), les connexions clientes (connected / maxclients) et les clients bloqués. - Débit — les opérations par seconde (
instantaneous_ops_per_sec), le taux de succès sur la fenêtre récente (Δhits / Δ(hits+misses)) et les E/S réseau (entrée/sortie en kbps).
Un panneau de détail repliable ajoute une série temporelle de gestion mémoire (superposition du plafond de capacité et repères des épisodes d’éviction) ainsi que l’analyse de l’espace de clés et des sessions.
Cet écran ne se connecte jamais directement à Redis. Un collecteur représentatif du réseau interne (
scripts/infr_redis_vts_collector.cjs, un cron pm2 exécuté chaque minute) lanceredis-cli INFOsur chaque nœud et charge les instantanés dans la table MySQL centraleinfr_redis_metric; l’application se contente de la lire. L’application ne détient aucun identifiant Redis et n’exécute aucun démon résident (ce qui évite les pièges des fuites de connexions et des identifiants codés en dur).
Quand l’utiliser
- Capacité du magasin de sessions — repérez une mémoire Redis proche du plafond, là où les sessions sont évincées (perdues) sous la pression.
- Diagnostic d’efficacité du cache — jugez si le cache remplit son rôle grâce au taux de succès, à la fragmentation et au slowlog.
- Saturation des connexions — agissez avant que de nouvelles connexions soient refusées, lorsque
connected_clientsapproche demaxclientsou querejected_connectionsgrimpe. - Défauts de persistance ou de réplication — visualisez sous forme de badges l’échec du bgsave RDB, la réécriture AOF ou la rupture du lien avec la réplique.
- Durée de vie des sessions — distinguez l’expiration (durée de vie normale) de l’éviction (pression mémoire) pour interpréter la rotation des sessions.
Disposition
Indicateurs du haut
| KPI | Signification |
|---|---|
| Nœuds | Cartes de nœuds Redis disposant d’un échantillon dans la fenêtre récente (30 min) |
| Actifs / Dégradés / Hors service | Nombre de nœuds up / degraded / down |
| Total ops/s | Somme de instantaneous_ops_per_sec sur l’ensemble des nœuds |
| Clés totales | Somme de keyspace_keys sur l’ensemble des nœuds |
Cartes de nœud (deux axes)
Chaque nœud correspond à une carte. L’en-tête affiche le nom ou l’alias de l’instance, la version de Redis et le rôle (master/replica) ; le corps porte les deux axes.
① Capacité · Libre (jauge annulaire de gauche) — la valeur centrale est used_pct (utilisé ÷ plafond de capacité). Bandeau de métriques :
| Métrique | Champ | Remarques |
|---|---|---|
| Clients | connected_clients / maxclients |
Connexions face à la limite ; près de la limite, les nouvelles connexions sont refusées |
| Bloqués | blocked_clients |
Clients en attente sur BLPOP·BRPOP·WAIT (0 est sain) |
② Débit (à droite) — sparkline et bandeau :
| Métrique | Champ | Remarques |
|---|---|---|
| ops/s | instantaneous_ops_per_sec |
Commandes traitées par seconde |
| Taux de succès | Δhits / Δ(hits+misses) | Taux de succès du cache sur la fenêtre récente (repli sur la valeur depuis le démarrage quand les échantillons sont rares) |
| E/S réseau | instantaneous_input_kbps + output_kbps |
Entrée/sortie réseau par seconde |
Scores d’efficacité (pied de carte)
- Niveau du taux de succès — Excellent ≥ 99 % · Bon ≥ 95 % · Correct ≥ 80 %.
- Niveau de l’efficacité mémoire (fragmentation) — Excellent 0,95–1,4 · Bon ~1,6 · Correct ~2,5.
Le score de fragmentation (
frag_score) n’est calculé que lorsqueused_memoryatteint au moins 64 MB. Sur les petites instances, la surcharge fixe de l’allocateur domine le rapport et produit de fausses alertes ; en dessous de ce seuil, il est donc exclu à la fois du score et du statut.
Bandeau du flux de vie des sessions
Un bandeau pleine largeur en pied de carte représente avec expiration → flux → expirées cumulées. À gauche, les clés qui portent actuellement un TTL vivant (keyspace_expires, sur le point d’expirer naturellement) ; à droite, les clés expirées depuis le démarrage (expired_keys, la rotation des sessions). Un remplissage proche de ≈100 % signale un pur magasin de sessions.
Détail (dépliage)
Deux blocs s’ouvrent de façon repliable (la mise en page masonry se réorganise lorsque la hauteur change).
- Gestion mémoire — série temporelle de
usedface à la capacité, avec une superposition de la ligne de coupe à 100 % du plafond de capacité et des repères critiques des épisodes d’éviction. La carte énumère le plafond de capacité (cap), l’espace libre estimé (est_free), la RAM totale, la réserve de la base de données, la réserve du système d’exploitation, le pic, le RSS, la fragmentation, les évictions et expirations cumulées ainsi que la politique d’éviction. - Espace de clés · sessions — clés totales, clés porteuses d’un TTL, barres de répartition par base logique (db0/db1…), la base de sessions mise en évidence, le TTL moyen et les badges de persistance RDB/AOF/réplique.
Bulles pédagogiques (edu)
Le survol de l’icône située à côté d’une métrique ouvre une bulle conçue pour expliquer causes et remèdes (les concepts plus poussés se trouvent dans Le réglage de Redis expliqué) :
| Bulle | Contenu |
|---|---|
| SLOWLOG | 7 causes d’accumulation de commandes lentes (commandes O(N) · grosses clés · pression mémoire · blocages de fork · Lua · pipelines · DEL massifs) |
| Taux de succès | Base du ratio de succès du keyspace et moyens de l’améliorer (garder le jeu de travail résident · ajuster le TTL · atténuer les ruées) |
| Fragmentation | Plage saine de RSS / used (1,0–1,5) · activedefrag · avertissement de swap (< 1,0) |
| Bases logiques | Concept des bases numérotées de Redis (0–15) · séparation par usage · portabilité vers Cluster |
| Expiration · éviction | Expiration (durée de vie normale) face à l’éviction (pression mémoire) · comment les lire |
Comment l’utiliser
- Interrogation périodique — après le chargement, la page interroge
/service/session/livetoutes les 30 secondes pour rafraîchir les indicateurs et les cartes (le serveur met le tableau de bord en cache pendant 20 secondes). - Réordonner les cartes — faites glisser les cartes pour les classer par priorité (SortableJS ; l’ordre est conservé dans localStorage).
- Déplier le détail — utilisez le bouton [Déplier] de la carte pour ouvrir les blocs de gestion mémoire et d’espace de clés.
- Apprendre avec edu — survolez l’icône d’une métrique pour afficher la bulle cause/remède.
- Plein écran — le bouton plein écran situé à côté de l’indicateur LIVE de l’en-tête masque la navigation supérieure et bascule en mode tableau de bord (ESC pour quitter).
Si aucune carte n’apparaît, c’est qu’aucun nœud Redis n’a encore été enregistré ni collecté. Dans Administration ▸ Collecteurs, enregistrez les nœuds
redis_hostsur le collecteurredis_vts, puis déployez le collecteur avec pm2 sur l’hôte représentatif.
Sources de données
Modèle en lecture seule infr_redis_metric
L’application mappe cette table comme un modèle en lecture seule de style Legacy (App\Models\Infr\InfrRedisMetric, $timestamps=false). Aucune migration n’existe pour elle, et c’est délibéré : le collecteur la provisionne lui-même avec CREATE TABLE IF NOT EXISTS, si bien qu’un Schema::create côté application entrerait en conflit.
Discipline du constructeur App\Services\Redis\RedisMetricService::dashboard() :
- Il interroge la fenêtre récente de 30 minutes (
WINDOW_MIN) en une seule requête par lot, puis regroupe parnode_alias(une carte par nœud). Si la fenêtre ne contient aucun échantillon (collecte interrompue), il récupère au moins les 180 dernières lignes afin d’exposer les nœuds commestale. - Les séries temporelles sont tronquées aux 60 derniers points par carte (
SERIES_MAX). Les compteurs cumulés (evicted/expired) sont convertis en taux par différence entre échantillons voisins ; en cas de remise à zéro (une baisse), le taux vautnull. - Le résultat du tableau de bord est mis en cache 20 secondes (
infr:redism:dash:v1).
-- Conceptuel (en réalité du Eloquent). Récupérer la fenêtre récente par lot, regrouper en PHP.
SELECT * FROM infr_redis_metric
 WHERE sampled_at >= (NOW() - INTERVAL 30 MINUTE)
 ORDER BY sampled_at;
Collecteur — scripts/infr_redis_vts_collector.cjs
Un unique hôte représentatif du réseau interne s’exécute via un cron pm2 : à chaque passage, il balaie le Redis de plusieurs nœuds (redis-cli -h {ip} INFO) ainsi que le vts de nginx, charge directement les données dans le MySQL central, puis se termine (non résident → un processus neuf à chaque exécution, sans fuite). La configuration ne réside que dans le bloc CONFIG en tête de fichier (pas de variables d’environnement, pas d’identifiants codés en dur).
# Déploiement sur l’hôte représentatif (balayage chaque minute, non résident)
npm i mysql2                 # la seule dépendance npm (pour le chargement). Installez redis-cli via le paquet du système.
pm2 start infr_redis_vts_collector.cjs --name infr-collector \
  --no-autorestart --cron-restart "* * * * *"
pm2 save
Jointure d’instance (alias / clé étrangère entière)
À l’écriture, le collecteur résout l’alias du nœud en identifiant dans infr_instance et écrit directement un instance_id (entier). L’application joint en priorité sur metric.instance_id = infr_instance.id (comparaison d’entiers — indépendante du classement et indexée par clé primaire). Les instances non enregistrées ou enregistrées tardivement basculent sur node_alias (en minuscules) → infr_instance.alias, et le remplissage différé infr:link-metrics (contrôlé par le leader, toutes les 5 minutes) complète ensuite instance_id.
Calcul du plafond de capacité (cap)
La référence des 100 % de la jauge annulaire et du graphique mémoire est résolue dans cet ordre.
| Type de cap | Condition | Plafond | Espace libre estimé (est_free) |
|---|---|---|---|
maxmemory |
maxmemory > 0 |
La valeur configurée de maxmemory (plafond dur) | maxmemory − used |
budget |
maxmemory non défini | RAM totale − buffer pool de la base − réserve du système | budget − used |
- RAM totale =
total_system_memory(collecté), avec repli surinfr_instance.mem_mb. - Réserve du système = RAM totale ×
redis_reserve_pct(20 % par défaut). - Buffer pool de la base = le
infr_db_metric.raw.bp_sizele plus récent du collecteuraccess=databasedu même nœud (additionné si un nœud héberge plusieurs bases). Le soustraire donne le budget que Redis peut réalistement utiliser comme plafond. - Le budget est plancher : il ne descend jamais sous le
usedcourant, ce qui évite les valeurs négatives ou inversées.
Détermination du statut et seuils
statusOf() classe chaque nœud comme up / degraded / down.
| Statut | Condition |
|---|---|
down |
Échec de la collecte (ok=0) ou état stale (dernier échantillon plus ancien que redis_stale_min) |
degraded |
Une ou plusieurs des raisons ci-dessous |
up |
Aucune raison |
Raisons et seuils de degraded (Administration ▸ Politique d’exploitation, infr_setting group=ops) :
| Raison | Condition | Clé de seuil | Valeur par défaut |
|---|---|---|---|
| Saturation mémoire | used_pct ≥ |
redis_mem_pct |
85 |
| Fragmentation | frag_score ≥ |
redis_frag_ratio |
1.6 |
| Clients bloqués | blocked_clients ≥ |
redis_blocked |
1 |
| Lien de réplique rompu | master_link_status = down |
— | — |
| Échec de sauvegarde RDB | rdb_last_bgsave_status = err |
— | — |
Le taux de succès n’est PAS un axe de statut. Un magasin de sessions manque sa cible à chaque nouvelle connexion, à chaque expiration et à chaque déconnexion : un taux de succès de 40 à 60 % est donc normal (par exemple 44,75 % sur un nœud de sessions parfaitement sain). Auparavant, un taux de succès inférieur à
redis_hit_rate_min(50 par défaut) produisait undegradedrouge injustifié ; désormais le taux de succès est uniquement affiché sur l’indicateur de la carte, la jauge de niveau et la bulle edu, et ne colore jamais un nœud en rouge. Les vrais problèmes de cache (saturation mémoire, éviction, fragmentation) sont détectés parmem_saturation/fragmentationquelle que soit la charge de travail.
Accès
- Lecture (cet écran) —
user_level ≥ 1(demo=1). Le domaine de rôle Service exige un niveau minimal de 1, et cet écran est en lecture seule (aucune action d’écriture ni de suppression). - Enregistrement/édition des collecteurs — Administration ▸ Collecteurs exige
user_level ≥ 5(staff/admin) pour enregistrer des nœudsredis_hostet des mots de passe sur le collecteurredis_vts. - Modification des seuils — Administration ▸ Politique d’exploitation exige
user_level ≥ 5.
Cet écran n’a aucune action destructrice : il n’écrit donc pas de journal d’audit propre (les modifications de collecteurs et de politique sont auditées sur leurs écrans d’administration respectifs).
Dépannage et FAQ
Aucune carte n’apparaît (« Aucun nœud Redis collecté »)
infr_redis_metric ne contient aucun échantillon récent. Vérifiez que (1) vous avez enregistré des nœuds redis_host sur le collecteur redis_vts dans Administration ▸ Collecteurs, (2) infr_redis_vts_collector.cjs tourne bien sous pm2 sur l’hôte représentatif et (3) l’hôte représentatif atteint le port Redis de chaque nœud via redis-cli.
Un nœud affiche « Hors service (stale) »
Le dernier échantillon est plus ancien que redis_stale_min (5 min par défaut). Le processus pm2 du collecteur représentatif est probablement mort, ou son cron s’est arrêté. Inspectez avec pm2 list / pm2 logs infr-collector.
Le plafond de la jauge annulaire paraît faux / l’espace libre semble énorme
Les nœuds sans maxmemory utilisent un budget comme plafond (RAM totale − buffer pool de la base − 20 % de réserve système). Pour un plafond dur, définissez maxmemory sur Redis : cette valeur devient alors directement le plafond.
Le bloc espace de clés / sessions est vide
Le détail par base (raw.keyspace) et les métriques de la base de sessions sont alimentés par le collecteur étendu. Avec un collecteur ancien, redéployez-le (ce qui ajoute de façon idempotente total_system_memory, keyspace_keys et les colonnes raw par base) et le bloc apparaîtra. Si rien n’est collecté, la section se masque proprement.
Le taux de succès est faible — est-ce un problème ?
Pour une charge de sessions, non (voir l’avertissement ci-dessus). S’il s’agit d’un pur cache et que le taux de succès est faible, le jeu de travail n’est peut-être pas résident ou le TTL est trop court — voyez le sujet consacré au taux de succès dans Le réglage de Redis expliqué.
Le score de fragmentation ne s’affiche pas
Lorsque used_memory est inférieur à 64 MB, le rapport de fragmentation est dominé par la surcharge fixe et n’a plus de sens : il est donc exclu du score et du statut.
Voir aussi
- Base de données (Service ▸ Base de données) — l’écran jumeau qui met en œuvre le même récit (capacité · débit · schéma) pour MySQL
- Le réglage de Redis expliqué — approfondissement sur le slowlog, le taux de succès, la fragmentation, l’espace de clés et l’éviction
- Collecteurs (Administration ▸ Collecteurs) — enregistrez le collecteur
redis_vtset ses nœuds - Politique d’exploitation (Administration ▸ Politique d’exploitation) — définissez les seuils de statut Redis et le pourcentage de réserve
- Vue d’ensemble des services (Service ▸ Vue d’ensemble) — épinglez des cartes de session sur le tableau de priorités