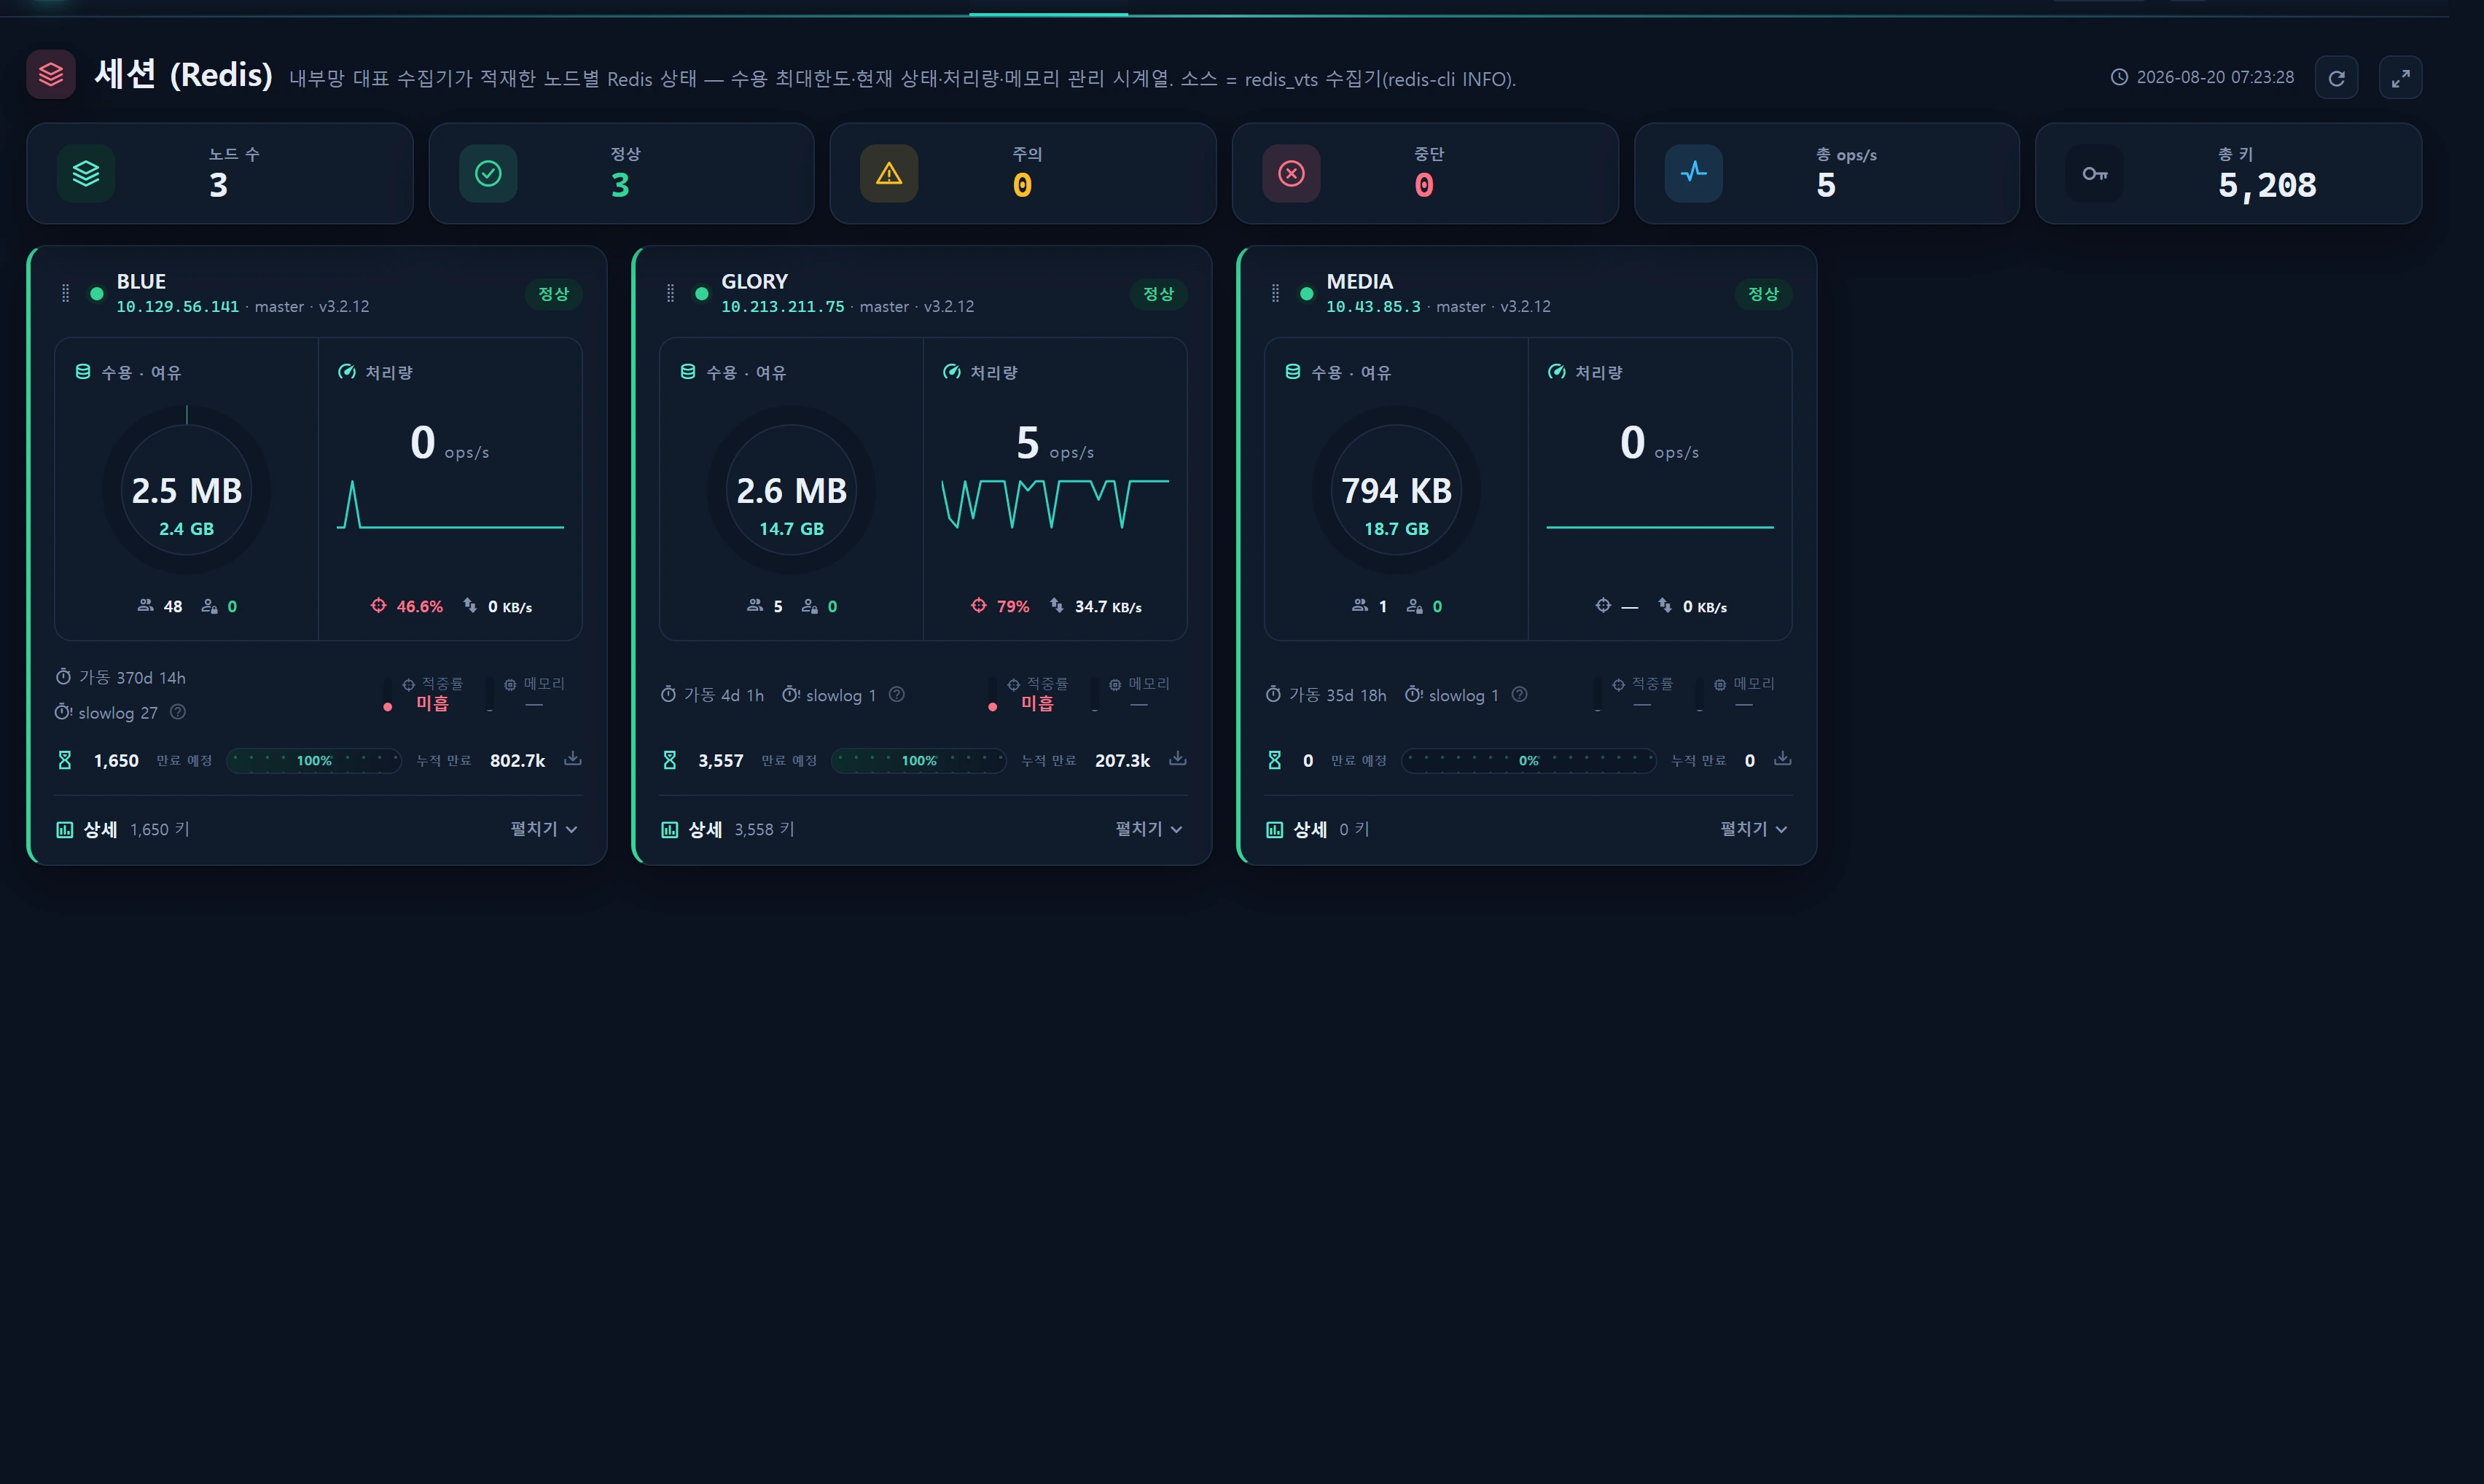
概述 —— 本页讲什么
本文讲解如何 解读并处置 您在 服务 ▸ 会话 (Redis) 页面(/service/session)上看到的指标。那个页面是实时监控控制台;本页解释其背后的 Redis 运维概念 —— slowlog、键空间命中率、内存碎片化,以及过期与逐出。
InfraGuard 从不直接连接 Redis。 内网代表采集器(scripts/infr_redis_vts_collector.cjs,以 pm2 每分钟 cron 方式运行)从各节点抓取一次 redis-cli INFO 快照,并写入中央 MySQL 表 infr_redis_metric;应用只 读取 该表。因此这里的每一个数值都来自标准的 INFO 字段。
每项指标的 确切术语与改进建议 以单一来源存放在会话页面的 教学浮层(悬停显示) 中(
resources/lang/{ko,en}/redis.php的edu.*)。本文是对这些概念的归纳与串联,而非重新定义 —— 完整细节请悬停查看实时浮层。
何时使用
- 某张会话卡片变为 降级 / 不可用,您想弄清原因代码(
mem_saturation、fragmentation、blocked_clients、replica_link_down、rdb_save_failed、stale)。 - 命中率看起来偏低 但节点似乎正常(判断这对会话存储是否属于正常现象)。
- 碎片化比率 升到 1.5 以上或跌到 1.0 以下,您想了解成因与对策。
- 逐出 开始超过 0 并持续上升,您担心会话丢失。
- slowlog 不断增长,您需要找出应当修复的命令模式。
页面布局
一张会话卡片代表一个节点(node_alias = infr_instance.alias,1:1),并沿用 服务 ▸ 数据库 的叙事方式。
| 区域 | 展示内容 | 来源 INFO 字段 |
|---|---|---|
| ① 容量 · 空闲 | 内存容量环(已用 / 上限)· 客户端(已连接/最大)· 阻塞中 | used_memory, maxmemory, total_system_memory, connected_clients, maxclients, blocked_clients |
| ② 吞吐 | ops/s 迷你图 · 近期窗口命中率 · 网络 I/O | instantaneous_ops_per_sec, keyspace_hits/misses, instantaneous_input/output_kbps |
| 底部效率 | 命中率评级 · 内存(碎片化)评级 | hit_rate, mem_fragmentation_ratio |
| 会话生命周期流 | 待过期(带 TTL)→ 流向 → 累计过期 | keyspace_expires, expired_keys |
| 详情(可折叠) | 内存管理时间序列 + 容量上限叠加线 + 逐出事件标记 · 键空间/会话分析 | used_memory 序列, evicted_keys, INFO keyspace |
顶部 KPI:节点数 · 正常/降级/不可用 · 总 ops/s · 总键数 · 客户端合计。
容量(上限)如何确定
环形仪表与内存图表的 100% 基准(预算)按以下顺序选取:
- 若已设置
maxmemory,它就是硬上限(由 Redis 强制执行)。估算空闲 =maxmemory − used。 - 若未设置(无限制),预算 =
total RAM − DB buffer pool − OS/other reserve (%)。预留默认为 20%(运维策略redis_reserve_pct);数据库缓冲池取自同一节点的access=database采集器并从中扣除。
maxmemory 0(无限制)的节点会显示“maxmemory 未设置 —— 按操作系统/服务器内存相对显示”的提示。对于专用的会话实例,请设置一个明确的maxmemory(取操作系统内存的一部分),使逐出策略的行为可预期。
使用方法
1) slowlog —— 它为何增长(7 种成因归纳)
Redis 是 单线程 的,因此一条慢命令会阻塞整台服务器。slowlog_len 是超过 slowlog-log-slower-than(默认 10ms)的命令累计计数。按常见程度排序:
- O(N) 命令 ——
KEYS *、SMEMBERS、HGETALL、LRANGE 0 -1会扫描整个集合。首要成因。 - 大键操作 —— 数 MB 的 String,或大型 Hash/Set/ZSet 的序列化 + 传输开销。
- 内存压力 / 交换 —— 已用量接近上限时,内存分配开始停顿。
- 持久化 fork 延迟 —— RDB
bgsave/ AOF 重写的latest_fork_usec。 - 繁重的 Lua/函数脚本 —— 繁重的
EVAL在执行期间持续阻塞。 - 大批量流水线 / MULTI —— 一次性数千条命令会让其余命令排队等待。
- 删除大键的 DEL —— 请用异步的
UNLINK代替DEL。
直接在节点上确认究竟触发了哪些命令:
# 最近 10 条慢命令(redis-cli)
redis-cli SLOWLOG GET 10
# 阈值 + 保留条数(微秒 · 例如 10ms)
redis-cli CONFIG SET slowlog-log-slower-than 10000
redis-cli CONFIG SET slowlog-max-len 128
redis-cli SLOWLOG RESET
切勿在生产环境执行
KEYS *—— 在它扫描整个键空间期间,其他所有命令都会等待。请改用游标迭代器SCAN/HSCAN/SSCAN/ZSCAN。
2) 键空间命中率 —— 低并不等于缺陷
近期窗口命中率 = Δkeyspace_hits / (Δhits + Δmisses)。当样本过少(差值分母 < 20)时,回退到自启动以来的 hit_rate。评级:优秀 ≥99% · 良好 ≥95% · 一般 ≥80%。
命中率并不是会把节点标红的状态维度。 会话存储天生命中率就低 —— 每次新登录、过期和登出都是一次未命中,因此 40–60% 属于正常(例如
blue的 44.75% 就是一个完全健康的会话节点)。正因如此,尽管存在redis_hit_rate_min阈值(默认 50),它 并不用于状态判定 —— 仅用于解读参考。真正的缓存问题,由下文与工作负载无关的内存饱和 / 逐出 / 碎片化来捕捉。
要真正提升命中率:让工作集常驻内存(预留 RAM/maxmemory 余量)、把 TTL 调到合适大小、缓解缓存击穿(给 TTL 加抖动),并对未命中较多的前缀做预热。详情请查看实时命中率浮层。
3) 内存碎片化 —— 健康区间 1.0 到 1.5
mem_fragmentation_ratio = used_memory_rss / used_memory —— 操作系统给 Redis 的物理内存与 Redis 实际使用量之比。
| 比率 | 含义 | 处置 |
|---|---|---|
| 1.0 – 1.5 | 健康区间 | 正常 |
| > 1.5 | 已碎片化(浪费内存) | activedefrag yes(需要 jemalloc),减少大值的频繁创建/删除 |
| < 1.0 | 正在交换(危险) | 立即 增加内存或调低 maxmemory 以停止交换 —— 这是性能骤降的信号 |
评级:优秀 0.95–1.4 · 良好 ~1.6 · 一般 ~2.5。状态阈值 redis_frag_ratio 默认为 1.6。
在
used_memory低于 64MB 的小实例上,固定开销会主导该比率,碎片化数值就成了误报。此时 InfraGuard 会 将碎片化排除在评分之外(frag_score = null)—— 数值仍会显示,但不会把节点标红。
4) 过期与逐出 —— 会话生命周期的核心
| 术语 | 含义 | 信号 |
|---|---|---|
| 过期(expired_keys) | TTL 到期后的自然移除 = 正常的会话生命周期 | 新陈代谢 · 通常正常 |
| 逐出(evicted_keys) | 达到 maxmemory 后按策略强制移除 |
内存压力 · 有会话丢失风险 |
在会话存储中,过期是正常的,但 逐出持续大于 0 意味着正在丢弃活跃会话。应对方式:
- 逐出速率 > 0 → 增加内存 / 调高
maxmemory。 - 检查策略:
allkeys-lru会连会话一起逐出;volatile-*只逐出带 TTL 的键。 - 若
rejected_connections同时上升,说明您同时触到了maxclients和内存上限。
# 查看 / 修改逐出策略
redis-cli CONFIG GET maxmemory-policy
redis-cli CONFIG SET maxmemory-policy volatile-lru
# 在线碎片整理(用于碎片化 > 1.5 · 需要 jemalloc)
redis-cli CONFIG SET activedefrag yes
详情中的 内存管理图表 会在 used_pct 上叠加一条 100% 容量上限线,并用 crit 标记标出 逐出事件 —— 于是您可以直观地追溯节点何时触顶并丢弃了会话。
5) 解读逻辑库(keyspace)
INFO keyspace 报告各个编号且彼此独立的键空间(逻辑库,默认 16 个,索引 0–15)的键数量。
# INFO keyspace example
db0:keys=48213,expires=48213,avg_ttl=1680000
db1:keys=126,expires=0,avg_ttl=0
键数最多的库就是主会话存储;如果该库的 keys = expires(全部带 TTL),那它就是纯粹的会话存储(键会自然失效)。在上例中,db0 可读作会话(全部带 TTL),db1 则是另一种用途(缓存/锁)。
数据来源
| 项目 | 值 |
|---|---|
| 来源表 | infr_redis_metric(中央 MySQL · 只读读取模型,$timestamps=false) |
| 供数采集器 | scripts/infr_redis_vts_collector.cjs(pm2,每分钟)—— redis-cli INFO |
| 建表方式 | 采集器通过 CREATE TABLE IF NOT EXISTS 自建(无迁移) |
| 关联键 | instance_id(整数外键优先)→ 回退到 node_alias ↔ infr_instance.alias |
| 构建器 | App\Services\Redis\RedisMetricService(单次批量查询 · 20 秒缓存) |
| 近期窗口 | 30 分钟(WINDOW_MIN)· 图表最多 60 个点 · 30 秒轮询(/service/session/live) |
| 阈值 SOT | App\Support\OpsPolicy::redisThresholds() |
状态阈值(运维策略 infr_setting group=ops):
| 键 | 默认值 | 判定 |
|---|---|---|
redis_mem_pct |
85 | 容量(%) ≥ → 降级(mem_saturation) |
redis_frag_ratio |
1.6 | 碎片化 ≥ → 降级(fragmentation,仅当 used ≥ 64MB 时) |
redis_blocked |
1 | 阻塞客户端数 ≥ → 降级(blocked_clients) |
redis_stale_min |
5 | 最后一次采样早于 N 分钟 → 不可用(stale) |
redis_hit_rate_min |
50 | 仅供显示/解读(不用于状态判定) |
redis_reserve_pct |
20 | 估算空闲时使用的操作系统/其他预留(%) |
master_link_status=down(副本链路断开)与rdb_last_bgsave_status=err(RDB 保存失败)同样会被判定为降级原因。分库的 keyspace 详情、total_system_memory以及键总数属于采集器扩展列 —— 在较旧的采集器上,这些区块会优雅地隐藏(“采集器重新部署后显示”)。
访问权限
- 查看(浏览会话页面):服务角色域
min_req 1—— 任何已登录用户(demo=1 及以上)。该页面 只读,因此没有写入门槛(既不直连 Redis,也不执行写命令)。 - 修改阈值:在 运维策略 中调整
redis_*值 —— 管理员level≥5(admin=10,由infr.level把关)。 - 注册采集器:向 redis_vts 采集器添加 redis_host 节点,在 采集器 中完成,需
level≥5。
疑难解答与常见问题
Q. 页面只显示“尚未采集到 Redis 节点”。
A. infr_redis_metric 为空。请在 管理 ▸ 采集器 中为 redis_vts 采集器注册 redis_host 节点,并在代表主机上以 pm2 部署 scripts/infr_redis_vts_collector.cjs。采集器会通过 CREATE TABLE IF NOT EXISTS 建表,并每分钟采集一次。
Q. 某节点一直处于不可用,原因是 stale。
A. 最后一次采样已早于 5 分钟(redis_stale_min)—— 可能是 pm2 采集器已停止(pm2 ls),或到该节点的网络/redis-cli 访问被阻断。请检查采集器日志。
Q. 键空间/会话分析与内存上限区块不见了。
A. total_system_memory、分库 keyspace 以及键总数列属于采集器扩展。在较旧的采集器上它们为 null,因此这些区块会隐藏 —— 重新部署最新采集器即可显示。
Q. 命中率只有 45%,为什么没有判定为降级? A. 这是设计使然。会话存储通常命中率就低,因此命中率永远不会把节点标记为降级。真正的问题(内存饱和、逐出、碎片化)由其他维度捕捉。
Q. 碎片化显示 3.0,但实例非常小。
A. 当 used_memory 低于 64MB 时,固定开销会扭曲该比率。此时 InfraGuard 会将碎片化排除在评分之外 —— 请把该数值当作参考信息。只要不是真正在交换(<1.0),基本无需担心。
相关内容
- 会话 (Redis) 页面 —— 应用这些概念的实时控制台
- 数据库负载监控 —— 采用同一叙事的数据库监控(连接数、QPS、慢查询)
- 数据库调优概念(教学) —— 数据库侧的锁、缓存与索引
- 运维策略 —— 修改
redis_*阈值与预留百分比 - 采集器 —— redis_vts 采集器与节点注册
- 服务概览 —— 把会话卡片编排到看板上