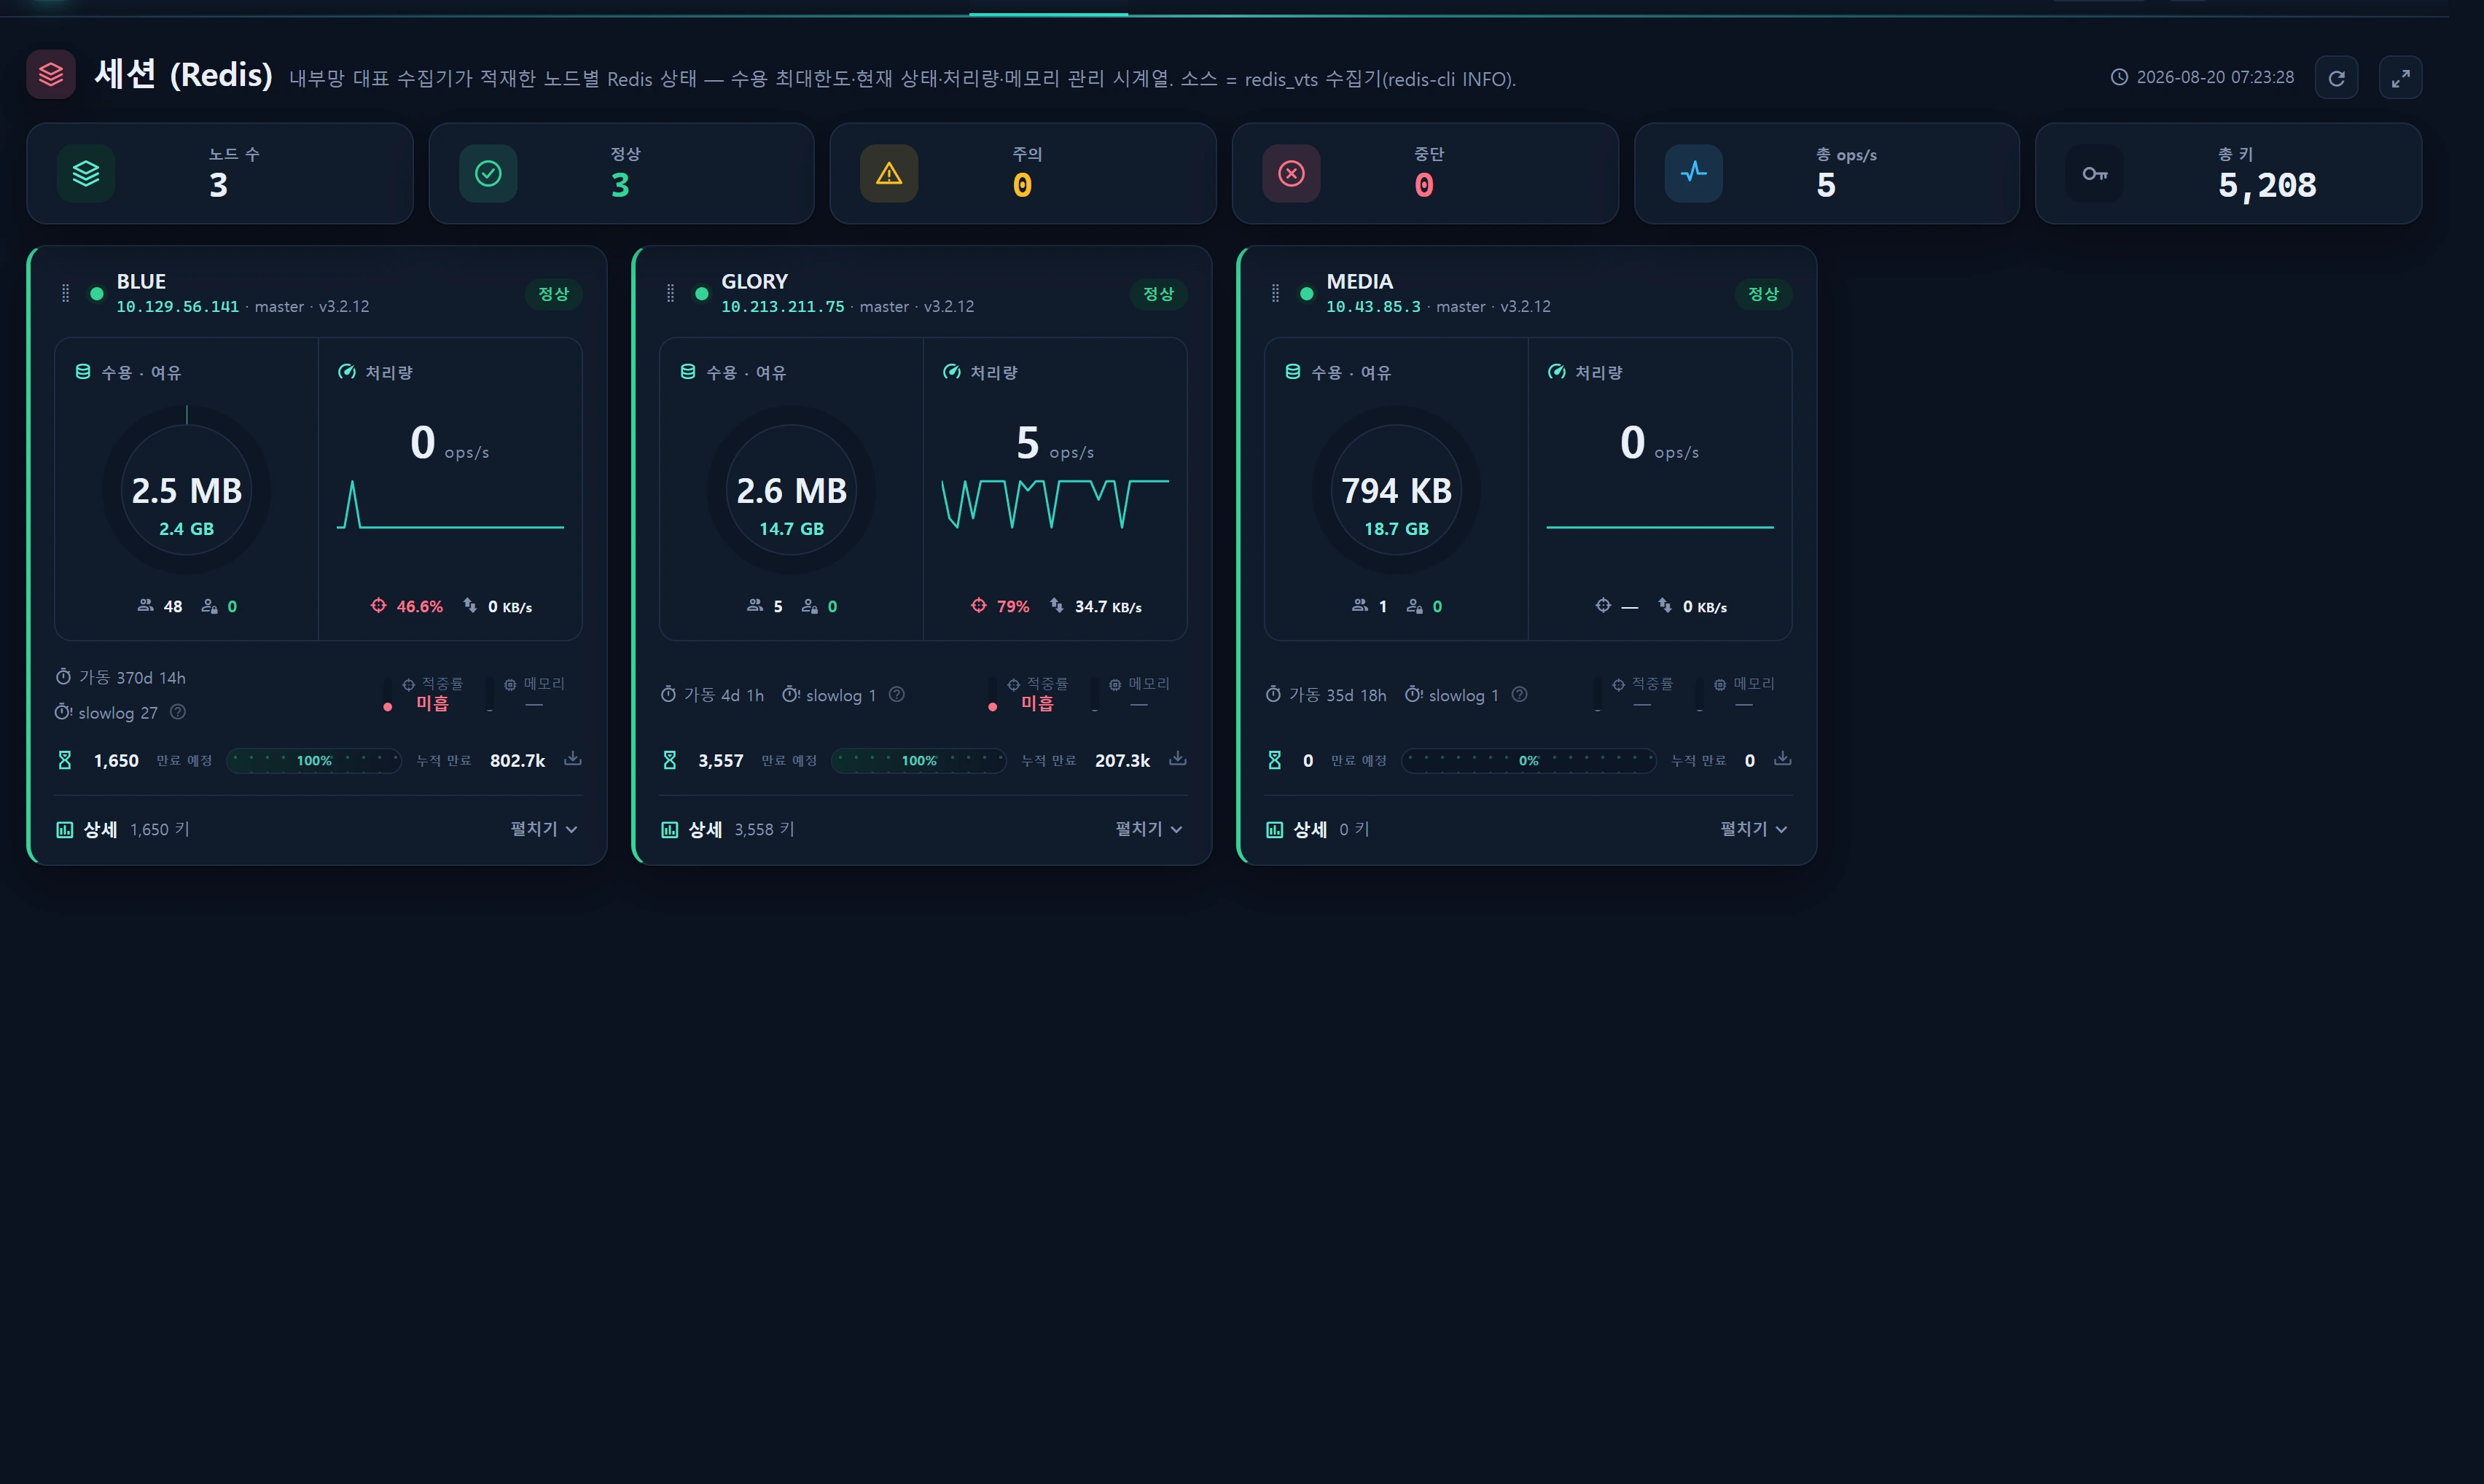
Resumen: qué hace esta pantalla
Servicio ▸ Sesiones (Redis) supervisa en una sola pantalla el estado del almacén de sesiones/caché de sus nodos Redis registrados. Traslada a Redis la narrativa de Servicio ▸ Base de datos, leyendo en torno a dos ejes:
- Techo de capacidad y estado actual: un indicador anular de saturación de memoria (
used_memory÷ techo de capacidad), las conexiones de cliente (connected / maxclients) y los clientes bloqueados. - Rendimiento: operaciones por segundo (
instantaneous_ops_per_sec), tasa de aciertos de la ventana reciente (Δhits / Δ(hits+misses)) y E/S de red (entrada/salida en kbps).
Un panel de detalle plegable añade una serie temporal de gestión de memoria (superposición del techo de capacidad y marcas de episodios de expulsión) y el análisis de espacio de claves/sesiones.
Esta pantalla nunca se conecta directamente a Redis. Un recolector representativo de la red interna (
scripts/infr_redis_vts_collector.cjs, un cron de pm2 que se ejecuta cada minuto) lanzaredis-cli INFOen cada nodo y carga las instantáneas en la tabla central de MySQLinfr_redis_metric; la aplicación solo la lee. La aplicación no guarda credenciales de Redis ni ejecuta ningún demonio de larga duración (así evita las trampas de las fugas de conexiones y de las credenciales incrustadas en el código).
Cuándo usarla
- Capacidad del almacén de sesiones: detecte cuándo la memoria de Redis se acerca al techo, punto en el que las sesiones son expulsadas (se pierden) bajo presión.
- Diagnóstico de eficiencia de la caché: juzgue si la caché cumple su función mediante la tasa de aciertos, la fragmentación y el slowlog.
- Saturación de conexiones: actúe antes de que se rechacen conexiones nuevas cuando
connected_clientsse aproxime amaxclientso cuando subarejected_connections. - Fallos de persistencia/replicación: vea como distintivos el fallo de bgsave de RDB, la reescritura de AOF o la caída del enlace con la réplica.
- Vida útil de la sesión: distinga la caducidad (vida útil normal) de la expulsión (presión de memoria) para interpretar la rotación de sesiones.
Disposición
KPI superiores
| KPI | Significado |
|---|---|
| Nodos | Tarjetas de nodo Redis con alguna muestra en la ventana reciente (30 min) |
| Activos / Degradados / Caídos | Recuento de nodos up / degraded / down |
| Ops/s totales | Suma de instantaneous_ops_per_sec entre todos los nodos |
| Claves totales | Suma de keyspace_keys entre todos los nodos |
Tarjetas de nodo (dos ejes)
Cada nodo es una tarjeta. La cabecera muestra el nombre/alias de la instancia, la versión de Redis y el rol (master/replica); el cuerpo contiene los dos ejes.
① Capacidad · Libre (indicador anular izquierdo): el valor central es used_pct (usado ÷ techo de capacidad). Franja de métricas:
| Métrica | Campo | Notas |
|---|---|---|
| Clientes | connected_clients / maxclients |
Conexiones frente al límite; cerca del límite se rechazan las conexiones nuevas |
| Bloqueados | blocked_clients |
Clientes a la espera en BLPOP·BRPOP·WAIT (0 es lo sano) |
② Rendimiento (derecha): minigráfico y franja:
| Métrica | Campo | Notas |
|---|---|---|
| ops/s | instantaneous_ops_per_sec |
Comandos procesados por segundo |
| Tasa de aciertos | Δhits / Δ(hits+misses) | Tasa de aciertos de caché de la ventana reciente (recurre al valor desde el arranque cuando hay pocas muestras) |
| E/S de red | instantaneous_input_kbps + output_kbps |
Entrada/salida de red por segundo |
Puntuaciones de eficiencia (pie de la tarjeta)
- Calificación de la tasa de aciertos: Excelente ≥99% · Bueno ≥95% · Aceptable ≥80%.
- Calificación de la eficiencia de memoria (fragmentación): Excelente 0,95–1,4 · Bueno ~1,6 · Aceptable ~2,5.
La puntuación de fragmentación (
frag_score) solo se calcula cuandoused_memoryalcanza al menos 64 MB. En instancias pequeñas, la sobrecarga fija del asignador domina la proporción y produce falsas alarmas, así que por debajo de ese umbral queda excluida tanto de la puntuación como del estado.
Franja de flujo de vida de la sesión
Una franja a todo el ancho del pie de la tarjeta dibuja con caducidad → flujo → caducadas acumuladas. A la izquierda, las claves que ahora mismo tienen un TTL vivo (keyspace_expires, a punto de caducar de forma natural); a la derecha, las claves caducadas desde el arranque (expired_keys, la rotación de sesiones). Un relleno cercano a ≈100% indica un almacén de sesiones puro.
Detalle (desplegable)
Se abren dos bloques de forma plegable (la disposición de tipo masonry se recompone al cambiar la altura).
- Gestión de memoria: serie temporal de
usedfrente a la capacidad, más una superposición de la línea de corte del 100% del techo de capacidad y marcas críticas de episodios de expulsión. La tarjeta enumera el techo de capacidad (cap), el espacio libre estimado (est_free), la RAM total, la reserva de la base de datos, la reserva del sistema operativo, el pico, el RSS, la fragmentación, las expulsiones/caducidades acumuladas y la política de expulsión. - Espacio de claves · sesiones: claves totales, claves con TTL, barras de distribución por base de datos lógica (db0/db1…), la base de datos de sesiones resaltada, el TTL medio y los distintivos de persistencia RDB/AOF/réplica.
Ventanas emergentes didácticas (edu)
Al pasar el ratón por el icono junto a una métrica se abre una ventana emergente diseñada para explicar causas y remedios (los conceptos más profundos están en Ajuste de Redis explicado):
| Ventana emergente | Contenido |
|---|---|
| SLOWLOG | 7 causas de acumulación de comandos lentos (comandos O(N) · claves grandes · presión de memoria · bloqueos por fork · Lua · canalizaciones · DEL masivos) |
| Tasa de aciertos | Base del ratio de aciertos del keyspace y cómo elevarlo (mantener residente el conjunto de trabajo · ajustar el TTL · mitigar las estampidas) |
| Fragmentación | Banda sana de RSS / used (1,0–1,5) · activedefrag · aviso de intercambio (<1,0) |
| Bases de datos lógicas | Concepto de las bases de datos numeradas de Redis (0–15) · separación por finalidad · portabilidad a Cluster |
| Caducidad · expulsión | Caducidad (vida útil normal) frente a expulsión (presión de memoria) · cómo interpretarlas |
Cómo usarla
- Sondeo: tras la carga, la página consulta
/service/session/livecada 30 segundos para refrescar los KPI y las tarjetas (el servidor cachea el panel durante 20 segundos). - Reordenar tarjetas: arrastre las tarjetas para ordenarlas por prioridad (SortableJS; el orden se conserva en localStorage).
- Desplegar el detalle: use el botón [Desplegar] de la tarjeta para abrir los bloques de gestión de memoria y de espacio de claves.
- Aprender con edu: pase el ratón por el icono de una métrica para ver la ventana emergente de causa/remedio.
- Pantalla completa: el botón de pantalla completa junto al indicador LIVE de la cabecera oculta la navegación superior y cambia a modo panel (ESC para salir).
Si no aparece ninguna tarjeta, todavía no se ha registrado ni recolectado ningún nodo Redis. En Administración ▸ Recolectores, registre los nodos
redis_hosten el recolectorredis_vtsy despliegue el recolector con pm2 en el host representativo.
Fuentes de datos
Modelo de solo lectura infr_redis_metric
La aplicación mapea esta tabla como un modelo de solo lectura al estilo Legacy (App\Models\Infr\InfrRedisMetric, $timestamps=false). Deliberadamente no existe ninguna migración para ella: el recolector la autoaprovisiona con CREATE TABLE IF NOT EXISTS, de modo que un Schema::create del lado de la aplicación entraría en conflicto.
Disciplina del constructor App\Services\Redis\RedisMetricService::dashboard():
- Consulta la ventana reciente de 30 minutos (
WINDOW_MIN) en una única consulta por lotes y luego agrupa pornode_alias(una tarjeta por nodo). Si la ventana no tiene muestras (la recolección se detuvo), recupera al menos las últimas 180 filas para exponer los nodos comostale. - Las series temporales se truncan a los últimos 60 puntos por tarjeta (
SERIES_MAX). Los contadores acumulados (evicted/expired) se convierten en tasas mediante diferencias entre muestras adyacentes; ante un reinicio (una disminución) la tasa esnull. - El resultado del panel se cachea durante 20 segundos (
infr:redism:dash:v1).
-- Conceptual (en realidad es Eloquent). Recupera la ventana reciente por lotes y agrupa en PHP.
SELECT * FROM infr_redis_metric
 WHERE sampled_at >= (NOW() - INTERVAL 30 MINUTE)
 ORDER BY sampled_at;
Recolector: scripts/infr_redis_vts_collector.cjs
Un único host representativo de la red interna se ejecuta mediante un cron de pm2, recorre en cada pasada el Redis de varios nodos (redis-cli -h {ip} INFO) y el vts de nginx, carga los datos directamente en el MySQL central y después termina (no es residente → un proceso nuevo por ejecución, sin fugas). La configuración vive únicamente en el bloque CONFIG al principio del archivo (sin variables de entorno ni credenciales incrustadas).
# Despliegue en el host representativo (barrido cada minuto, no residente)
npm i mysql2                 # la única dependencia npm (para la carga). Instale redis-cli con el paquete del sistema operativo.
pm2 start infr_redis_vts_collector.cjs --name infr-collector \
  --no-autorestart --cron-restart "* * * * *"
pm2 save
Unión con la instancia (alias / clave foránea entera)
Al escribir, el recolector busca el alias de nodo → id en infr_instance y escribe directamente un instance_id (entero). La aplicación une principalmente por metric.instance_id = infr_instance.id (comparación de enteros: independiente de la intercalación e indexada por clave primaria). Las instancias no registradas o registradas más tarde recurren a node_alias (en minúsculas) → infr_instance.alias, y el relleno posterior de infr:link-metrics (con control de líder, cada 5 minutos) completa después el instance_id.
Cálculo del techo de capacidad (cap)
La referencia del 100% del indicador anular y del gráfico de memoria se resuelve en este orden.
| Tipo de cap | Condición | Techo | Espacio libre estimado (est_free) |
|---|---|---|---|
maxmemory |
maxmemory > 0 |
El valor configurado de maxmemory (techo duro) | maxmemory − used |
budget |
maxmemory sin definir | RAM total − buffer pool de la base de datos − reserva del sistema operativo | budget − used |
- RAM total =
total_system_memory(recolectado), con recurso ainfr_instance.mem_mb. - Reserva del sistema operativo = RAM total ×
redis_reserve_pct(20% por defecto). - Buffer pool de la base de datos = el
infr_db_metric.raw.bp_sizemás reciente del recolectoraccess=databasede ese mismo nodo (sumado si el nodo aloja varias bases de datos). Restarlo da el presupuesto que Redis puede usar de forma realista como techo. - El presupuesto tiene un suelo para que nunca caiga por debajo del
usedactual, lo que evita valores negativos o invertidos.
Determinación del estado y umbrales
statusOf() clasifica cada nodo como up / degraded / down.
| Estado | Condición |
|---|---|
down |
La recolección falló (ok=0) o está stale (última muestra más antigua que redis_stale_min) |
degraded |
Se cumple uno o varios de los motivos siguientes |
up |
Ningún motivo |
Motivos y umbrales de degraded (Administración ▸ Política de operaciones, infr_setting group=ops):
| Motivo | Condición | Clave del umbral | Valor por defecto |
|---|---|---|---|
| Saturación de memoria | used_pct ≥ |
redis_mem_pct |
85 |
| Fragmentación | frag_score ≥ |
redis_frag_ratio |
1.6 |
| Clientes bloqueados | blocked_clients ≥ |
redis_blocked |
1 |
| Enlace con la réplica caído | master_link_status = down |
— | — |
| Fallo al guardar el RDB | rdb_last_bgsave_status = err |
— | — |
La tasa de aciertos NO es un eje de estado. Un almacén de sesiones falla en cada inicio de sesión nuevo, en cada caducidad y en cada cierre de sesión, así que una tasa de aciertos del 40–60% es normal (por ejemplo, 44,75% en un nodo de sesiones perfectamente sano). Antes, una tasa de aciertos por debajo de
redis_hit_rate_min(50 por defecto) generaba undegradedrojo erróneo; ahora la tasa de aciertos solo se muestra en el KPI de la tarjeta, en el indicador de calificación y en la ventana emergente edu, y nunca tiñe un nodo de rojo. Los problemas reales de caché (saturación de memoria, expulsión, fragmentación) los detectanmem_saturation/fragmentationsea cual sea la carga de trabajo.
Acceso
- Lectura (esta pantalla):
user_level ≥ 1(demo=1). El área de rol Servicio tiene un nivel mínimo de 1 y esta pantalla es de solo lectura (sin acciones de escritura ni de borrado). - Registro/edición de recolectores: Administración ▸ Recolectores exige
user_level ≥ 5(staff/admin) para registrar nodosredis_hosty contraseñas en el recolectorredis_vts. - Cambios de umbrales: Administración ▸ Política de operaciones exige
user_level ≥ 5.
Esta pantalla no tiene ninguna acción destructiva, por lo que no escribe un registro de auditoría propio (los cambios de recolectores y de política se auditan en sus respectivas pantallas de administración).
Resolución de problemas y preguntas frecuentes
No aparece ninguna tarjeta («No se ha recolectado ningún nodo Redis»)
infr_redis_metric no tiene muestras recientes. Compruebe que (1) registró nodos redis_host en el recolector redis_vts en Administración ▸ Recolectores, (2) infr_redis_vts_collector.cjs está en marcha bajo pm2 en el host representativo y (3) el host representativo puede alcanzar el puerto de Redis de cada nodo mediante redis-cli.
Un nodo aparece como «Caído (stale)»
La última muestra es más antigua que redis_stale_min (5 min por defecto). Lo más probable es que el proceso pm2 del recolector representativo haya muerto o que su cron se haya detenido. Revíselo con pm2 list / pm2 logs infr-collector.
El techo del indicador anular parece incorrecto o el espacio libre resulta enorme
Los nodos sin maxmemory usan un presupuesto como techo (RAM total − buffer pool de la base de datos − 20% de reserva del sistema operativo). Si desea un techo duro, defina maxmemory en Redis: ese valor pasa entonces a ser directamente el techo.
El bloque de espacio de claves/sesiones está vacío
El detalle por base de datos (raw.keyspace) y las métricas de la base de datos de sesiones los rellena el recolector extendido. Con un recolector antiguo, vuelva a desplegarlo (lo que añade de forma idempotente total_system_memory, keyspace_keys y las columnas raw por base de datos) y aparecerá. Si no se ha recolectado, la sección se oculta sin más.
La tasa de aciertos es baja, ¿es un problema?
Para una carga de trabajo de sesiones, no (vea el aviso anterior). Si se trata de una caché pura y la tasa de aciertos es baja, puede que el conjunto de trabajo no sea residente o que el TTL sea demasiado corto: consulte el apartado sobre la tasa de aciertos en Ajuste de Redis explicado.
No se muestra la puntuación de fragmentación
Cuando used_memory está por debajo de 64 MB, la proporción de fragmentación queda dominada por la sobrecarga fija y carece de sentido, así que se excluye de la puntuación y del estado.
Relacionado
- Base de datos (Servicio ▸ Base de datos): la pantalla hermana que implementa la misma narrativa (capacidad · rendimiento · esquema) para MySQL
- Ajuste de Redis explicado: profundización en el slowlog, la tasa de aciertos, la fragmentación, el espacio de claves y la expulsión
- Recolectores (Administración ▸ Recolectores): registre el recolector
redis_vtsy sus nodos - Política de operaciones (Administración ▸ Política de operaciones): defina los umbrales de estado de Redis y el porcentaje de reserva
- Resumen de servicio (Servicio ▸ Resumen): fije tarjetas de sesión en el panel de prioridades